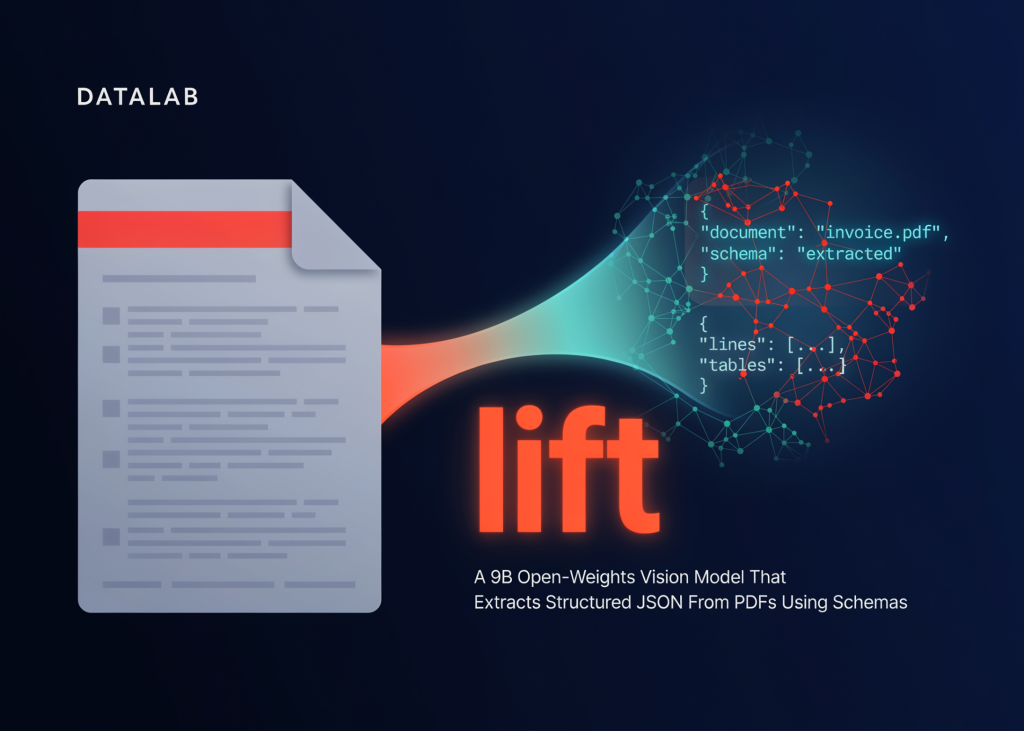
Datalab lift가 PDF를 읽어 JSON 스키마대로 구조화된 데이터를 뽑아내는 모습

Datalab lift 공개 — PDF에서 JSON 스키마대로 뽑아내는 9B 오픈 비전 모델

개요 PDF에서 값을 뽑아 데이터베이스에 넣는 일은 늘 골치였습니다. 정규식으로 막아 보고, 멀티모달 LLM에 통째로 던져 보고, 결국 사람이 다시 한 번 확인하는 식이었습니다. Datalab이 6월 23일 공개한 lift는 이 흐름을 바꾸려는 시도입니다. 9B 파라미터짜리 오픈웨이트 비전 모델이고, JSON 스키마를 그대로 입력으로 받습니다. 출력은 그 스키마에 맞는 JSON입니다. 형식이 어긋날 수 없는 이유는 디코딩 단계에서 스키마를 깨는 토큰을 아예 못 고르도록 막아 두기 때문입니다. ...
2026년 6월 24일 · 4 분 · 737 단어 · TechLLM
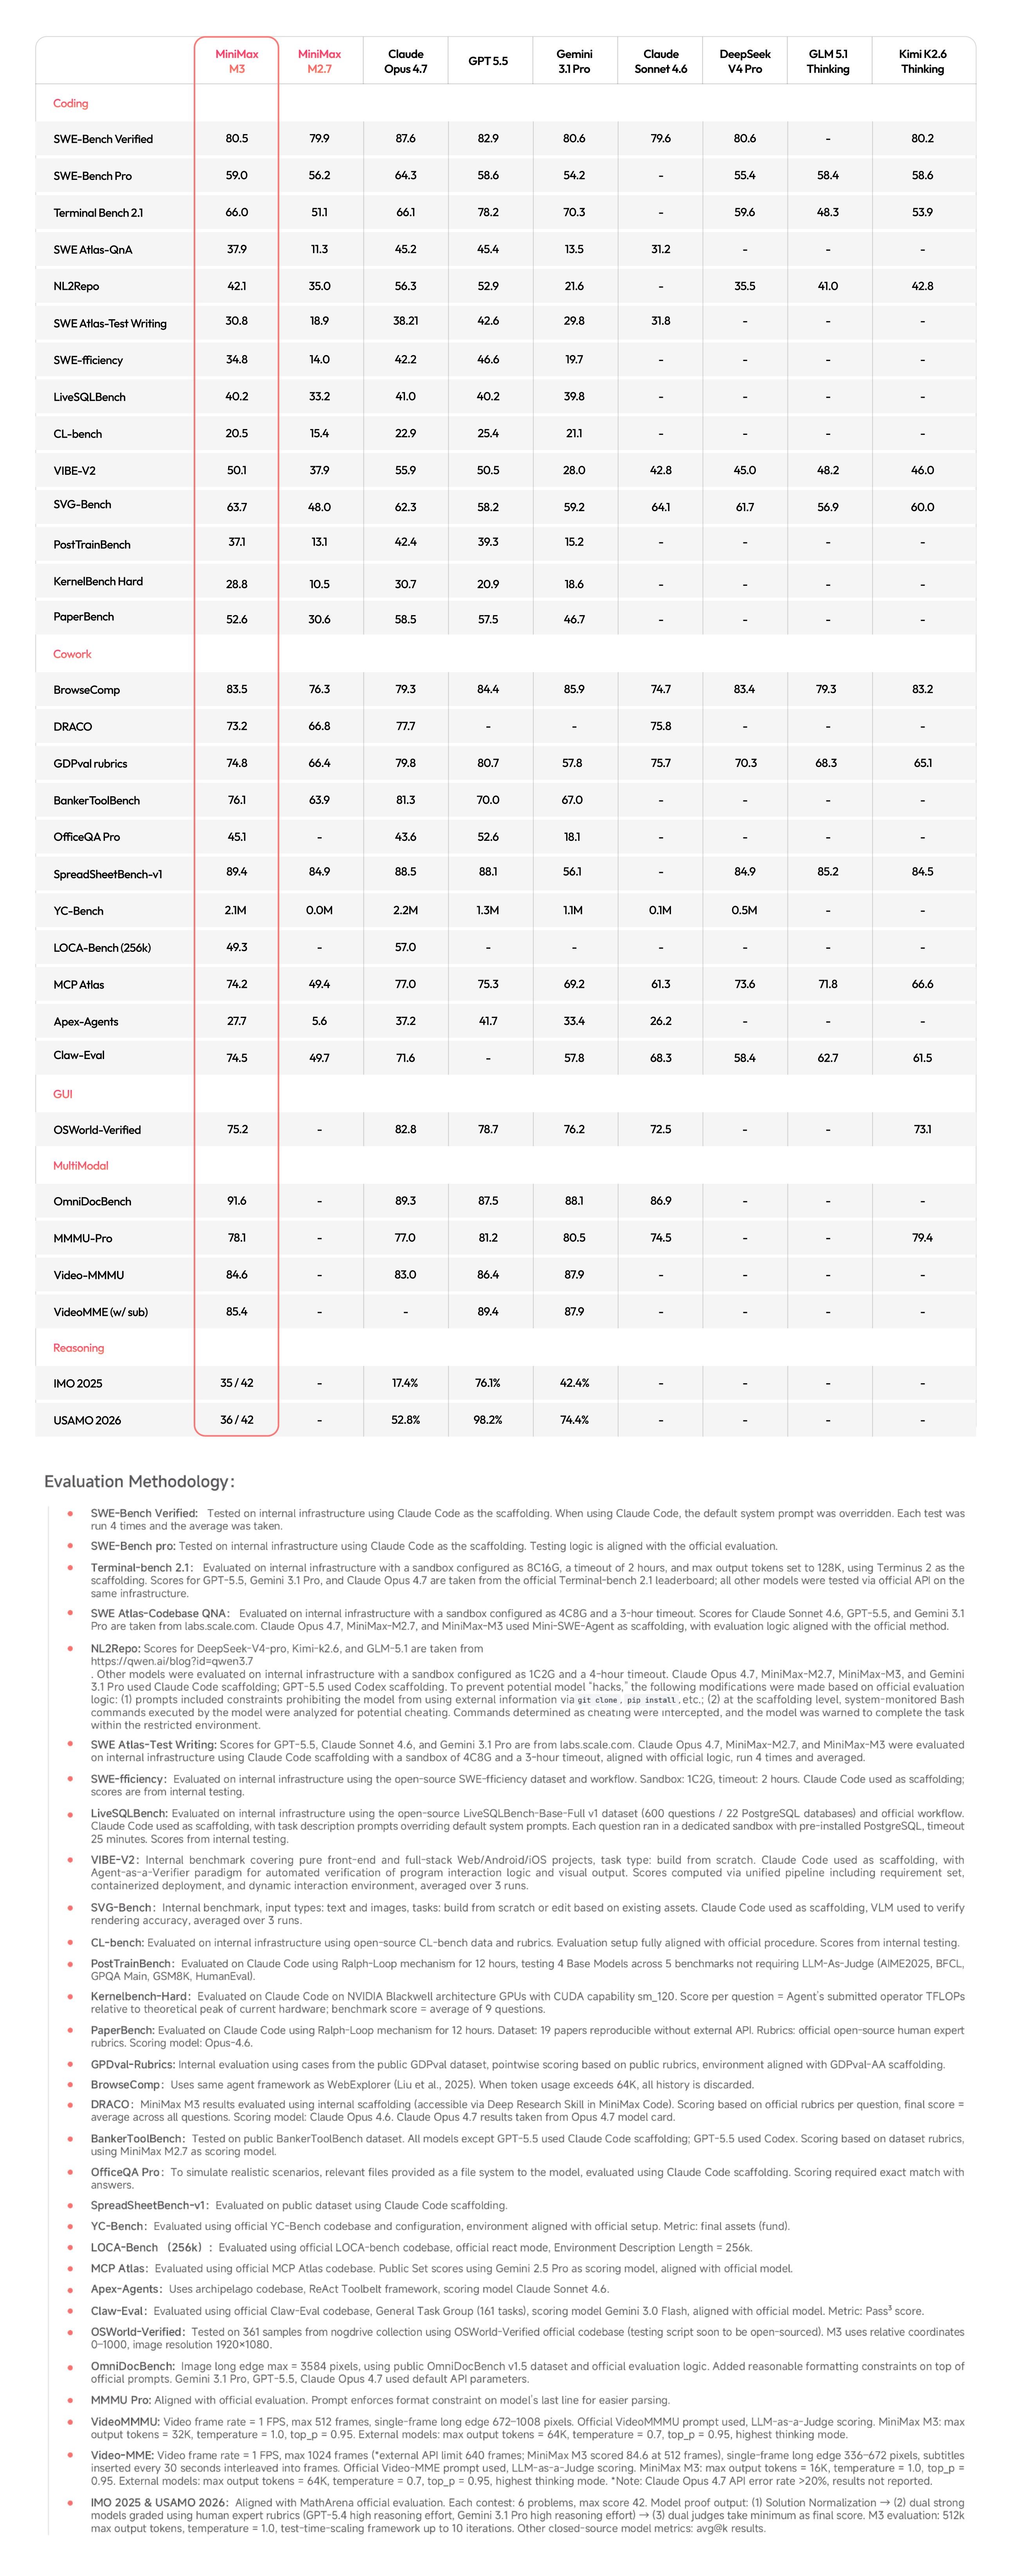
MiniMax-M3 벤치마크 비교 — HuggingFace 모델 카드 공식 이미지

MiniMax-M3 로컬 배포 실전: vLLM·SGLang·Docker로 428B MoE 돌리기

개요 MiniMax가 HuggingFace에 M3 모델 카드를 올렸습니다. 발표 글만 보고 “오, 좋네” 하고 끝낼 수도 있지만, 진짜 궁금한 건 따로 있습니다. 실제로 어떻게 돌리지? 이 글은 모델 카드에 나와 있는 vLLM, SGLang, Transformers, Docker 실행법을 한국 개발자 입장에서 정리한 실전 메모입니다. ...

2026년 6월 13일 · 4 분 · 719 단어 · TechLLM
DeepSeek V4 추론 성능 비교 차트

DeepSeek V4 출시 43일, 추론 최적화 전쟁의 실제 성적표

DeepSeek V4 1.6T가 공개된 지 43일이 지났습니다. SemiAnalysis가 이 기간 동안 NVIDIA, AMD, 화웨이 진영의 추론 스택이 어떻게 진화했는지 추적한 보고서를 내놓았는데, 숫자가 흥미롭습니다. 같은 모델, 같은 하드웨어인데 26일 만에 처리량이 100배 늘어난 경우도 있었습니다. 오늘은 그 보고서를 한국어로 정리합니다. ...

2026년 6월 10일 · 5 분 · 1018 단어 · TechLLM
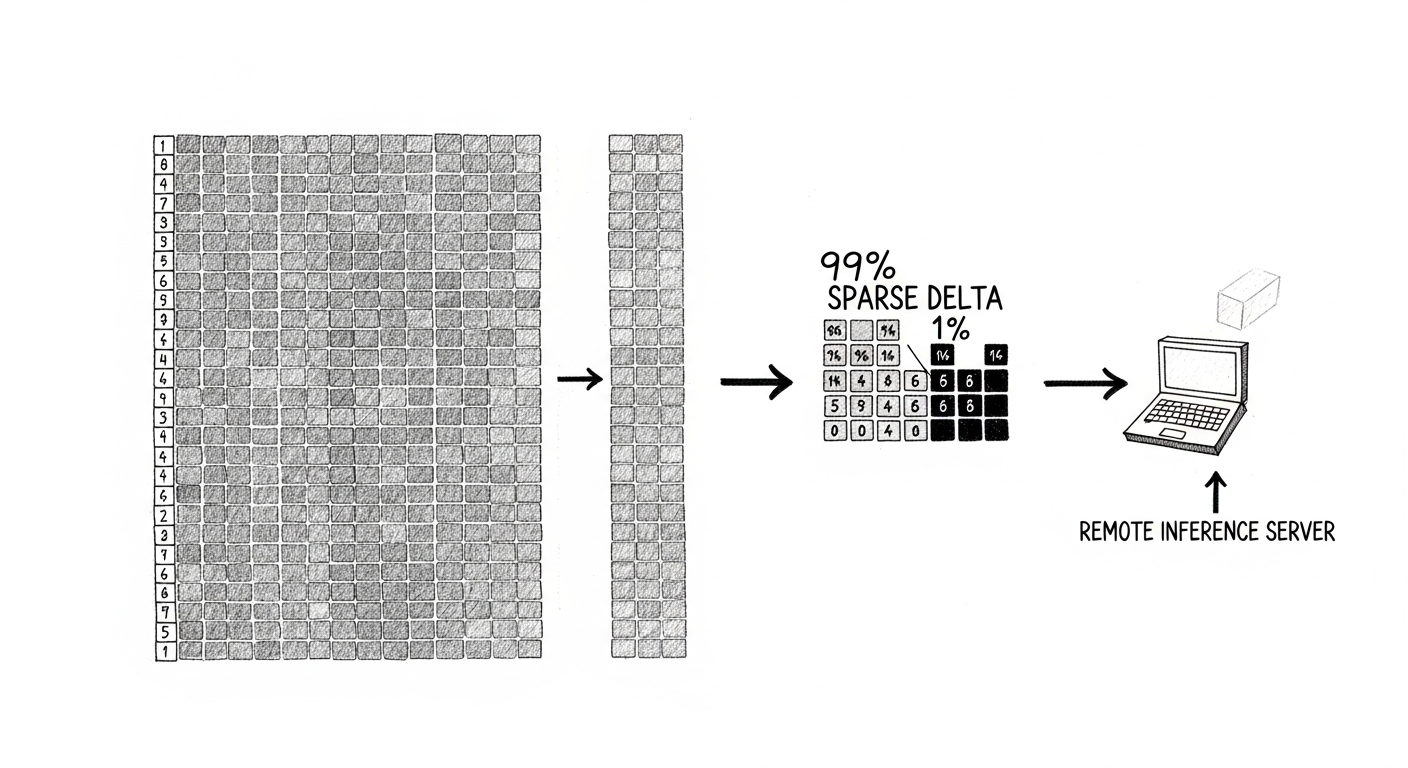
모델 가중치 변화를 희소 벡터로 인코딩해 전송하는 과정을 표현한 핸드드로잉 일러스트

Delta Weight Sync — 1TB 모델도 초당 동기화하는 비동기 RL 트릭

개요 비동기 강화학습(Async RL)에는 근본적인 문제가 있다. 매 최적화 단계마다 업데이트된 모델 가중치를 추론 엔진으로 전송해야 한다. 7B 모델이면 단계당 14GB, 1T 파라미터 모델이면 매 단계 1TB다. 비현실적이다. HuggingFace TRL 팀이 이 문제를 수학적으로 풀었다. BF16 가중치의 99% 이상은 한 옵티마이저 단계에서 실제로 변하지 않는다. 변경된 부분만 희소(sparse) 인코딩으로 전송하면 1.2GB → 20~35MB가 된다. ...

2026년 5월 27일 · 4 분 · 668 단어 · TechLLM