여러 검색 모델을 비교할 때, 각 모델이 가져온 문서를 합쳐 한 번만 채점하고 그 점수를 계속 재사용해서 평가 비용을 크게 줄이는 방법이다.

여러 검색 모델을 비교할 때, 각 모델이 가져온 문서를 합쳐 한 번만 채점하고 그 점수를 계속 재사용해서 평가 비용을 크게 줄이는 방법이다. 무엇이 문제였나 — 새 임베딩 모델이 나올 때마다 검색 품질을 다시 측정하려면 사람이 문서 수만 개를 새로 채점해야 해서 비용이 막대했다. 어떻게 풀었나 — 모든 후보 모델이 가져온 문서의 합집합을 LLM 심사위원이 한 번만 채점하고, 새 모델이 추가될 때는 그 모델이 새로 가져온 문서만 추가로 채점한다. 그래서 뭐가 좋아졌나 — 그 결과 4.9배 비용 절감, 65–80% 재사용률, 인간 채점과 거의 같은 순위(상관 0.69–0.95)를 production에서 확인했다. ...
2026년 10월 1일 · 6 분 · 1232 단어 · TechLLM

AI가 논문에 인용을 붙일 때, 단어가 비슷한 논문이 아니라 그 문장을 실제로 뒷받침하는 논문을 고르게 만든 연구다.

AI가 논문에 인용을 붙일 때, 단어가 비슷한 논문이 아니라 그 문장을 실제로 뒷받침하는 논문을 고르게 만든 연구다. 무엇이 문제였나 — 문제: 기존 인용 추천은 실제 존재하는 논문을 가져오더라도, 그 논문이 문장의 주장을 제대로 뒷받침하지 못하는 경우가 많았다. 어떻게 풀었나 — 해결: ReCite는 먼저 인용이 필요한 위치를 찾고, 왜 인용이 필요한지 파악한 뒤, 후보 논문이 그 주장과 논리적으로 맞는지 확인한다. 맞지 않으면 검색어를 고쳐 다시 찾는다. 그래서 뭐가 좋아졌나 — 효과: 4B 규모 모델로 strict F1 39.15%, lenient F1 55.14%를 기록해 훨씬 큰 생성 모델과 일반 에이전트보다 좋은 인용 정확도를 보였다. ...

2026년 9월 20일 · 5 분 · 1004 단어 · TechLLM
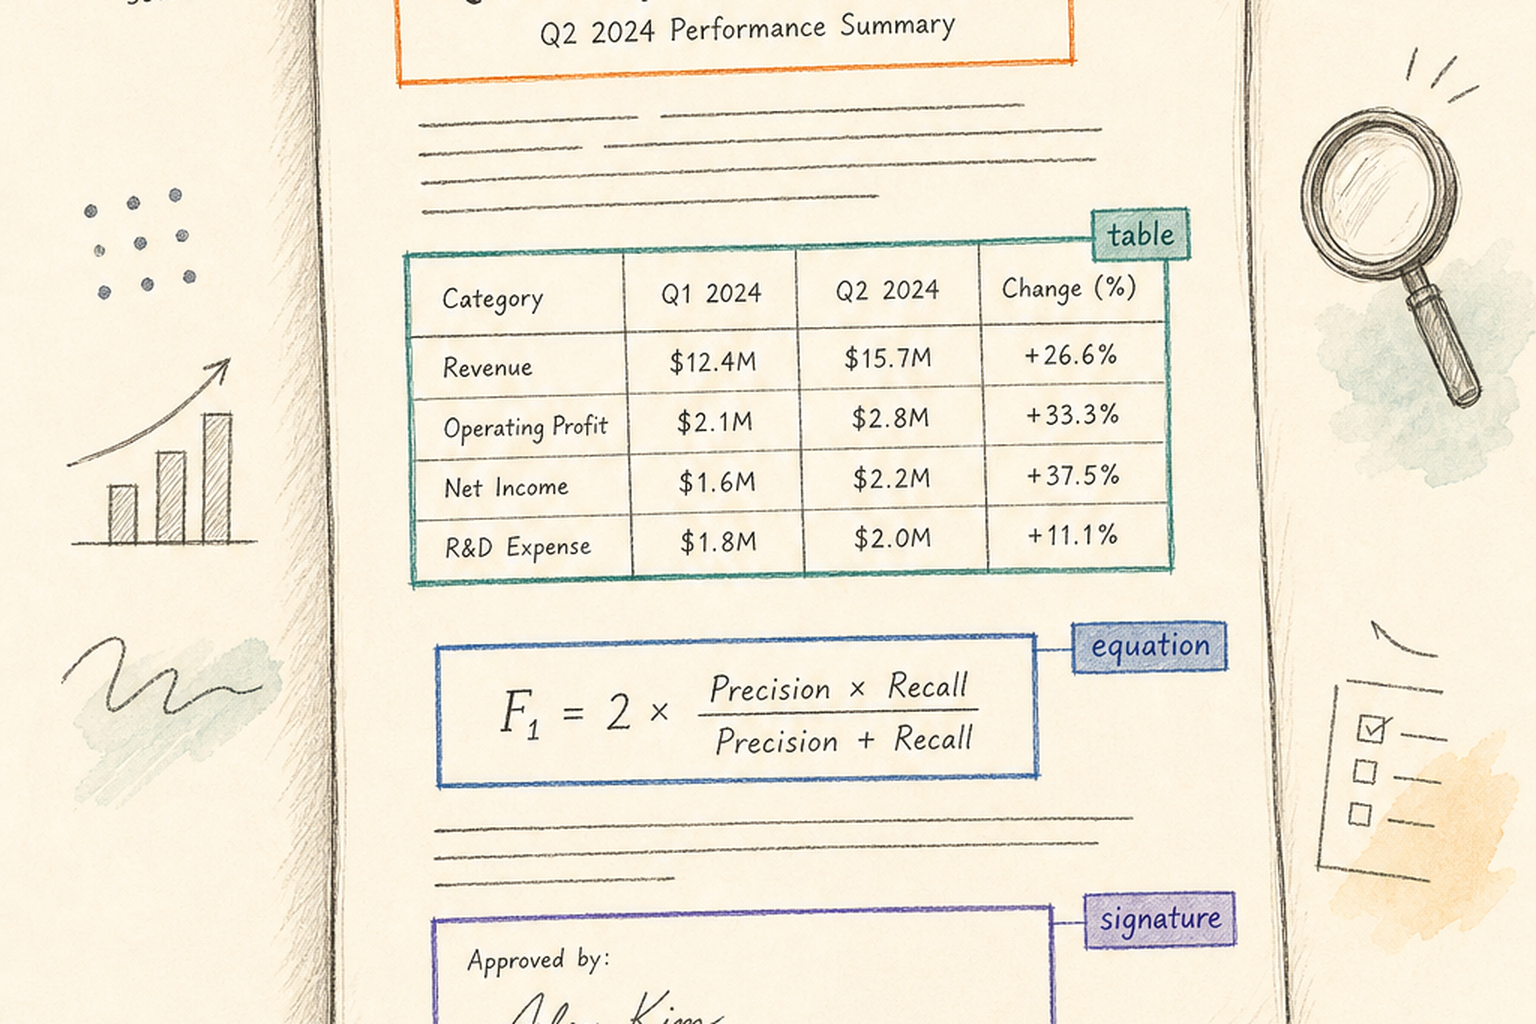
Mistral OCR 4가 문서를 스캔하면서 바운딩 박스와 블록 분류, 신뢰도를 함께 출력하는 모습

Mistral OCR 4: 위치·블록·신뢰도까지 같이 주는 OCR — RAG와 에이전트 파이프라인을 위한 인용 가능 구조화 출력

개요 문서에서 글자만 뽑아 주던 시대는 끝나가는 것 같습니다. Mistral이 6월 23일 공개한 OCR 4는 한 문서를 통째로 “구조"로 돌려줍니다. 어디에 무엇이 있고(바운딩 박스), 그 덩어리는 어떤 종류이며(제목·문단·표·수식·서명·그림), 모델이 얼마나 확신하는지(페이지·단어별 신뢰도)까지 같이 나옵니다. 그냥 보기 좋은 결과물이 아니라, RAG에 그대로 넣어도 인용이 되는 입력을 만들겠다는 설계입니다. ...

2026년 6월 24일 · 6 분 · 1112 단어 · TechLLM
에이전트 메모리 일곱 층을 표현한 일러스트

AI 에이전트 메모리의 7가지 유형: 엔지니어를 위한 기술 가이드

출처: Asif Razzaq / Marktechpost 문서유형: 번역·해설 #AIAgent #AgentMemory #LLM #RAG #VectorDB 개요 LLM은 본래 기억이 없습니다. API 호출 한 번이 끝나면 직전 메시지를 모두 잊어버리죠. 단일 질문에는 문제가 없지만, 에이전트를 만드는 순간 이 한계가 곧바로 드러납니다. 에이전트는 여러 단계에 걸쳐 계획을 세우고 도구를 호출하면서 일을 끝내야 하니까요. 그 차이를 메우는 것이 메모리 시스템입니다. Marktechpost의 Asif Razzaq는 에이전트 메모리를 시간축(단기·장기) 과 형태(파라메트릭·비파라메트릭) 두 축으로 나누고, 실제 구현에서 자주 쓰이는 일곱 가지 유형을 정리했습니다. ...

2026년 6월 22일 · 5 분 · 960 단어 · TechLLM

ColPali: PDF 문서 검색을 텍스트 파싱 없이 — 페이지 이미지 임베딩으로 RAG를 바꾼다

개요 PDF 문서를 RAG에 활용하려면 OCR, 레이아웃 파싱, 텍스트 청킹, 임베딩까지 복잡한 파이프라인이 필요하다. 이 과정에서 오류가 누적되고, 표·그래프·인포그래픽 같은 시각적 정보는 제대로 처리되지 않는다. ColPali는 이 문제를 다르게 접근한다. PDF 페이지를 이미지 그대로 Vision LLM에 넣어 임베딩한다. ...

2026년 5월 31일 · 3 분 · 510 단어 · TechLLM
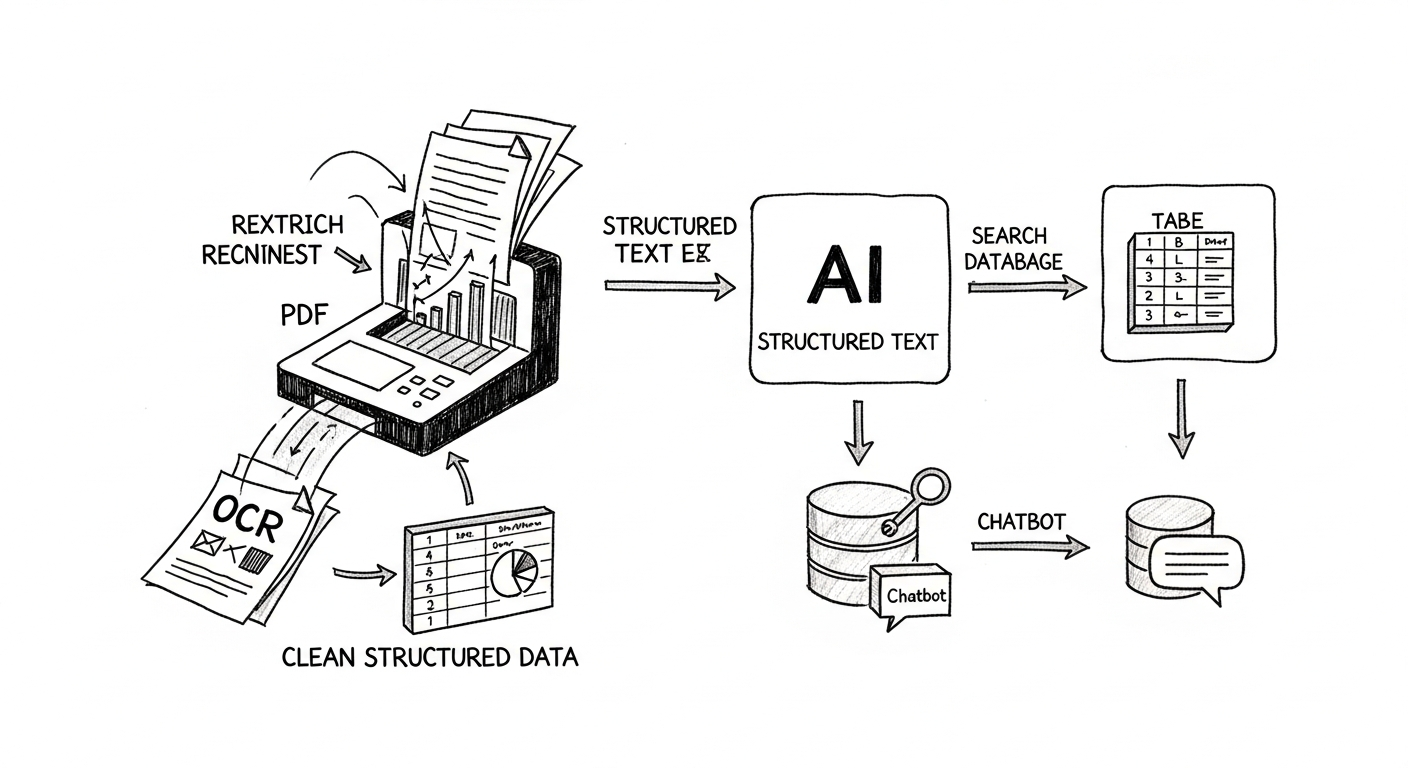
문서에서 텍스트를 추출해 AI 파이프라인으로 연결하는 핸드드로잉 스타일 일러스트

PaddleOCR 3.5 — Transformers 백엔드로 문서 AI 파이프라인을 통합한다

개요 PaddleOCR 3.5가 Hugging Face Transformers를 추론 백엔드로 공식 지원한다. engine="transformers" 파라미터 하나로 기존 PyTorch/Transformers 스택에 OCR과 문서 파싱 기능을 통합할 수 있다. PDF, 스캔 문서, 테이블, 차트 등 복잡한 레이아웃도 처리 가능하다. RAG 파이프라인이나 Document AI 워크플로우에서 문서 수집 품질을 높이려는 팀에게 실용적인 업데이트다. ...

2026년 5월 27일 · 3 분 · 486 단어 · TechLLM
ARIS - Agentic and Relationship Intelligence System for Social Robots

로봇이 인간관계를 이해하는 시대 — ARIS: Social Robots를 위한 관계 지능 시스템

로봇이 내 대화를 듣고, 내가 누구와 무슨 관계인지 기억하고, 그걸 바탕으로 더 자연스럽게 대화하는 시대다. Monash University 연구팀이 그걸 실제로 만들어냈다. 이름하여 ARIS — Agentic and Relationship Intelligence System. 소셜 로봇을 위한 관계 지능 프레임워크다. ...

2026년 5월 17일 · 2 분 · 426 단어 · TechLLM
Granite Embedding Multilingual R2 다국어 임베딩 모델

Granite Embedding Multilingual R2 — 97M으로 sub-100M SOTA, 32K 컨텍스트

개요 IBM이 Granite Embedding Multilingual R2를 Apache 2.0으로 공개했다. 97M과 311M 두 모델이다. 97M 모델은 MTEB 다국어 검색 벤치마크에서 60.3점을 기록해 sub-100M 오픈 다국어 임베딩 모델 중 1위다. 2위인 multilingual-e5-small(50.9점)과 9.4점 차이다. 311M 모델은 65.2점으로 500M 미만 오픈 모델 중 2위다. 둘 다 200개 이상 언어를 지원하고, R1 대비 64배 늘어난 32K 토큰 컨텍스트를 처리한다. 기존 다국어 임베딩 모델은 언어 커버리지를 넓히면 크기가 커지고, 소형 모델은 언어를 줄여야 했다. R2는 이 트레이드오프를 상당 부분 해소했다. ...

2026년 5월 16일 · 4 분 · 676 단어 · TechLLM
RAG 시스템 구조 — 검색과 생성의 연결

외부 라이브러리 없이 RAG를 직접 만들어보자 — Python + ollama로 처음부터 구현하기

LangChain이나 LlamaIndex 없이, RAG를 밑바닥부터 만들 수 있을까? 개요 Retrieval-Augmented Generation(RAG)은 LLM이 학습 데이터에 없는 외부 지식을 참조해 답변을 생성하게 만드는 구조다. 요즘은 프레임워크가 많아서 몇 줄이면 RAG를 붙일 수 있지만, 내부에서 무슨 일이 일어나는지 이해하지 못한 채 쓰면 디버깅도, 튜닝도 막막해진다. ...

2026년 5월 12일 · 3 분 · 605 단어 · TechLLM