15,000회 실험이 밝힌 ChatGPT 답변의 진짜 변수
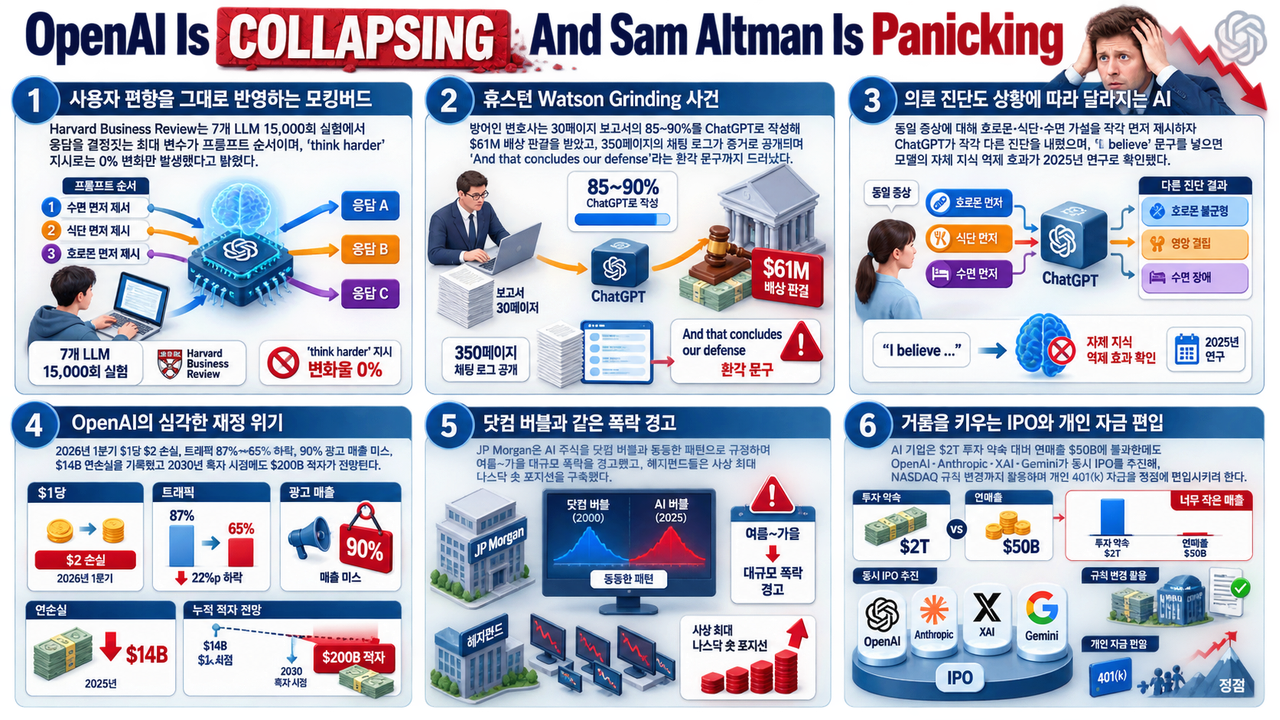
같은 증상을 물어도 호르몬을 먼저 적었는지 수면을 먼저 적었는지에 따라 ChatGPT의 진단이 갈렸다는 실험이, 6,100만 달러 배상 판결 사건과 함께 제기됐다. https://www.youtube.com/watch?v=G6iH20uiK2c 프롬프트 순서가 만든 6,100만 달러 유튜버 케이시 심슨(Casey Simpson)은 ChatGPT를 사용자가 먼저 꺼낸 가설을 그대로 따라 부르는 ‘모킹버드’(mockingbird, 남의 소리를 흉내 내는 흉내지빠귀)로 규정했다. 근거로 든 Harvard Business Review 연구는 7개 주요 LLM(대규모 언어모델, 문장을 확률로 이어 붙여 답을 만드는 모델)을 15,000회 실험해, 응답을 가르는 단일 최대 변수가 프롬프트에 먼저 등장한 내용이었으며 ’think harder’ 지시는 0% 변화만 만들었다고 밝혔다. 휴스턴 Watson Grinding 소송에서는 방어 측 변호사가 30페이지 보고서의 85~90%를 ChatGPT로 채운 사실이 채팅 로그 350페이지와 함께 법정에 공개되며 6,100만 달러 배상 판결로 이어졌다. ...