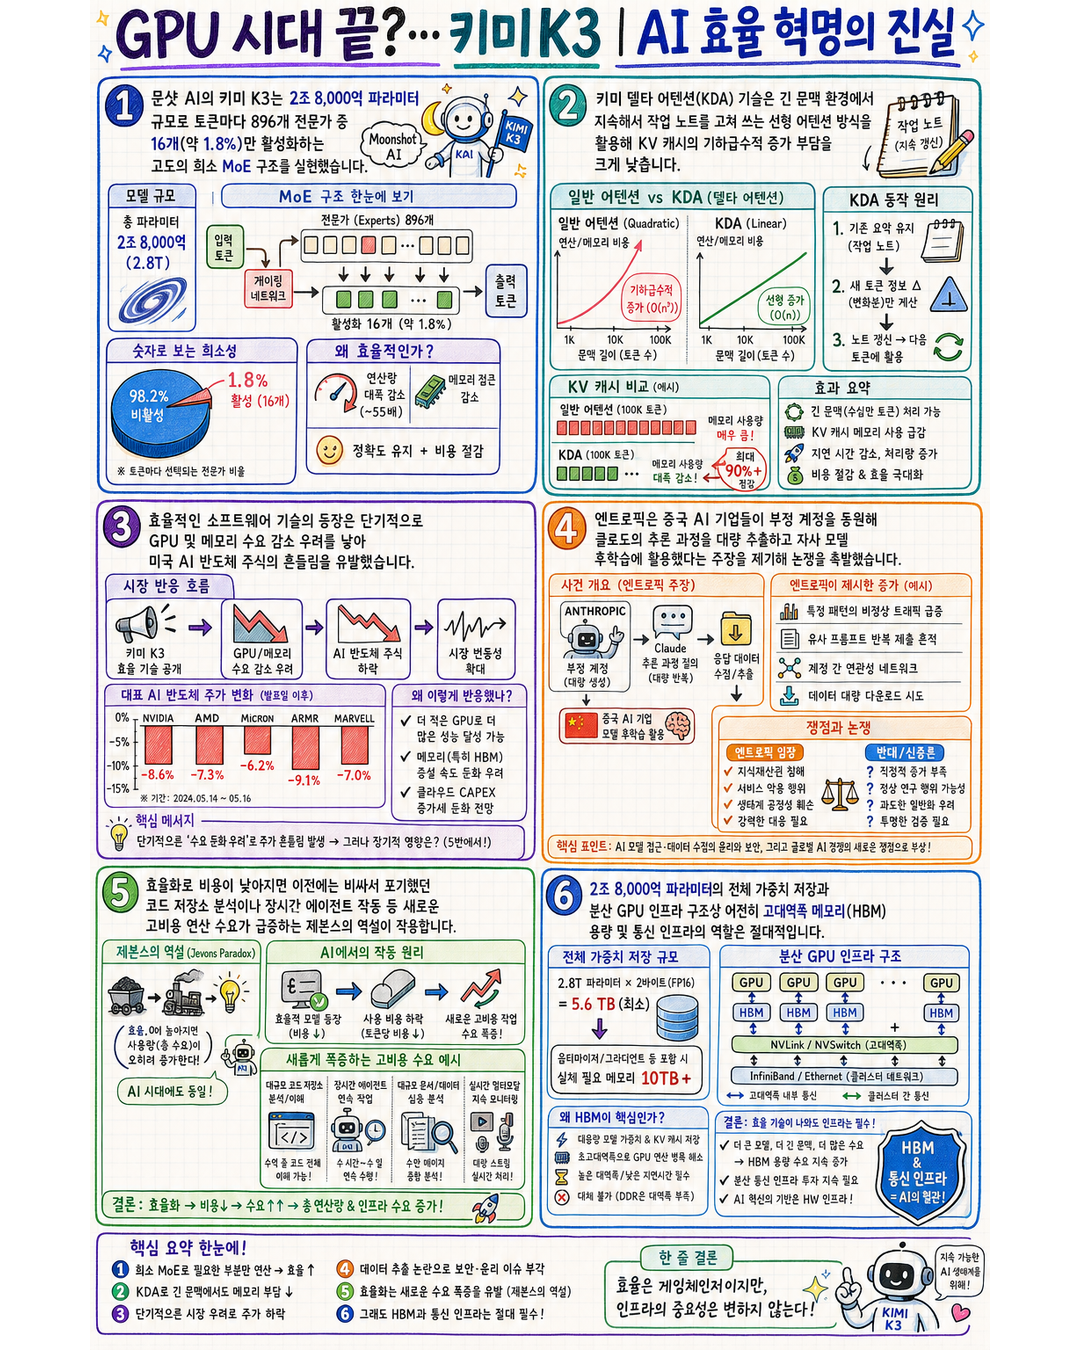
키미 K3의 초희소 MoE 구조와 GPU·메모리 수요 변화를 정리한 인포그래픽

키미 K3가 흔든 건 GPU 수요가 아니라 GPU를 보는 기준입니다

핵심 요약 문샷 AI가 공개한 키미 K3는 총 2조 8000억 파라미터인데, 토큰 하나를 처리할 때 896개 전문가 중 16개만 켭니다. 활성 비율이 약 1.8%입니다. 키미 델타 어텐션(KDA) 은 지난 토큰의 모든 계산을 다 펼쳐두는 대신, 작업 노트 한 장을 계속 고쳐 쓰는 선형 어텐션 방식으로 KV 캐시 폭증을 눌렀습니다. 발표 직후 미국 AI 반도체 주가가 흔들렸습니다. “소프트웨어가 이렇게 효율적이면 GPU를 덜 사도 되는 것 아니냐"는 계산이 돌았기 때문입니다. 그런데 2.8TB짜리 가중치를 어딘가에 올려두고, 흩어진 전문가끼리 실시간으로 통신시켜야 한다는 조건은 그대로입니다. HBM 용량과 대역폭은 여전히 병목입니다. 연산이 싸지면 예전엔 비싸서 포기했던 작업이 살아납니다. 저장소 전체 분석, 몇 시간짜리 에이전트 실행 같은 것들이죠. 제본스의 역설이 그대로 작동합니다. 앞으로의 경쟁력은 GPU를 몇 장 가졌느냐가 아니라, 같은 메모리에서 얼마나 많은 유효 작업을 뽑아내느냐로 옮겨갑니다. 2조 8000억인데 1.8%만 켠다 키미 K3의 숫자는 언뜻 모순처럼 보입니다. 총 파라미터는 2조 8000억. 그런데 토큰 하나를 처리할 때 실제로 계산에 참여하는 전문가는 896개 중 16개뿐입니다. ...
2026년 7월 21일 · 5 분 · 945 단어 · TechLLM
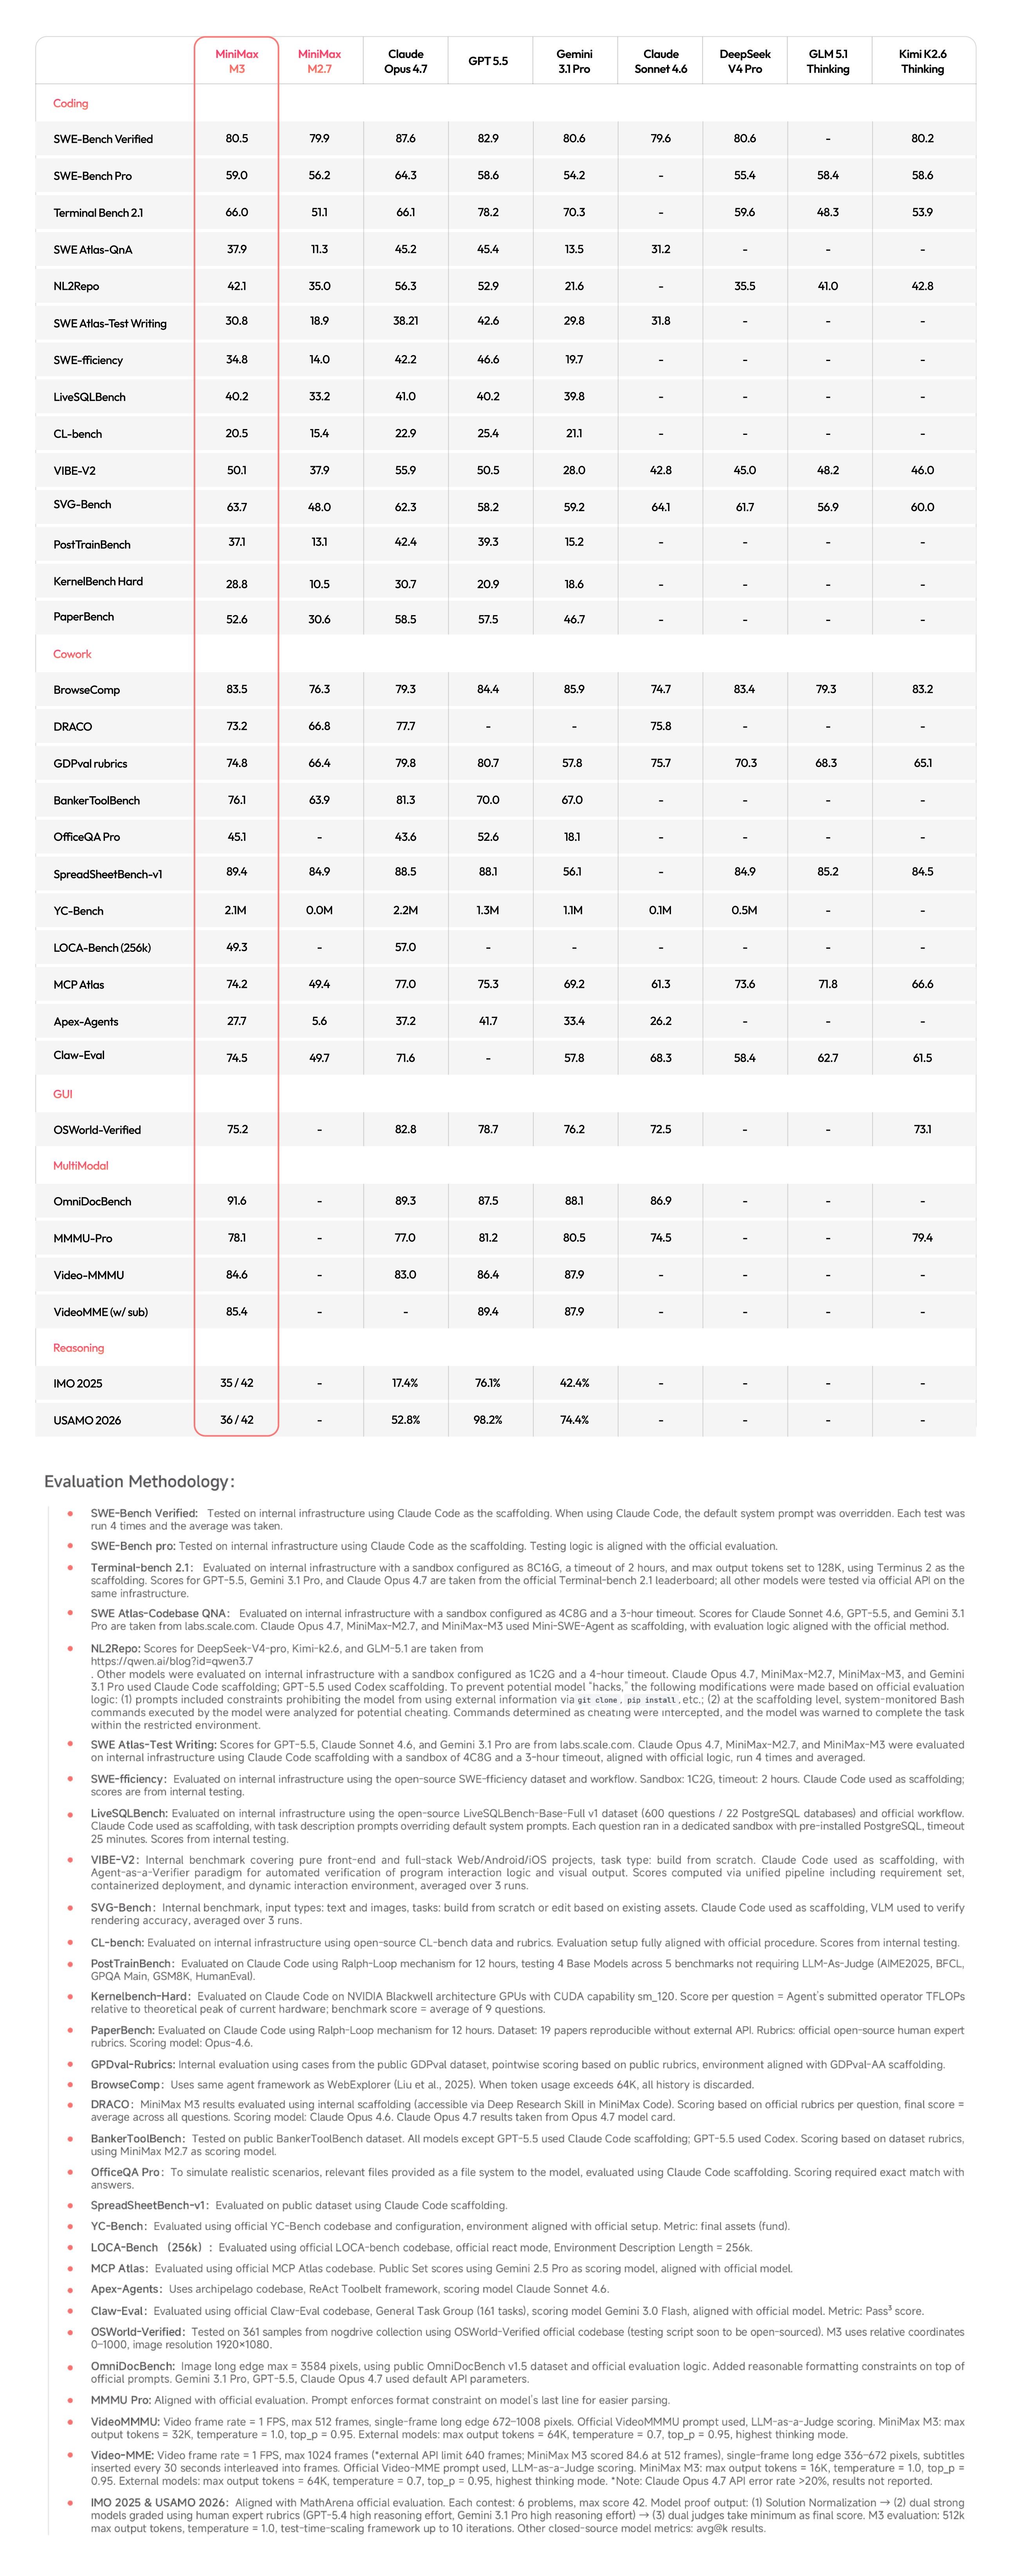
MiniMax-M3 벤치마크 비교 — HuggingFace 모델 카드 공식 이미지

MiniMax-M3 로컬 배포 실전: vLLM·SGLang·Docker로 428B MoE 돌리기

개요 MiniMax가 HuggingFace에 M3 모델 카드를 올렸습니다. 발표 글만 보고 “오, 좋네” 하고 끝낼 수도 있지만, 진짜 궁금한 건 따로 있습니다. 실제로 어떻게 돌리지? 이 글은 모델 카드에 나와 있는 vLLM, SGLang, Transformers, Docker 실행법을 한국 개발자 입장에서 정리한 실전 메모입니다. ...

2026년 6월 13일 · 4 분 · 719 단어 · TechLLM
어두운 격자 위에 300개 서브 에이전트가 빛나며 병렬로 일하는 모습을 표현한 이미지

문샷 Kimi Work 공개 — 300개 서브 에이전트가 내 노트북에서 동시에 돌아간다

개요 문샷 AI가 6월 12일 Kimi Work라는 데스크톱 앱을 공개했습니다. 클라우드가 아니라 내 맥북, 내 윈도우 PC 위에서 직접 도는 에이전트입니다. 뒤에서는 4월 20일에 풀린 Kimi K2.6이 돌고, 한 번에 최대 300개의 서브 에이전트가 같이 일을 쪼개 처리합니다. 클라우드 에이전트가 “잘 만든 데모"에 머무는 동안, 문샷은 “내 폴더와 내 브라우저에 꽂아 쓰는 도구” 쪽을 골랐습니다. ...

2026년 6월 12일 · 3 분 · 594 단어 · TechLLM
DiffusionGemma — 구글이 공개한 26B MoE 텍스트 디퓨전 오픈 모델

DiffusionGemma 공개 — 구글이 띄운 26B '텍스트 디퓨전' 모델, 토큰을 한 줄씩이 아니라 한 판으로 찍어낸다

DiffusionGemma는 자기회귀 디코딩을 텍스트 디퓨전으로 바꿔 H100 기준 초당 1,000토큰을 넘긴다. 품질은 Gemma 4보다 한 단계 낮지만, 로컬·단일 사용자·인터랙티브 환경에서 4배 가까운 속도를 노리는 실험적 오픈 모델이다.

2026년 6월 11일 · 4 분 · 668 단어 · TechLLM
1조 파라미터 모델을 상용 GPU 위에서 1000 토큰/초로 디코딩하는 MiMo×TileRT 코디자인을 표현한 일러스트

샤오미 MiMo × TileRT, 상용 GPU 8장으로 1조 파라미터 모델 초당 1000 토큰 돌파

핵심 요약 샤오미 MiMo 팀과 TileRT 그룹이 MiMo-V2.5-Pro-UltraSpeed를 발표했다. 1조 파라미터 모델이 표준 8-GPU 노드에서 초당 1000 토큰 이상으로 디코딩된다. 비결은 세 층의 협업이다 — MoE 전용 FP4(MXFP4) 양자화, DFlash 블록 마스크 병렬 speculative decoding, TileRT persistent-kernel 런타임. 양자화는 표현력 손실을 막기 위해 MoE에만 걸고 나머지는 FP8을 유지했다. speculative decoding은 거부 샘플링으로 무손실을 보장한다. 가격은 표준 모델의 3배, 디코딩 속도는 약 10배. 병렬 추론·코딩 에이전트·실시간 거래 신호 같은 워크로드에서 비용 곡선이 뒤집힌다. API는 6월 9~23일 신청제 트라이얼로 좁게 열려 있고, FP4-DFlash 체크포인트와 TileRT 일부 모듈은 허깅페이스·깃허브에 공개됐다. 1조 파라미터를 표준 GPU에서 — 무엇이 새로운가 Cerebras는 웨이퍼 한 장에 모델을 통째로 박아 넣고, Groq는 칩 위 SRAM으로 메모리 병목을 풀었다. 두 길 다 “더 빨라지려면 더 특수한 실리콘"이라는 전제 위에 있다. 샤오미가 이번에 보여준 길은 다르다. 하드웨어는 그대로 두고, 모델과 런타임을 같은 칠판 위에서 함께 설계해 1조 파라미터 모델을 표준 노드에서 1000+ TPS로 돌렸다. ...

2026년 6월 9일 · 4 분 · 799 단어 · TechLLM
Qwen 3.7 Plus cover image, oil painting style

Qwen 3.7 Plus — 알리바바가 다시 1등을 노린다, 235B MoE와 1M 토큰의 비밀

Qwen 3.7 Plus 핵심: 235B/22B 활성 MoE, 1M 토큰 컨텍스트, AIME25 70.3·Arena-Hard 79.2·GPQA 77.5로 오픈소스 SOTA 경신. 인스트럭트 팔로잉·에이전트·다국어 모두 향상.

2026년 6월 2일 · 5 분 · 890 단어 · TechLLM
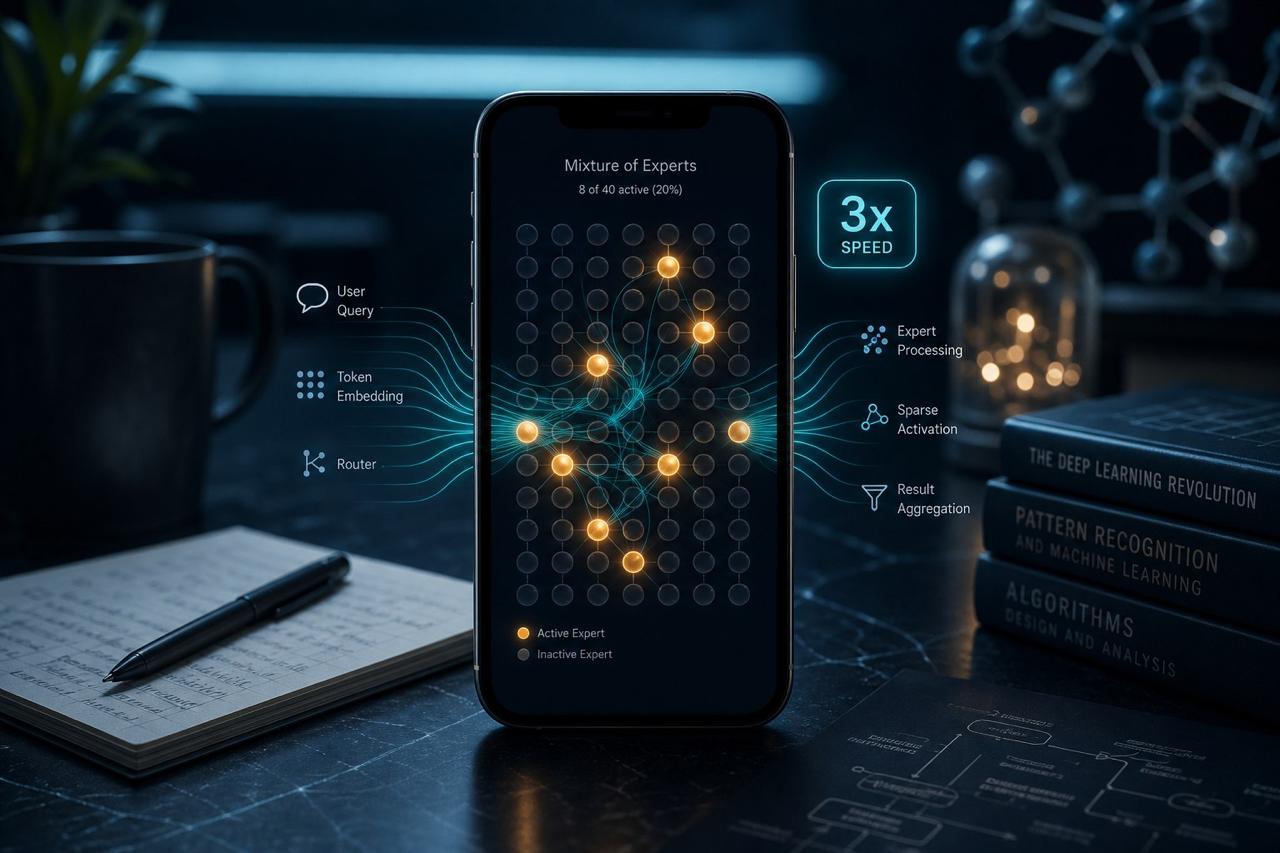
DECO 아키텍처가 온디바이스 환경에서 sparse MoE로 dense 성능을 따라잡는 모습을 표현한 일러스트

DECO — 온디바이스 LLM에 처음 'dense 매칭' MoE를 데려온다

핵심 요약 새로 공개된 DECO는 sparse MoE를 dense Transformer 성능에 매칭시키는 아키텍처다 — 동일 total parameter 예산·학습 토큰 조건에서. 핵심은 세 가지: ① 학습 가능한 expert-wise scaling이 결합된 ReLU 기반 라우팅, ② SiLU 앞에 normalize를 두는 NormSiLU 활성화, ③ non-gated MLP expert + ReLU 라우팅 조합. 전체 expert 중 20%만 활성화해도 dense 모델 성능을 따라잡고, 기존 MoE baseline을 능가했다. 전용 가속 커널 적용 시 실제 하드웨어에서 dense 추론 대비 3.00× speedup. 코드와 체크포인트가 공개 예정이라 온디바이스 LLM에 MoE를 진지하게 적용해볼 첫 실용적 후보가 될 가능성이 있다. MoE는 왜 온디바이스에서 잘 안 됐나 Mixture-of-Experts(MoE)는 LLM 효율화의 단골 후보다. 전체 capacity는 크게, 한 번 추론에 쓰는 계산은 작게. 클라우드 환경에서는 이 트레이드오프가 매력적이지만, 휴대폰·노트북·임베디드 같은 end-side(온디바이스) 환경으로 옮기면 다른 문제가 튀어나온다. ...

2026년 5월 12일 · 4 분 · 760 단어 · TechLLM