큰 모델의 일부만 작은 추가로 바꾸는 LoRA의 크기(랭크)를 정할 때, 실제 작업에서 모델이 ‘어느 단어를 얼마나 볼지’를 얼마나 잘 따라갈 수 있는지 계산하는 이론이다.

큰 모델의 일부만 작은 추가로 바꾸는 LoRA의 크기(랭크)를 정할 때, 실제 작업에서 모델이 ‘어느 단어를 얼마나 볼지’를 얼마나 잘 따라갈 수 있는지 계산하는 이론이다. 무엇이 문제였나 — LoRA의 랭크가 낮으면 추가 장치가 담을 수 있는 변화 방향이 적어 목표와 다른 주의 분포가 될 수 있습니다. 어떻게 풀었나 — 논문은 실제 작업 입력에서 자주 쓰이는 변화 방향에 가중치를 주어, 각 랭크의 오차 상한과 하한을 계산합니다. 그래서 뭐가 좋아졌나 — 결과는 attention 확률 분포의 차이까지를 다루며, 최종 답변이 같은지나 작업 점수가 좋아지는지는 보장하지 않습니다. ...
2026년 11월 9일 · 7 분 · 1347 단어 · TechLLM

학생마다 다른 실수와 반응을 흉내 내는 AI 학생을 만들어, AI 튜터를 더 잘 훈련시키는 방법이다.

학생마다 다른 실수와 반응을 흉내 내는 AI 학생을 만들어, AI 튜터를 더 잘 훈련시키는 방법이다. 무엇이 문제였나 — AI 튜터를 개선하려면 실제 학생이 어떤 설명에 좋아지는지 알아야 하지만, 그런 데이터를 많이 모으기는 어렵다. 어떻게 풀었나 — 이 논문은 여러 학생의 기록으로 공통 패턴을 먼저 배우고, 각 학생의 적은 기록으로 개인별 시뮬레이터를 만드는 방법을 제안한다. 그래서 뭐가 좋아졌나 — 체스, 영어 작문, 수학에서 이 시뮬레이터는 기존 대형 모델보다 특정 학생의 답을 더 잘 흉내 내고, 설명을 들은 뒤 답을 더 잘 고쳤다. ...

2026년 10월 9일 · 6 분 · 1082 단어 · TechLLM
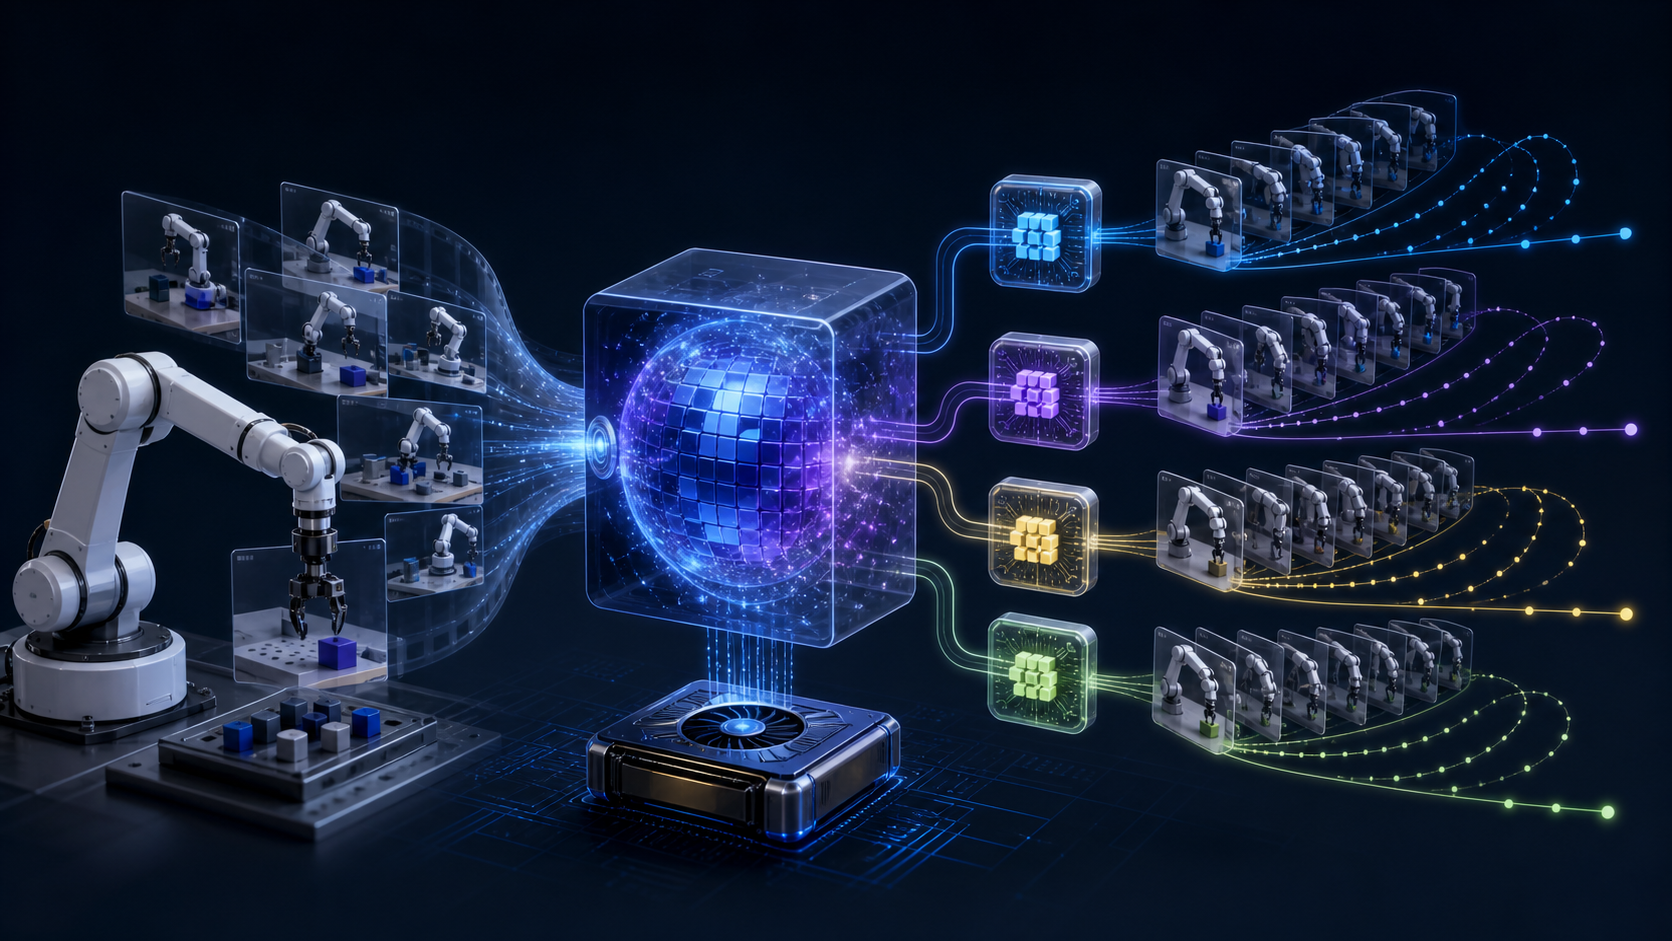
로봇 조작 영상 데이터가 월드 모델과 LoRA 어댑터를 거쳐 합성 궤적으로 확장되는 기술 일러스트

Cosmos Predict 2.5, 로봇 영상을 LoRA로 빠르게 길들이는 법

NVIDIA가 Hugging Face에 공개한 글은 Cosmos Predict 2.5를 로봇 조작 영상에 맞게 파인튜닝하는 방법을 다룬다. 핵심은 거대한 비디오 월드 모델 전체를 다시 학습하는 것이 아니라, LoRA와 DoRA 어댑터만 학습해 적은 데이터로 로봇 합성 영상을 만드는 것이다. ...

2026년 5월 24일 · 3 분 · 591 단어 · TechLLM