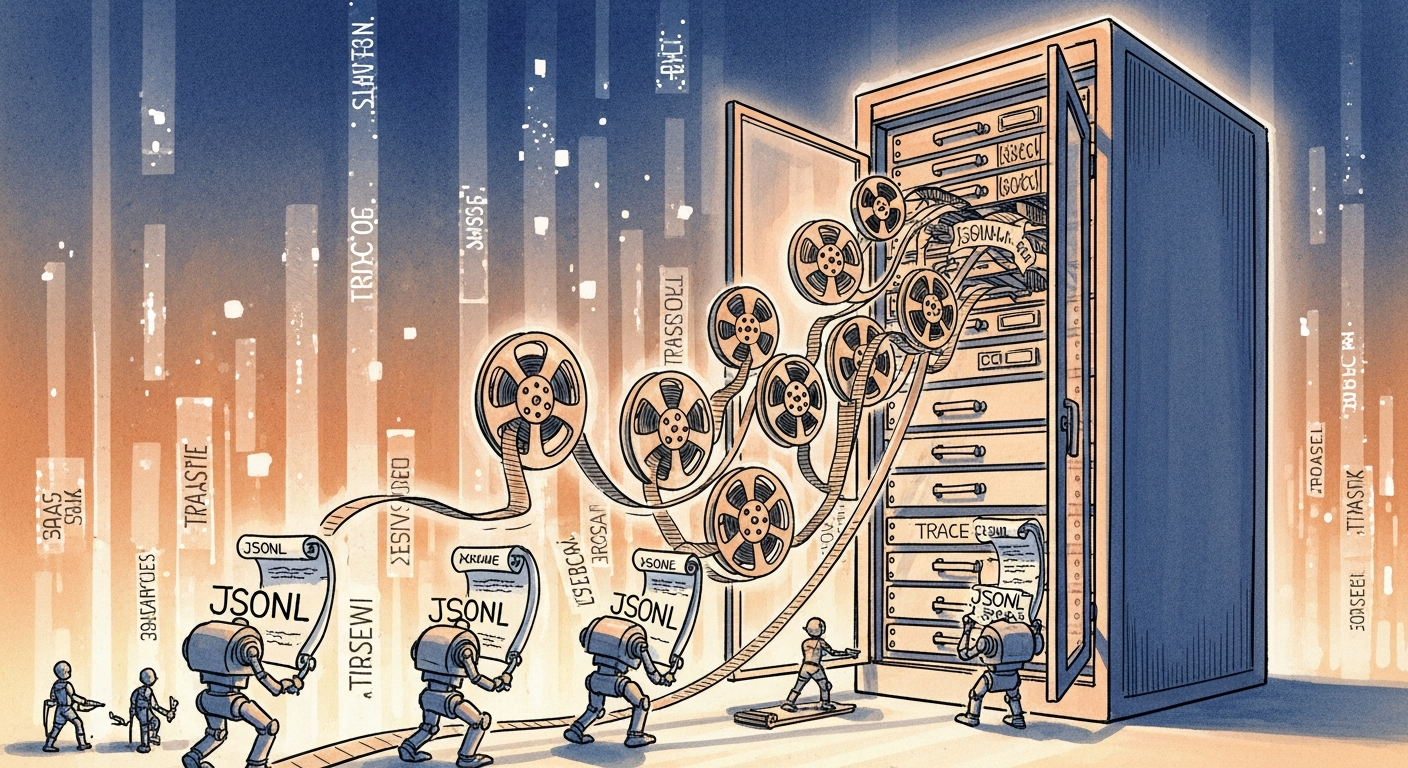
소프트웨어는 잊는다 — 에이전트 실행 흔적이 곧 메모리다
개요 코드베이스는 예전부터도 설명하기 어려운 존재였다. 원작자조차 ‘왜 이렇게 짰는지’를 기억하지 못하는 일이 흔했다. 주석, 문서, git blame, 위키, 의사결정 로그 — 수많은 방법을 시도했지만, 결국 모두 누군가가 유지보수해야 한다는 전제가 달렸다. 그리고 그 유지보수는 항상 기능 개발에 밀렸다. ...
개요 코드베이스는 예전부터도 설명하기 어려운 존재였다. 원작자조차 ‘왜 이렇게 짰는지’를 기억하지 못하는 일이 흔했다. 주석, 문서, git blame, 위키, 의사결정 로그 — 수많은 방법을 시도했지만, 결국 모두 누군가가 유지보수해야 한다는 전제가 달렸다. 그리고 그 유지보수는 항상 기능 개발에 밀렸다. ...
출처: Mem0 문서유형: 번역·해설 #ContextEngineering #AIAgent #RAG #Memory #Mem0 핵심 요약 AI를 잘 쓰려면 프롬프트를 잘 써야 한다고 말합니다. 틀린 말은 아닙니다. 하지만 AI 에이전트가 실제 업무에 들어오기 시작한 지금은, 프롬프트 한 줄보다 더 중요한 것이 있습니다. 바로 컨텍스트 엔지니어링입니다. ...
출처: Mem0 문서유형: 번역·해설 #Mem0 #AgentMemory #AIAgent #LLMOps 핵심 요약 많은 AI 에이전트는 처음에 MEMORY.md, CLAUDE.md, .cursorrules 같은 파일 하나로 기억을 시작합니다. 작고 단순할 때는 이 방식이 빠르고 투명합니다. 문제는 사용자가 늘고, 기억이 쌓이고, 여러 에이전트가 동시에 쓰기 시작하는 순간부터입니다. ...
출처: Databricks 문서유형: 번역·해설 #Databricks #AgentMemory #AIAgent #MemAlign #LLMOps 핵심 요약 Databricks는 AI 에이전트 성능을 키우는 새로운 축으로 memory scaling을 제안합니다. 더 큰 모델이나 더 긴 추론만으로는 부족하고, 에이전트가 과거 대화, 피드백, 성공·실패한 실행 궤적, 조직 지식을 얼마나 잘 저장하고 꺼내 쓰는지가 성능을 좌우한다는 관점입니다. ...
출처: Mem0 문서유형: 번역·해설 #Mem0 #AgentMemory #AIAgent #LLMOps #OpenMemory 핵심 요약 Mem0의 State of AI Agent Memory 2026은 한 가지를 분명히 말합니다. 에이전트 메모리는 더 이상 “대화 기록을 컨텍스트에 넣는 꼼수”가 아닙니다. 벤치마크, 전용 인프라, graph memory, MCP 기반 로컬 메모리까지 갖춘 독립 아키텍처가 됐습니다. ...
출처: Anthropic 문서유형: 번역·해설 #Anthropic #Claude #MultiAgent #AIAgent #Research 핵심 요약 Anthropic이 Claude Research를 만들며 얻은 결론은 분명합니다. 복잡한 리서치에서는 “하나의 똑똑한 에이전트”보다, 여러 하위 에이전트가 각자 다른 방향을 탐색하고 핵심만 압축해 올리는 구조가 더 강합니다. 다만 이 방식은 토큰과 조율 비용이 크기 때문에, 모든 작업이 아니라 넓은 정보 탐색이 필요한 고부가가치 작업에 맞습니다. ...
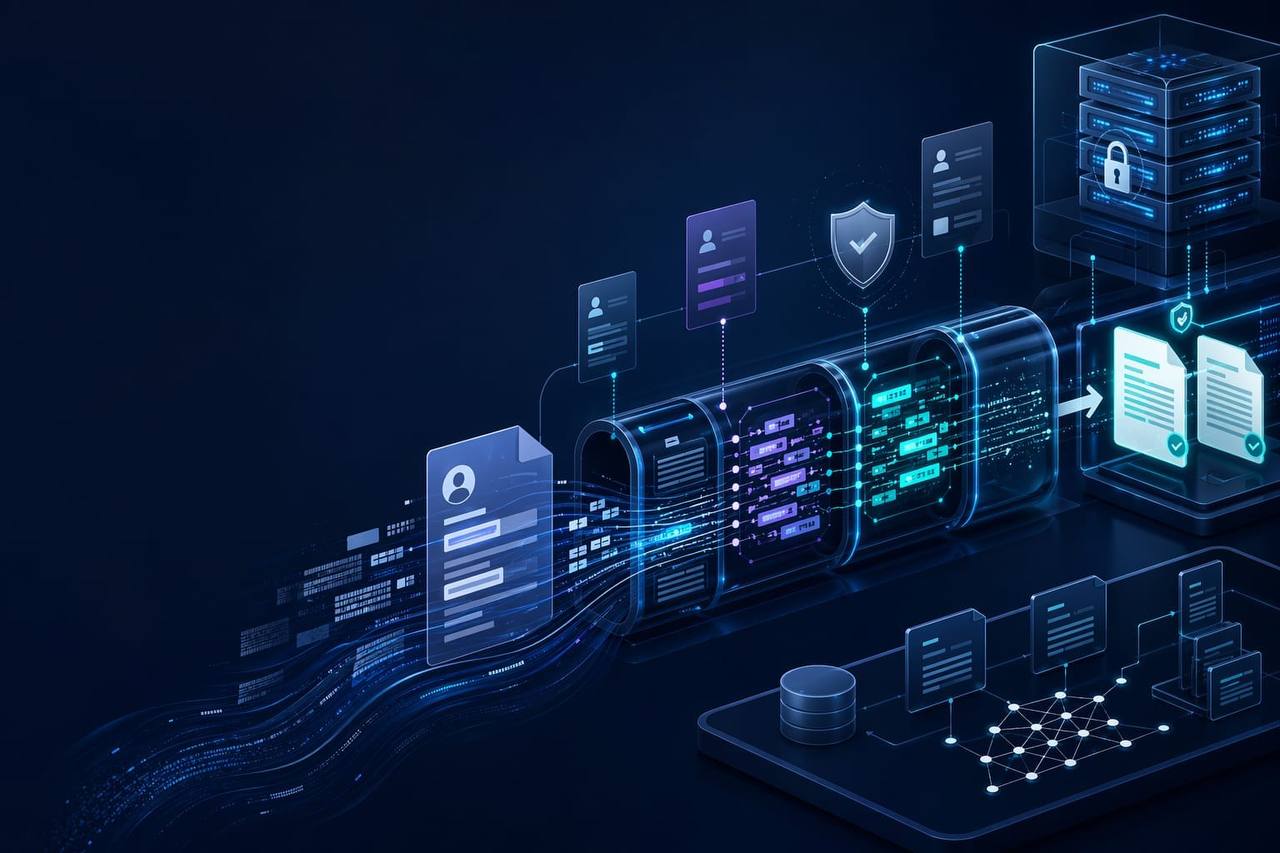
출처: TechLLM 문서유형: 모델 해설 #OpenAI #PrivacyFilter #PII #개인정보보호 #RAG #LLMOps #온프레미스 #비식별화 핵심 요약 OpenAI Privacy Filter는 PII 탐지와 마스킹을 위한 양방향 토큰 분류 모델이다. Apache 2.0 라이선스, 128K 컨텍스트, 온프레미스 배포, 파인튜닝 가능성까지 갖춰 실무형 전처리 레이어로 꽤 매력적이다. 다만 이 모델은 완전한 익명화 엔진이 아니라, privacy-by-design을 돕는 보조 도구에 가깝다. ...