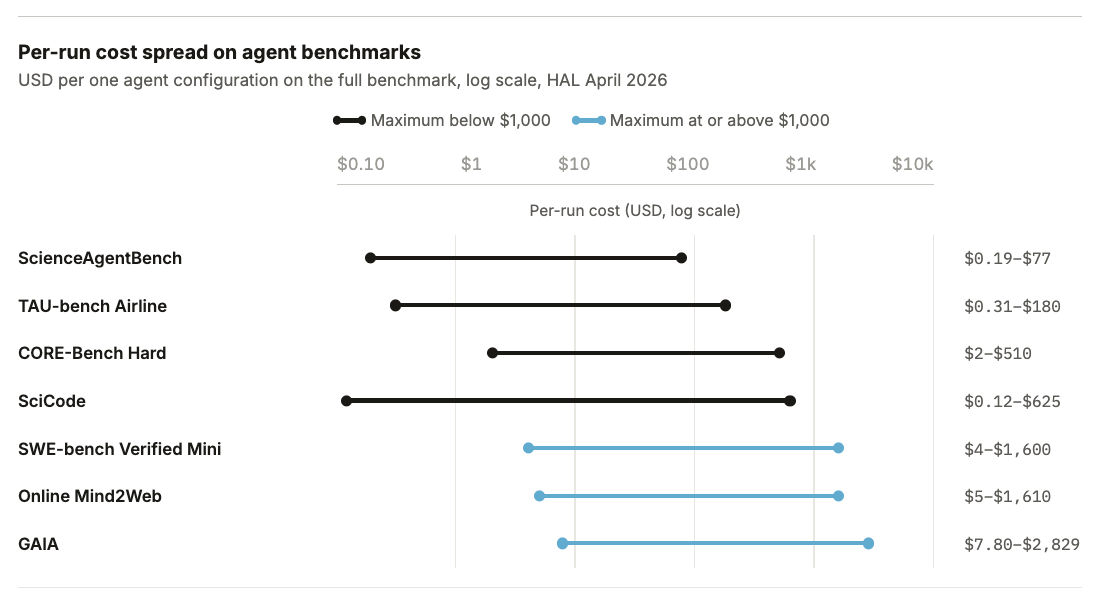
HAL 벤치마크별 에이전트 평가 비용 분포 — 일부 벤치마크는 1회 실행에 $1,000 이상

AI 평가가 새로운 compute 병목이 됐다 — $40,000짜리 벤치마크의 시대

모델을 훈련하는 비용이 문제라고 했다. 이제 평가하는 비용이 문제가 됐다. Holistic Agent Leaderboard(HAL)은 최근 9개 모델, 9개 벤치마크에서 21,730회 에이전트 롤아웃을 실행하는 데 4만 달러를 썼다. GAIA 벤치마크 하나를 최신 모델로 돌리면 캐싱 전 비용이 2,829달러다. PaperBench 1회 평가는 약 9,500달러다. ...
2026년 5월 10일 · 6 분 · 1172 단어 · TechLLM
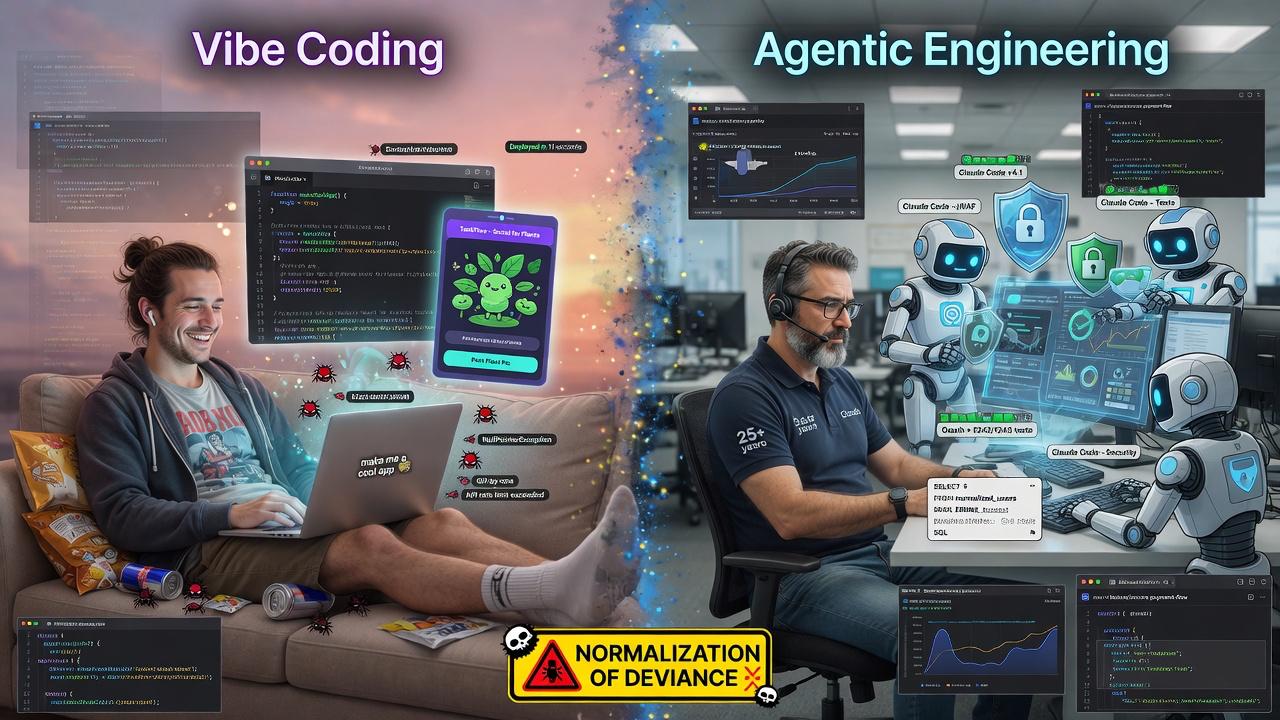
바이브 코딩과 에이전틱 엔지니어링이 수렴하는 개념도

바이브 코딩과 에이전틱 엔지니어링의 경계가 흐려지고 있다

시몬 윌리슨(Simon Willison)은 오픈소스 데이터 도구로 유명한 개발자이자, AI 코딩 도구 분야에서 손꼽히는 논객이다. 그가 최근 팟캐스트 인터뷰에서 한 마디를 털어놨다. “바이브 코딩과 에이전틱 엔지니어링이 이미 내 안에서 섞이기 시작했다. 솔직히 꽤 불편하다.” ...

2026년 5월 9일 · 3 분 · 528 단어 · TechLLM
GPT-Realtime-2 voice intelligence models

GPT-Realtime-2, 이제 목소리로 GPT-5급 추론을 한다

GPT-Realtime-2(GPT-5급 추론), GPT-Realtime-Translate(70개 언어 동시통역), GPT-Realtime-Whisper(스트리밍 전사). 2026년 5월 7일 OpenAI가 실시간 음성 API에 세 가지 신모델을 출시했다. 음성 인터페이스가 단순 응답을 넘어 실제 업무를 처리하는 에이전트 수준으로 올라간다.

2026년 5월 7일 · 3 분 · 574 단어 · TechLLM
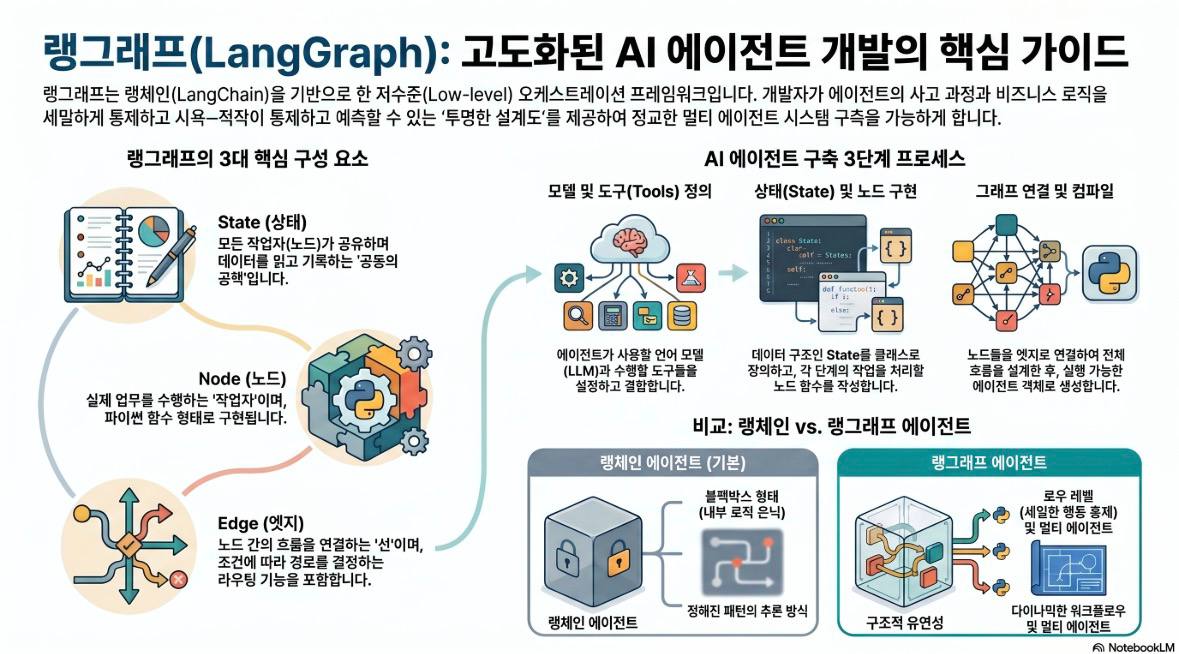
LangGraph 핵심 가이드 — State, Node, Edge 구조와 LangChain 비교

LangGraph 완전 정복 — Bloom AI 9시간 마스터클래스 완전 분석

LangGraph V1 대규모 업데이트를 기반으로 한 Bloom AI 9시간 마스터클래스 전체 분석. 기초 문법부터 Memory, Multi-Agent 아키텍처까지 섹션별 핵심을 정리하고 실무 적용 포인트를 추가했다.

2026년 5월 7일 · 9 분 · 1883 단어 · TechLLM
LangGraph Agentic AI 시스템 구축

LangGraph로 Agentic AI 시스템 구축하기 — 테디노트 밋업 발표 완전 정리

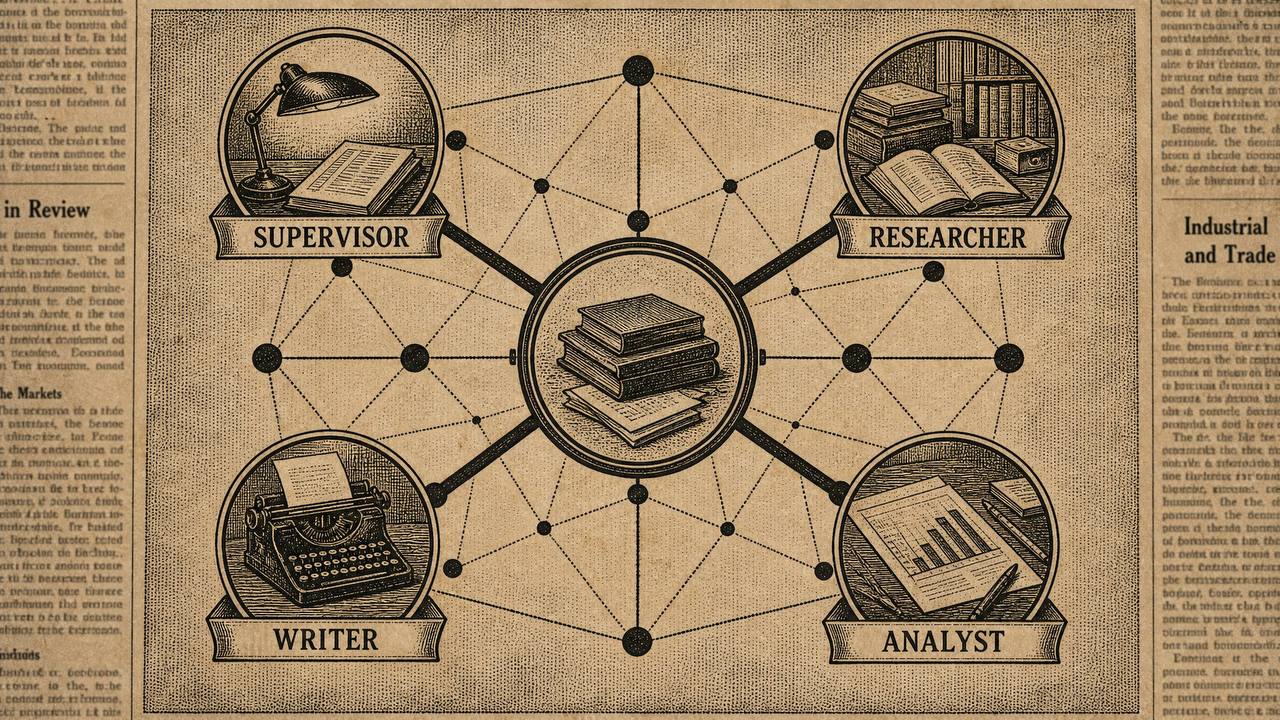
테디노트가 에이전틱 AI 밋업 2025 Q1에서 발표한 LangGraph 실전 가이드. Advanced RAG 한계 → LangGraph 핵심 기능 → 라우팅 두 방식 → 메모리/Human-in-the-Loop → 멀티에이전트 슈퍼바이저 패턴까지 실무 중심으로 정리.

2026년 5월 7일 · 7 분 · 1457 단어 · TechLLM
DeepInfra on Hugging Face Inference Providers

DeepInfra, Hugging Face Inference Provider로 합류하다

DeepInfra가 Hugging Face Inference Provider로 합류했다. HF 토큰 하나로 DeepSeek V4 Pro, Kimi-K2.6 등 100개 이상의 오픈웨이트 모델을 OpenAI 호환 API로 호출할 수 있으며, PRO 플랜은 매월 $2 크레딧을 전체 Provider에서 공유 사용한다.

2026년 5월 7일 · 2 분 · 402 단어 · TechLLM
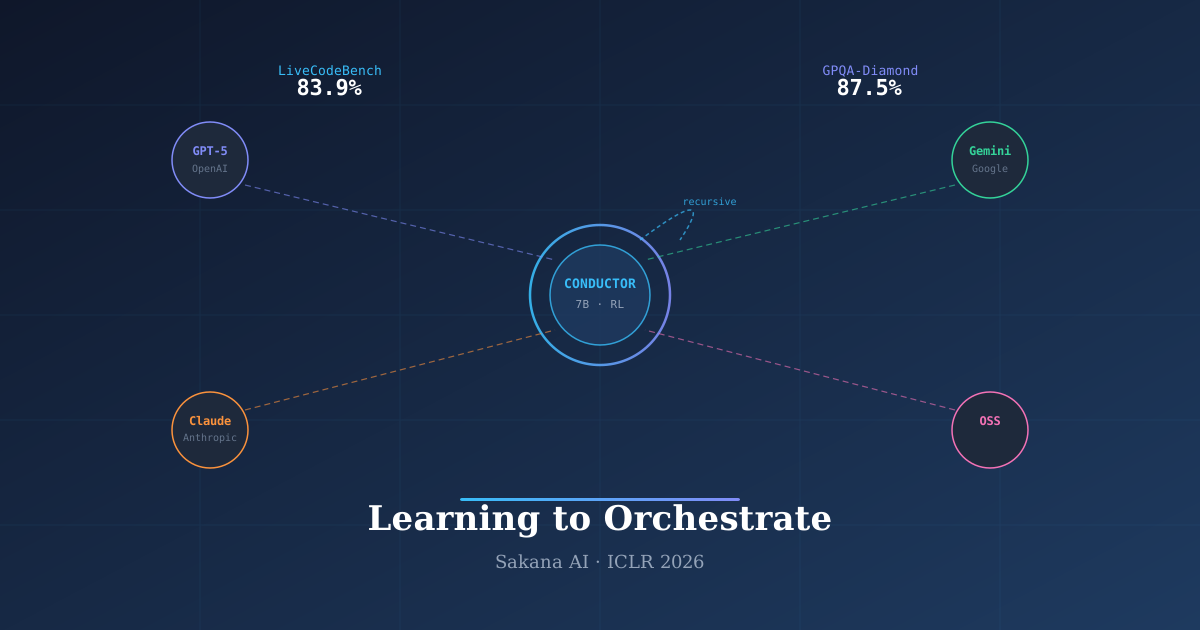
Sakana AI Conductor multi-agent orchestration diagram

Sakana AI Conductor: 7B 모델이 GPT-5·Claude·Gemini를 지휘한다

Sakana AI의 Conductor는 7B RL 모델이 자연어로 다중 AI 에이전트를 동적 오케스트레이션하는 시스템이다. 단순 질문엔 단일 모델, 복잡한 코딩엔 플래너-코더-검증기 파이프라인을 자율 구성한다.

2026년 5월 4일 · 3 분 · 427 단어 · TechLLM
Open-weights AI model defeating frontier models in coding challenge

오픈웨이트 중국 모델이 Claude·GPT-5.5·Gemini를 이겼다

핵심 요약 2026년 4월 30일, Rohana Rezel이 운영하는 AI Coding Contest의 12번째 챌린지 Word Gem Puzzle에서 Moonshot AI의 오픈웨이트 모델 Kimi K2.6이 22 매치 포인트(7승 1패)로 1위를 차지했다. 2위는 Xiaomi의 MiMo V2-Pro, 3위 GPT-5.5, Claude Opus 4.7은 5위에 그쳤다. ...

2026년 5월 3일 · 3 분 · 464 단어 · TechLLM
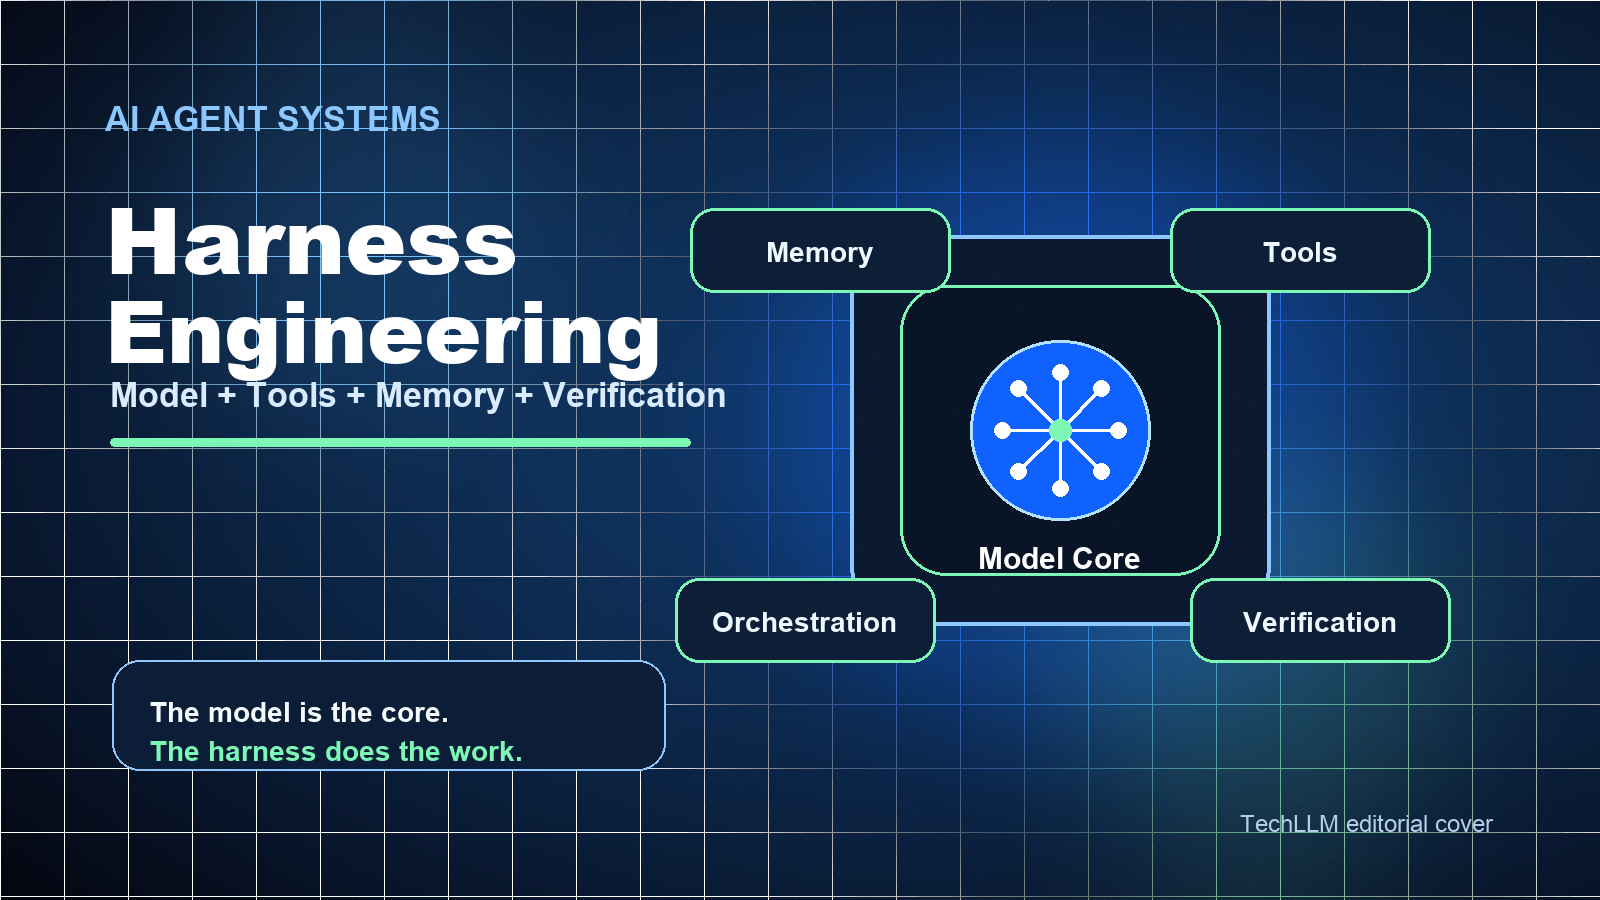
English cover reading Harness Engineering, Model Core, Memory, Tools, Verification, Orchestration

AI 에이전트의 성능은 모델보다 하네스에서 갈린다

핵심 요약 AI 에이전트를 만들 때 가장 먼저 떠올리는 질문은 보통 “어떤 모델을 쓸까?”입니다. 물론 모델 선택은 중요합니다. 하지만 최근 에이전트 연구와 실무 사례를 보면, 성능 차이는 모델 자체보다 모델을 감싸는 실행 구조, 즉 하네스(harness) 에서 더 크게 벌어지고 있습니다. ...

2026년 5월 3일 · 3 분 · 457 단어 · TechLLM