TITO Agentic RL Token-In Token-Out training loop

TITO: 에이전틱 RL에서 토큰 드리프트를 막는 핵심 원칙

개요 에이전트 RL 학습 루프를 멀티턴으로 확장하는 순간 이상한 현상이 나타난다. 손실이 이유 없이 치솟고, 가끔 shape mismatch 오류가 난다. 원인은 거의 항상 같다 — 재토크나이제이션이 모델이 실제 샘플링한 토큰을 슬쩍 바꿔치기한다. HuggingFace의 Quentin Gallouédec과 Kashif Rasul이 이 문제의 원인과 해법을 TITO(Token-In, Token-Out) 원칙으로 정리했다. ...
2026년 6월 1일 · 4 분 · 659 단어 · TechLLM
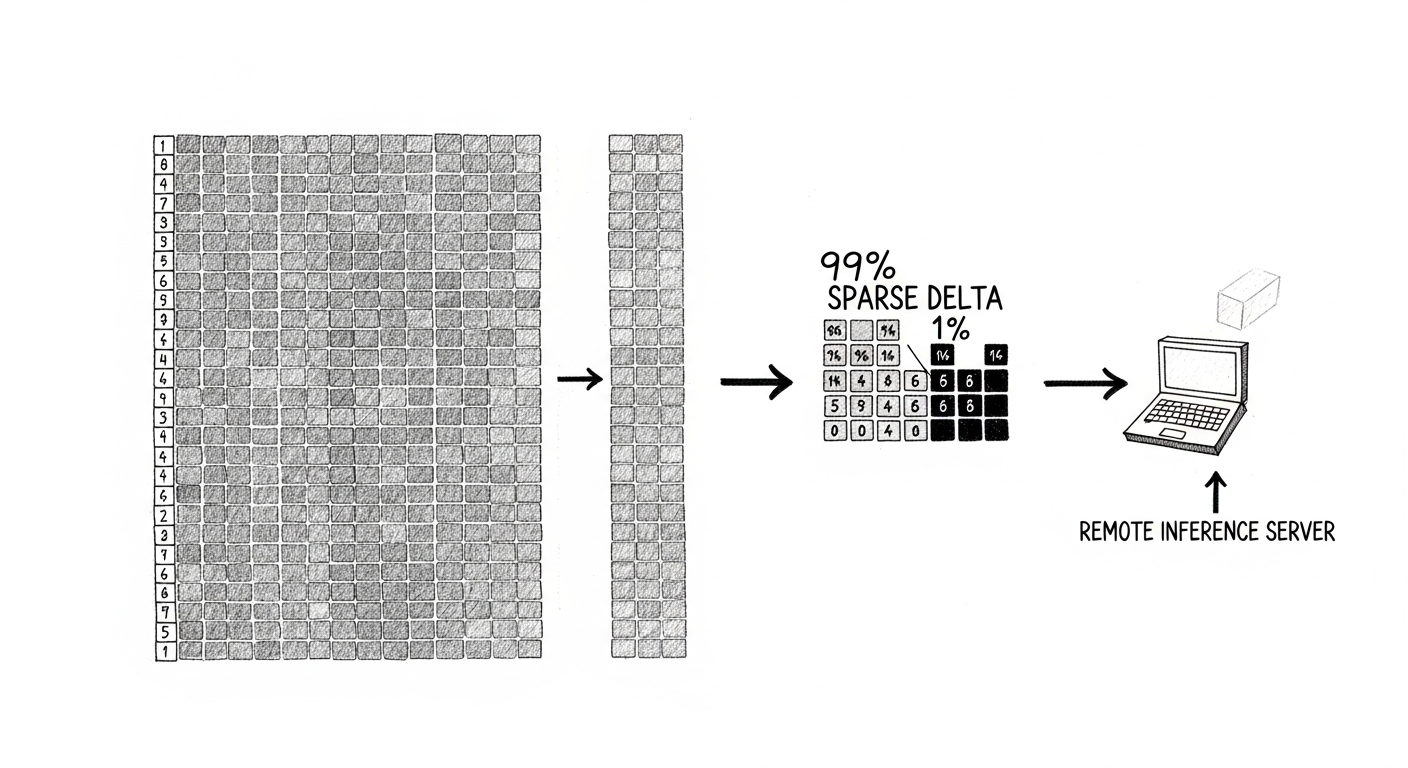
모델 가중치 변화를 희소 벡터로 인코딩해 전송하는 과정을 표현한 핸드드로잉 일러스트

Delta Weight Sync — 1TB 모델도 초당 동기화하는 비동기 RL 트릭

개요 비동기 강화학습(Async RL)에는 근본적인 문제가 있다. 매 최적화 단계마다 업데이트된 모델 가중치를 추론 엔진으로 전송해야 한다. 7B 모델이면 단계당 14GB, 1T 파라미터 모델이면 매 단계 1TB다. 비현실적이다. HuggingFace TRL 팀이 이 문제를 수학적으로 풀었다. BF16 가중치의 99% 이상은 한 옵티마이저 단계에서 실제로 변하지 않는다. 변경된 부분만 희소(sparse) 인코딩으로 전송하면 1.2GB → 20~35MB가 된다. ...

2026년 5월 27일 · 4 분 · 668 단어 · TechLLM