RMA 에이전트 수학 증명

AI가 연구 수준 수학 문제를 푼다 — RMA 에이전트 시스템 논문 분석

개요 AI가 수학 올림피아드 문제를 풀 수 있다는 건 이제 놀랍지 않다. 하지만 현역 수학자들이 연구하는 수준의 문제라면 어떨까? Georgia Tech과 공동 저자들이 발표한 RMA(Research Math Agents) 는 문헌 탐색·지식 구축·반복 검증을 아우르는 멀티에이전트 프레임워크로, First Proof 벤치마크 10문제 중 8개를 해결하며 GPT-5.2R과 Aletheia를 넘어섰다. ...
2026년 5월 25일 · 3 분 · 538 단어 · TechLLM
Darwin Family 학습 없는 추론 모델

학습 없이 GPQA Diamond 88.89% — Darwin Family, 가중치 재조합으로 프론티어 추론 달성

개요 강력한 오픈소스 LLM이 수백 개 쌓였다. VIDRAFT의 Darwin Family는 여기서 시작한다. 이미 존재하는 모델들의 가중치 공간에 원하는 능력이 잠들어 있다면? 새로 훈련하는 대신 그 잠재력을 꺼내면 된다. Darwin-28B-Opus는 그래디언트를 한 번도 쓰지 않고 GPQA Diamond 88.89%를 찍었다. 완전 훈련된 부모 모델을 뛰어넘는 수치다. ...

2026년 5월 16일 · 3 분 · 606 단어 · TechLLM
oMLX Apple Silicon LLM 서버

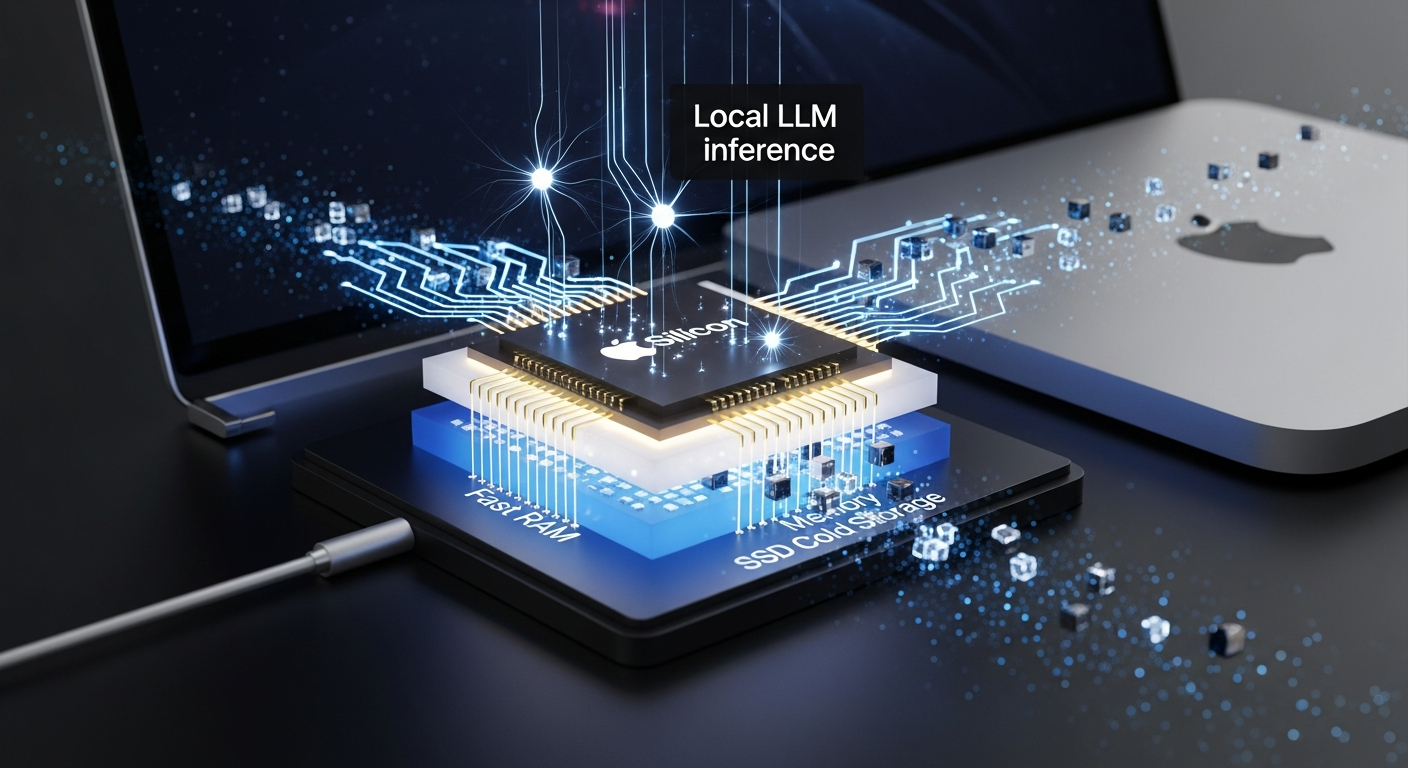
Mac에서 돌리는 로컬 LLM 서버 — oMLX, 계층형 KV 캐시와 연속 배칭

개요 로컬 LLM 서버를 써본 사람이라면 대부분 같은 불만에 맞닥뜨린다. 편하거나 제어하거나, 둘 중 하나만 된다. oMLX는 이 선택지를 거부한다. Apple Silicon Mac에 최적화된 추론 서버로, RAM과 SSD를 2계층 KV 캐시로 쓰고, 연속 배칭으로 동시 요청을 처리하고, macOS 메뉴바 앱으로 전부 제어한다. GitHub 스타 1.4만, 릴리스 71개. 실사용 기반이 탄탄하다. Llama, Qwen, Mistral, Gemma 계열 등 mlx-lm이 지원하는 모델이라면 대부분 올릴 수 있다. ...

2026년 5월 16일 · 3 분 · 637 단어 · TechLLM
비동기 연속 배칭 커버 이미지

LLM 추론 속도를 공짜로 24% 높이는 법 — 비동기 연속 배칭

개요 H200 GPU는 시간당 5달러다. 하루 쓰면 120달러. 그런데 기본 설정으로 돌리면 GPU의 24%는 그냥 논다. HuggingFace 팀이 CUDA 스트림과 이벤트만으로 이 낭비를 없애는 방법을 공개했다. 모델을 바꿀 필요도, 새 커널을 짤 필요도 없다. ...

2026년 5월 16일 · 4 분 · 720 단어 · TechLLM