언어 모델이 답을 쓰는 도중에 '전체를 볼지, 특정 부분만 볼지, 방금 쓴 내용만 볼지'를 직접 표시하게 해서 긴 문서를 더 싸게 읽게 만드는 방법이다.

언어 모델이 답을 쓰는 도중에 ‘전체를 볼지, 특정 부분만 볼지, 방금 쓴 내용만 볼지’를 직접 표시하게 해서 긴 문서를 더 싸게 읽게 만드는 방법이다. 무엇이 문제였나 — 긴 문서를 다루는 모델은 답의 한 단어를 만들 때마다 앞의 긴 입력을 거의 다시 훑어야 해서 시간이 많이 든다. 어떻게 풀었나 — 이 논문은 모델이 답을 쓰는 중에 , , 같은 표시를 남기게 하고, 실행 시스템이 그 표시에 맞춰 필요한 부분만 읽게 한다. 그래서 뭐가 좋아졌나 — 큰 모델 두 종류에서 15개 긴 문서 과제를 평가했더니 읽어야 하는 양은 31.152.0% 줄었고, 정답률 하락은 1.272.75%p였다. ...
2026년 9월 30일 · 6 분 · 1185 단어 · TechLLM
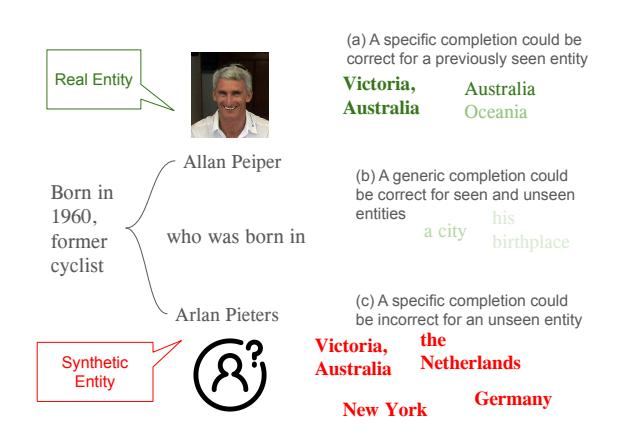
Gricean Retreat 개념도. Known entity에는 specific completion이 맞을 가능성이 높지만, unknown entity에는 specific completion이 틀릴 수 있으므로 less informative but truthful completion으로 후퇴하는 설정을 보여준다.

AI가 모르는 이름을 봤을 때 엉뚱한 세부 정보를 꾸며내지 않고, 아는 범위 안에서 더 넓게 말할 수 있는지 확인한 논문

AI가 모르는 이름을 봤을 때 엉뚱한 세부 정보를 꾸며내지 않고, 아는 범위 안에서 더 넓게 말할 수 있는지 확인한 논문 무엇이 문제였나 — AI는 낯선 사람·회사·제품 이름을 만나도 자신 있게 구체적인 답을 만들 때가 많다. 어떻게 풀었나 — 이 논문은 모델 내부에 ‘이 이름은 낯설다’는 신호와 ‘지금 구체적으로 답하려 한다’는 신호가 있는지 살펴봤다. 그래서 뭐가 좋아졌나 — 결과적으로 두 신호는 있었지만, 실제 답변을 만들 때는 그 신호를 잘 활용하지 못해 틀린 구체 답변을 계속 선호했다. ...

2026년 8월 15일 · 6 분 · 1136 단어 · TechLLM
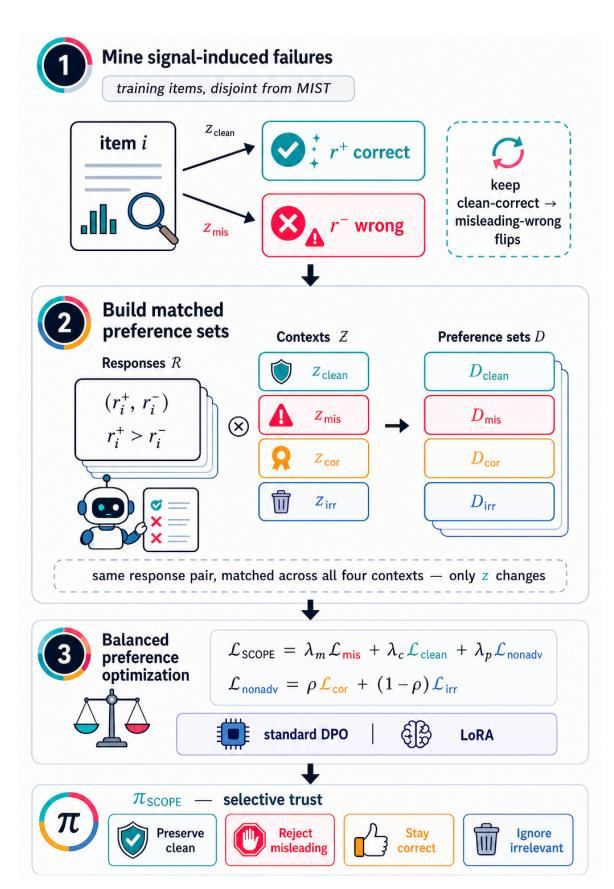
SCOPE 프레임워크 전체 구조: 네 가지 조건의 matched preference 쌍을 구성한 뒤 DPO로 학습한다.

모델이 잘못된 힌트에 휩쓸리지 않으면서, 정확한 힌트는 잘 활용하도록 훈련하는 방법을 제시한 논문

모델이 잘못된 힌트에 휩쓸리지 않으면서, 정확한 힌트는 잘 활용하도록 훈련하는 방법을 제시한 논문 무엇이 문제였나 — AI가 문제를 풀다가 그럴듯하지만 틀린 힌트만 들어와도 답을 바꿔버린다. 23개 모델 모두 평균 17.1포인트 정확도가 떨어졌다. 어떻게 풀었나 — 같은 문제를 힌트 없음/틀린 힌트/맞는 힌트/무관한 힌트 4가지로 만들어, 틀린 힌트에 흔들리지 않으면서 맞는 힌트는 잘 쓰도록 선호 학습을 시켰다. 그래서 뭐가 좋아졌나 — 틀린 힌트로 인한 오답 전환율(SC2W)이 절반 가까이 줄고, 정확한 힌트를 줬을 때 성능은 그대로 유지됐다. ...

2026년 8월 7일 · 5 분 · 954 단어 · TechLLM