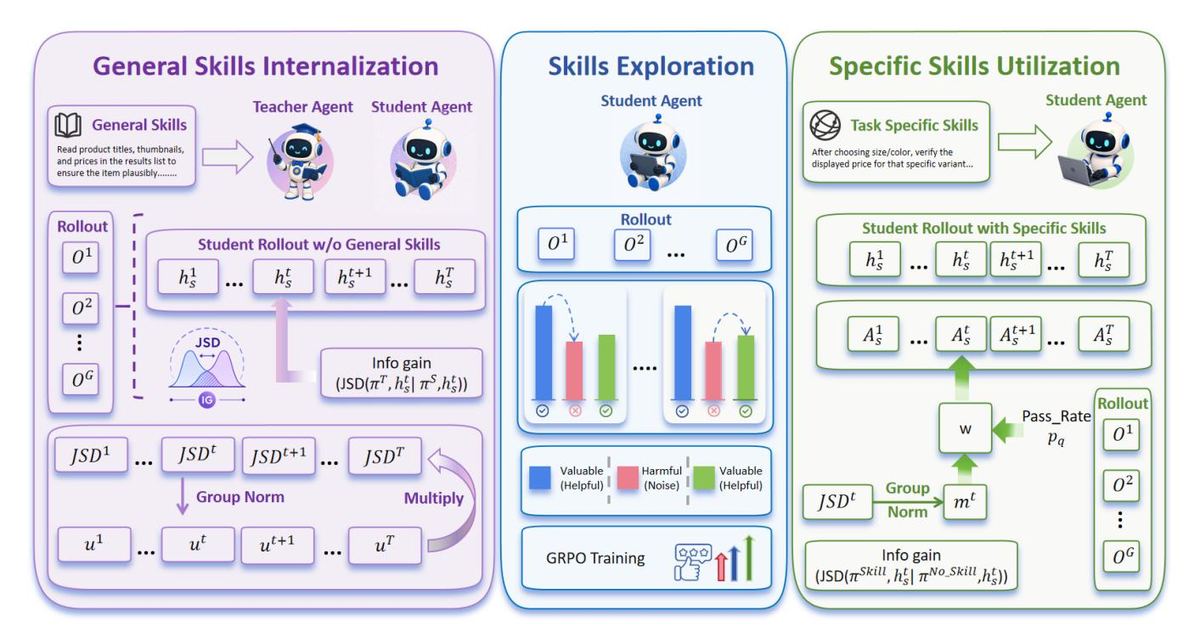
AUSO는 인공지능 에이전트가 '지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?'를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다.
AUSO는 인공지능 에이전트가 ‘지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?‘를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다. 무엇이 문제였나 — 기존 방법은 문제 전체가 성공했는지 실패했는지만 보고, 힌트를 외우는 단계와 힌트를 쓰는 단계를 단순히 갈랐다. 같은 과정 안의 모든 행동이 똑같은 대우를 받아서, 쓸데없는 행동까지 강해질 수 있었다. 어떻게 풀었나 — AUSO는 힌트를 넣었을 때와 뺐을 때 에이전트가 고르는 다음 행동이 얼마나 달라지는지를 수학적으로 잰 뒤, 힌트에 민감한 행동과 둔감한 행동을 구분한다. 민감한 행동은 더 크게 배우고, 방해가 되는 행동은 억제한다. 그래서 뭐가 좋아졌나 — 그 결과, 훈련 때 봤던 문제에서는 성능을 유지하면서 처음 보는 문제에서도 더 높은 성공률을 보였고, 필요 없는 행동이 줄어 한 문제를 끝내는 데 걸리는 단계 수도 짧아졌다. ...