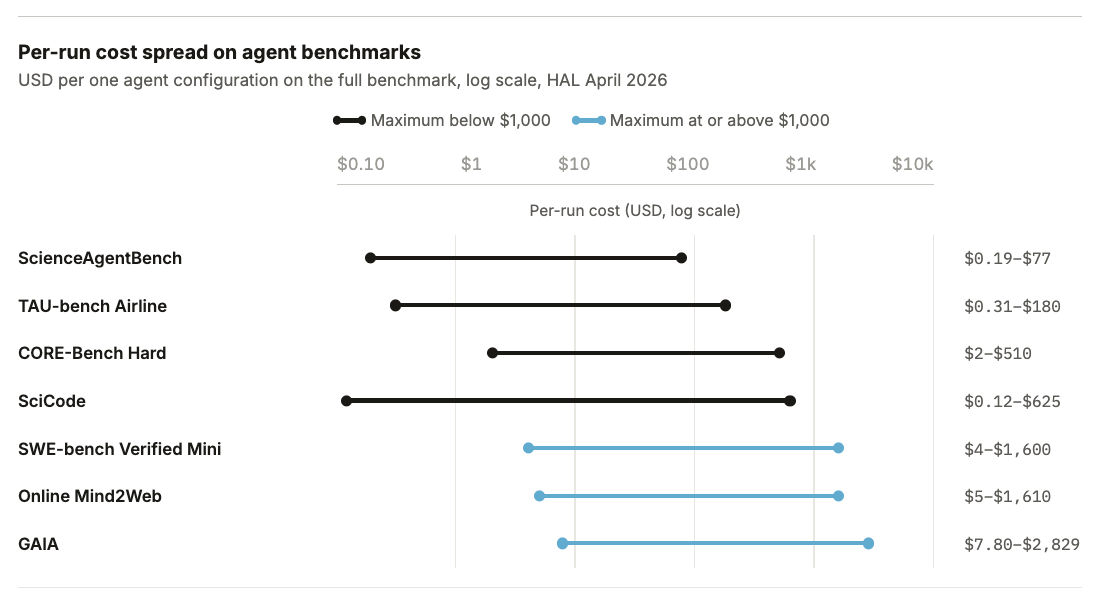
HAL 벤치마크별 에이전트 평가 비용 분포 — 일부 벤치마크는 1회 실행에 $1,000 이상

AI 평가가 새로운 compute 병목이 됐다 — $40,000짜리 벤치마크의 시대

모델을 훈련하는 비용이 문제라고 했다. 이제 평가하는 비용이 문제가 됐다. Holistic Agent Leaderboard(HAL)은 최근 9개 모델, 9개 벤치마크에서 21,730회 에이전트 롤아웃을 실행하는 데 4만 달러를 썼다. GAIA 벤치마크 하나를 최신 모델로 돌리면 캐싱 전 비용이 2,829달러다. PaperBench 1회 평가는 약 9,500달러다. ...
2026년 5월 10일 · 6 분 · 1172 단어 · TechLLM
DeepInfra on Hugging Face Inference Providers

DeepInfra, Hugging Face Inference Provider로 합류하다

DeepInfra가 Hugging Face Inference Provider로 합류했다. HF 토큰 하나로 DeepSeek V4 Pro, Kimi-K2.6 등 100개 이상의 오픈웨이트 모델을 OpenAI 호환 API로 호출할 수 있으며, PRO 플랜은 매월 $2 크레딧을 전체 Provider에서 공유 사용한다.

2026년 5월 7일 · 2 분 · 402 단어 · TechLLM
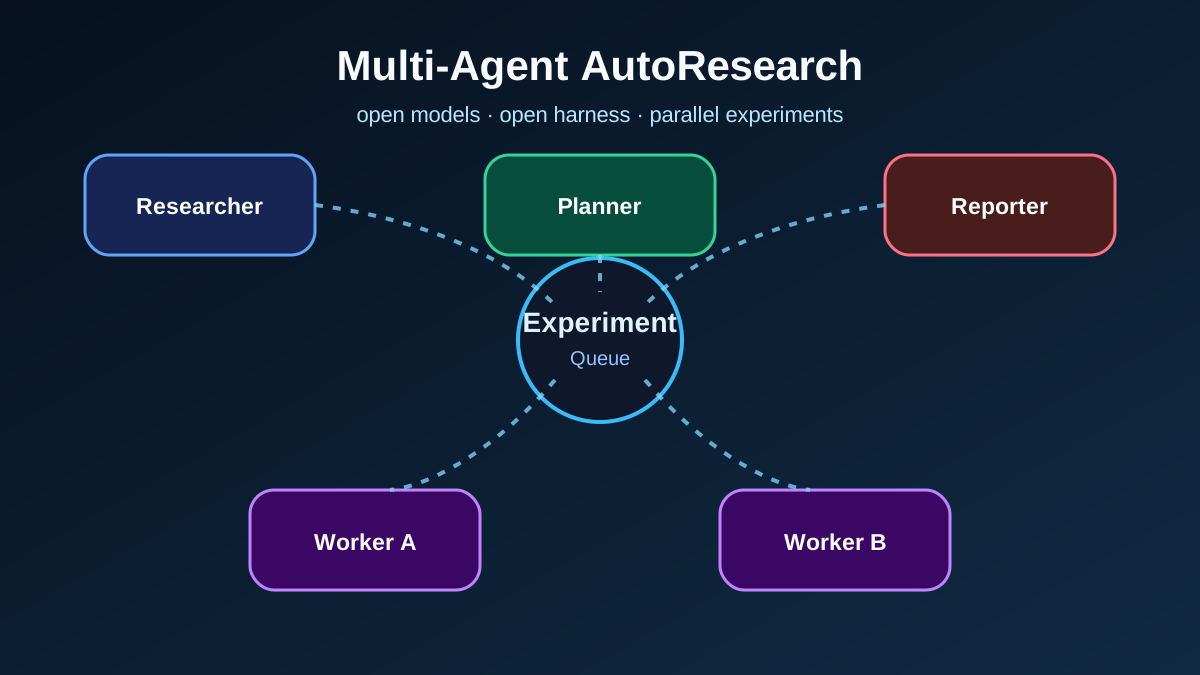
Multi-agent AutoResearch workflow illustration

오픈소스 모델로 AutoResearch를 돌리는 법: 멀티 에이전트 실험실의 가능성

출처: Hugging Face YouTube 문서유형: 영상 해설 #AutoResearch #MultiAgent #OpenSourceModels #OpenCode 핵심 요약 Hugging Face의 영상 **“Multi-Agent AutoResearch with Open Source Models”**는 Andrej Karpathy의 AutoResearch 아이디어를 오픈소스 모델과 오픈소스 코드 하네스인 OpenCode로 재구성한 실험을 보여줍니다. ...

2026년 5월 1일 · 4 분 · 712 단어 · TechLLM