에이전트에게 ZeroGPU를 주면: AI 앱을 자율로 만들고 배포하는 법
개요 월 9달러짜리 HuggingFace PRO 구독 하나가 AI 에이전트에게 GPU 인프라 전체를 쥐여줄 수 있다면? Victor Mustar는 그 조합으로 단 한 번의 에이전트 세션에서 LongCat 영상 아바타 Space를 2시간 만에 만들어 배포했다. 에이전트가 533개의 셸 명령을 실행하며 빌드·진단·수정·검증 루프를 완전히 혼자 돌렸다. ...
개요 월 9달러짜리 HuggingFace PRO 구독 하나가 AI 에이전트에게 GPU 인프라 전체를 쥐여줄 수 있다면? Victor Mustar는 그 조합으로 단 한 번의 에이전트 세션에서 LongCat 영상 아바타 Space를 2시간 만에 만들어 배포했다. 에이전트가 533개의 셸 명령을 실행하며 빌드·진단·수정·검증 루프를 완전히 혼자 돌렸다. ...
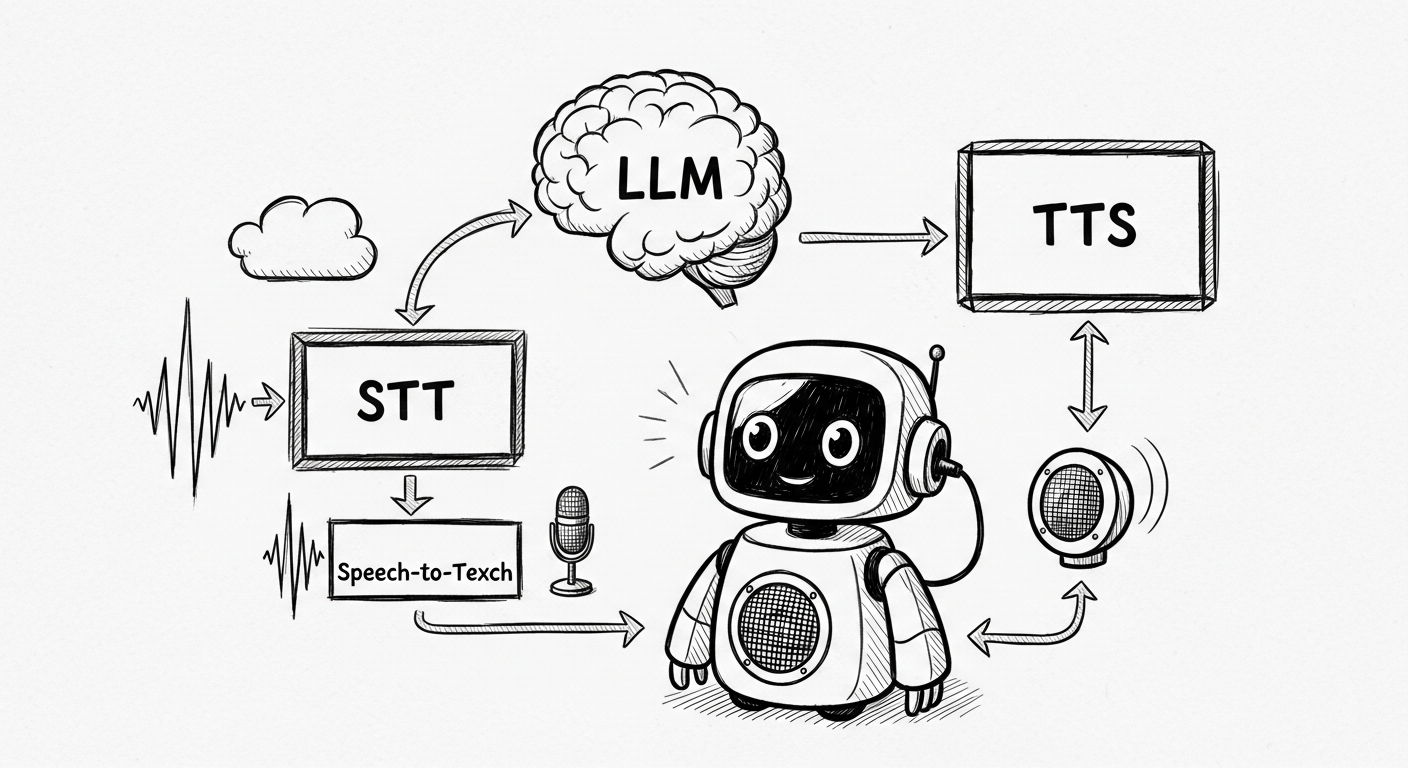
개요 Reachy Mini 로봇의 대화 기능이 완전 로컬로 전환됐다. 기존에는 음성 데이터를 서버로 전송해야 했다. 이제 VAD, STT, LLM, TTS 전 단계가 사용자 기기에서 실행된다. HuggingFace의 speech-to-speech 라이브러리가 캐스케이드 파이프라인을 단일 CLI로 묶었다. 오디오가 네트워크 밖으로 나가지 않고, API 키도 API 비용도 없다. ...
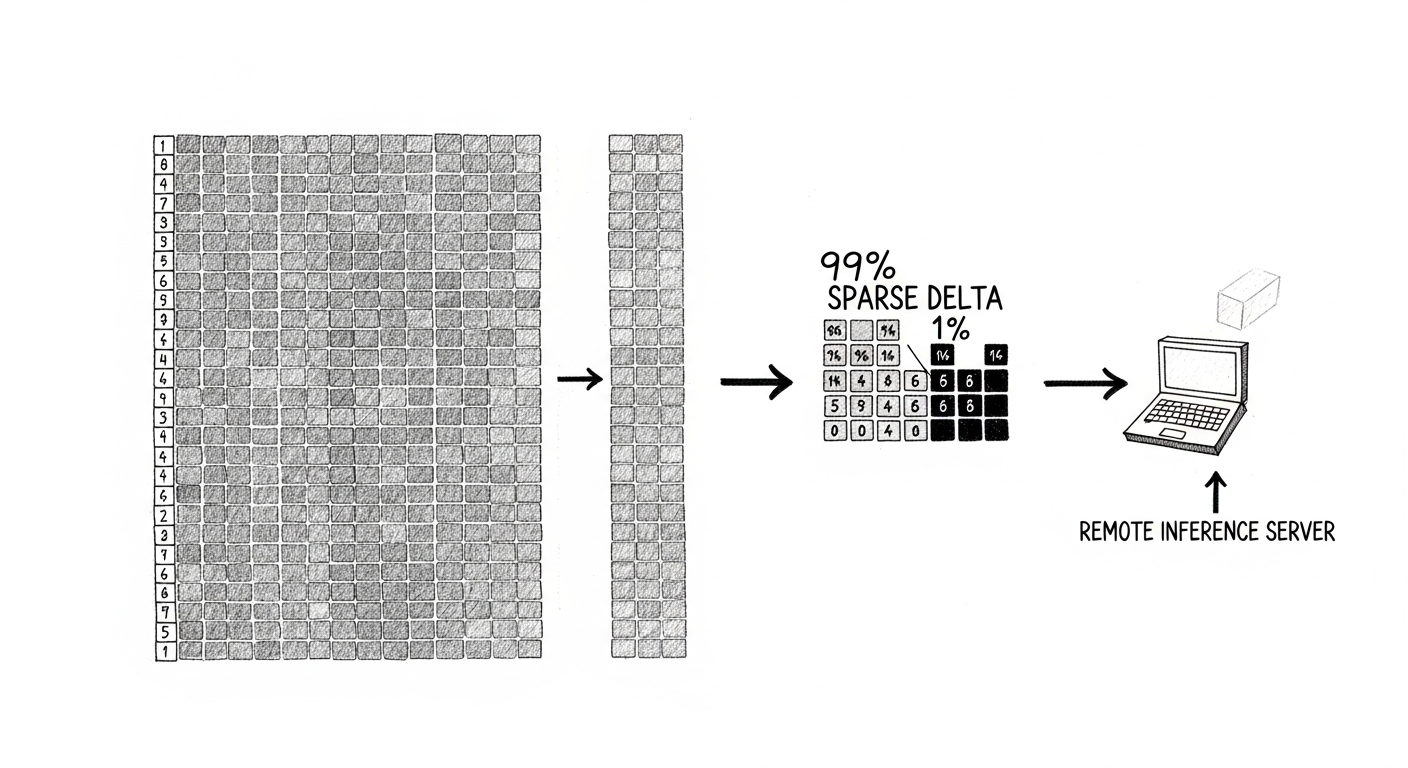
개요 비동기 강화학습(Async RL)에는 근본적인 문제가 있다. 매 최적화 단계마다 업데이트된 모델 가중치를 추론 엔진으로 전송해야 한다. 7B 모델이면 단계당 14GB, 1T 파라미터 모델이면 매 단계 1TB다. 비현실적이다. HuggingFace TRL 팀이 이 문제를 수학적으로 풀었다. BF16 가중치의 99% 이상은 한 옵티마이저 단계에서 실제로 변하지 않는다. 변경된 부분만 희소(sparse) 인코딩으로 전송하면 1.2GB → 20~35MB가 된다. ...
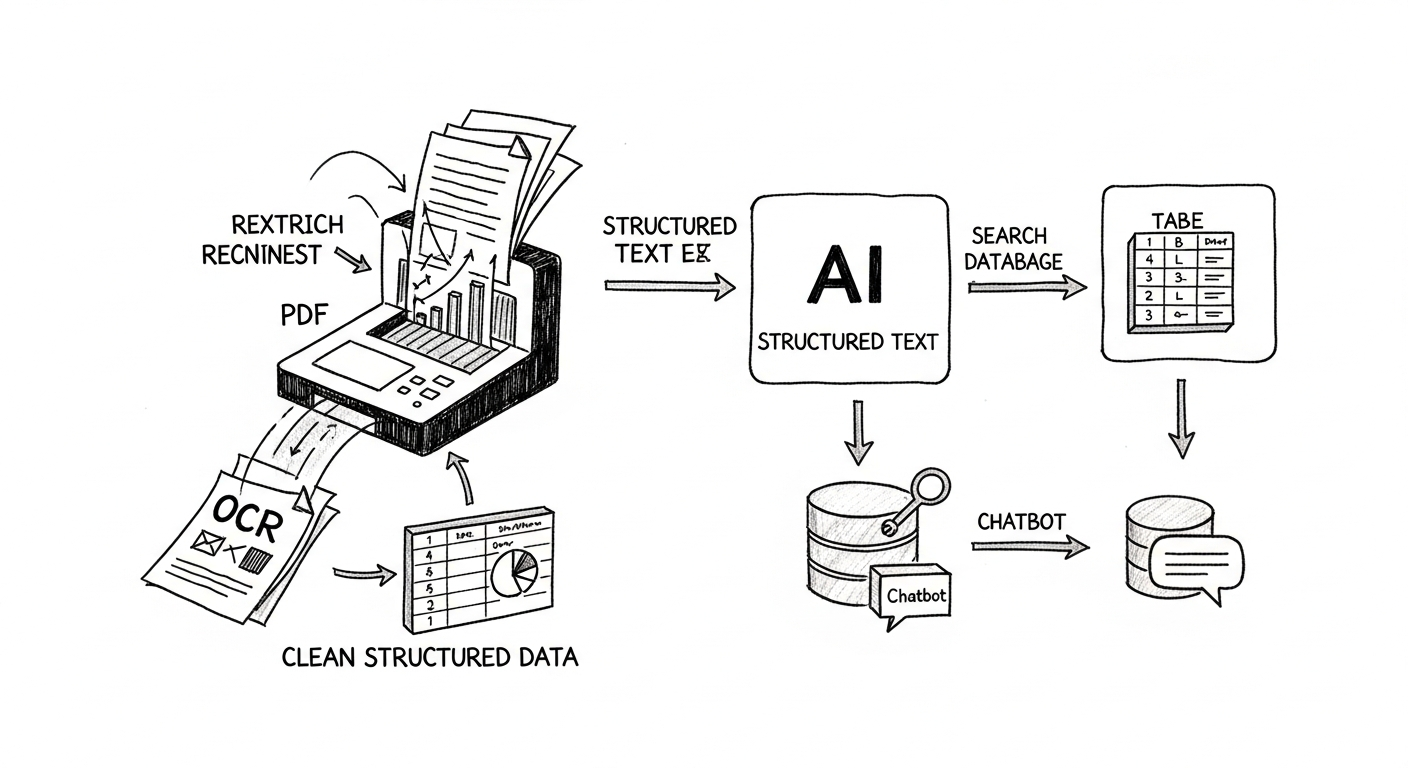
개요 PaddleOCR 3.5가 Hugging Face Transformers를 추론 백엔드로 공식 지원한다. engine="transformers" 파라미터 하나로 기존 PyTorch/Transformers 스택에 OCR과 문서 파싱 기능을 통합할 수 있다. PDF, 스캔 문서, 테이블, 차트 등 복잡한 레이아웃도 처리 가능하다. RAG 파이프라인이나 Document AI 워크플로우에서 문서 수집 품질을 높이려는 팀에게 실용적인 업데이트다. ...
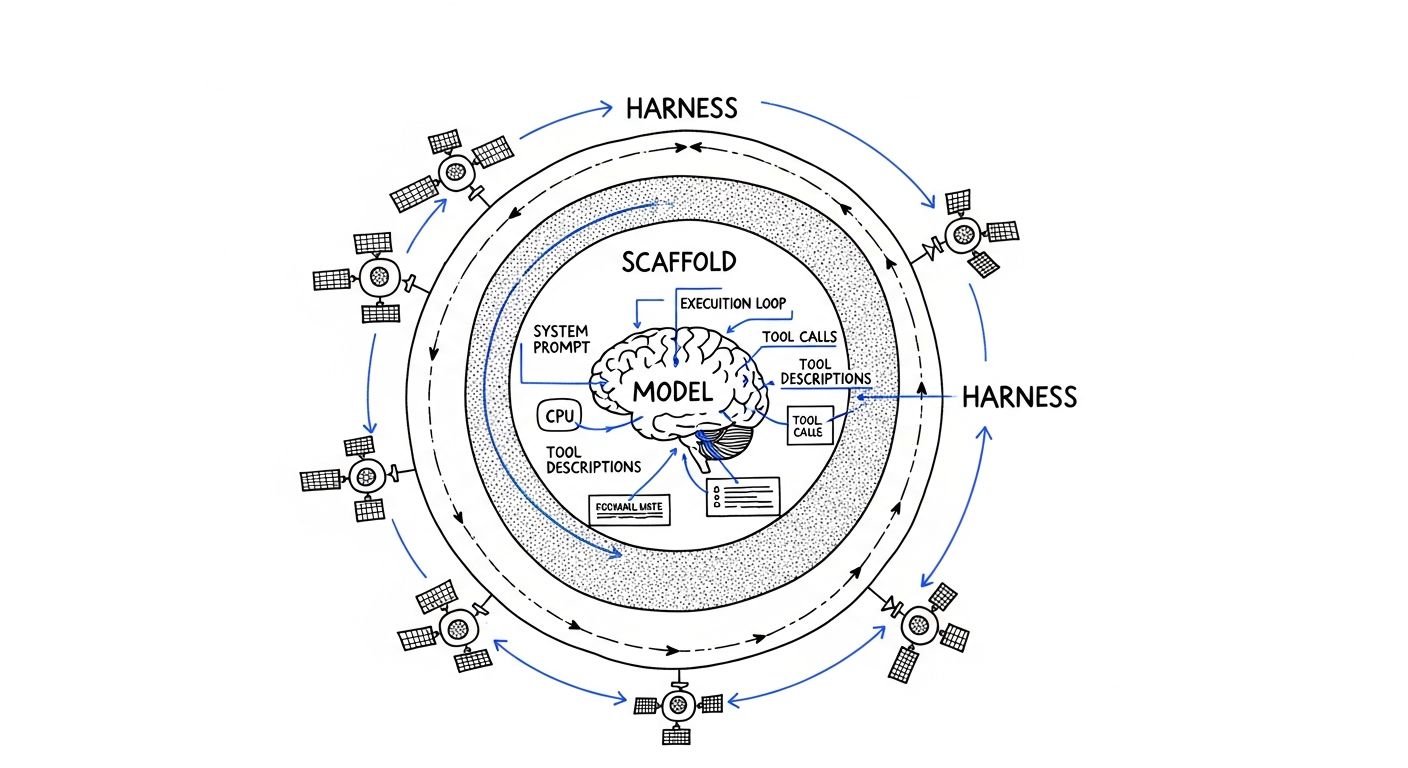
개요 ICLR 2026에서 한 연구자가 던진 질문 하나가 HuggingFace 블로그 포스트의 출발점이 됐다. “에이전트 맥락에서 ‘harness’와 ‘scaffold’가 뭔가요? 컨퍼런스에서 설명을 여러 번 들었는데 하나로 수렴이 안 되더라고요.” AI 에이전트 분야는 기술보다 어휘가 더 빠르게 진화하고 있다. HuggingFace가 현장에서 혼용되는 핵심 용어를 정리했다. ...
개요 코드베이스는 예전부터도 설명하기 어려운 존재였다. 원작자조차 ‘왜 이렇게 짰는지’를 기억하지 못하는 일이 흔했다. 주석, 문서, git blame, 위키, 의사결정 로그 — 수많은 방법을 시도했지만, 결국 모두 누군가가 유지보수해야 한다는 전제가 달렸다. 그리고 그 유지보수는 항상 기능 개발에 밀렸다. ...
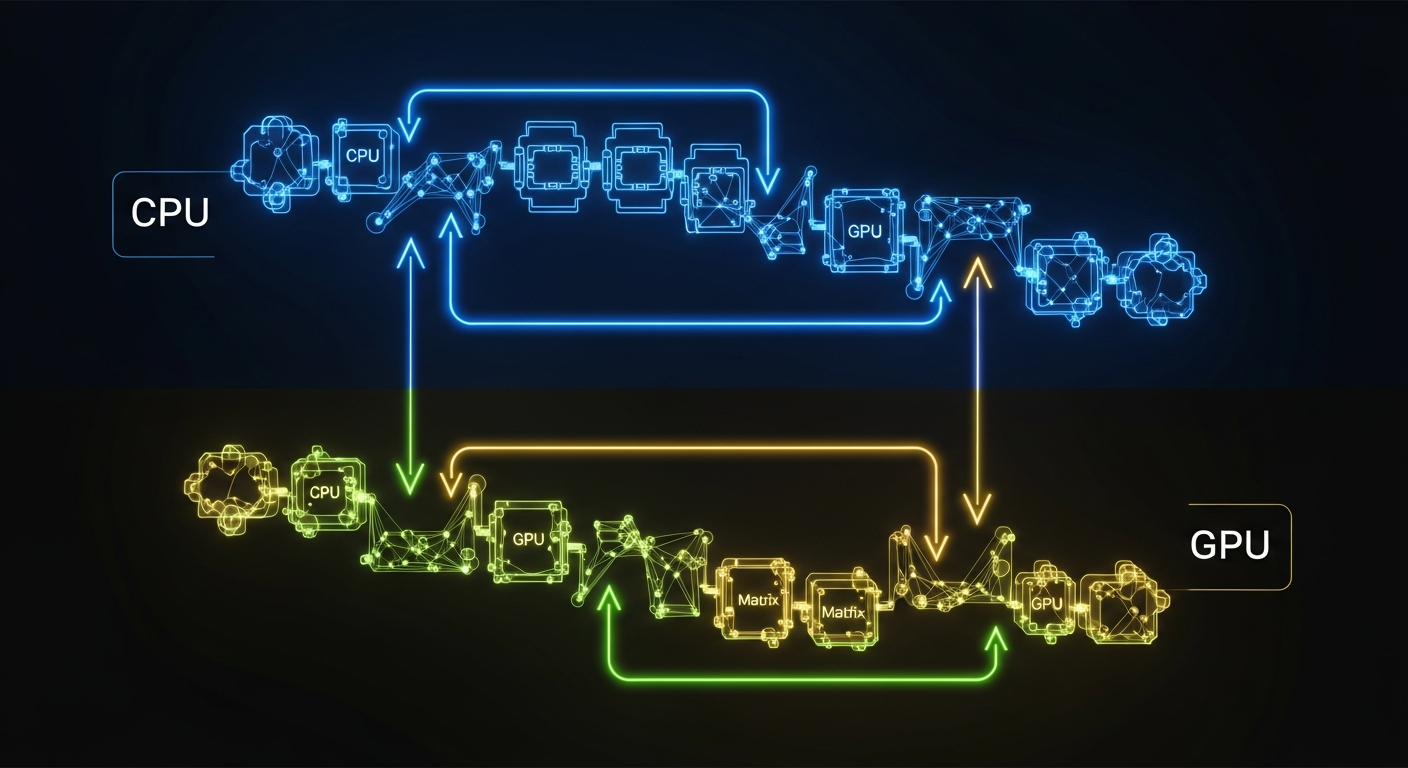
개요 H200 GPU는 시간당 5달러다. 하루 쓰면 120달러. 그런데 기본 설정으로 돌리면 GPU의 24%는 그냥 논다. HuggingFace 팀이 CUDA 스트림과 이벤트만으로 이 낭비를 없애는 방법을 공개했다. 모델을 바꿀 필요도, 새 커널을 짤 필요도 없다. ...
60년간 로봇은 로봇공학자가 만들었다. Hugging Face가 그 전제를 깨는 실험을 시작했다. 핵심 요약 Hugging Face가 오픈소스 데스크톱 로봇 Reachy Mini용 에이전틱 앱스토어를 출시했다 자연어로 원하는 동작을 설명하면 AI 에이전트가 코드 작성·테스트·배포까지 처리한다 출시 후 150명 이상의 제작자가 200개 이상의 앱을 올렸다 — 대부분 로봇 개발 경험 없음 현재 Reachy Mini 누적 출하량은 약 10,000대, 다음 30일 내 1,000대 추가 예정 전체 스택(하드웨어·소프트웨어·앱·에이전트 트레이스)이 오픈소스 어떻게 작동하는가 워크플로는 간단하다. 에이전트에게 이렇게 말한다. ...
에이전트가 코드를 짜고, 이슈를 찾고, PR까지 열어준다. 좋아 보인다. 그런데 오픈소스 메인테이너들은 지금 곤혹스럽다. PR이 10배 늘었는데, 대부분 쓸 수 없는 것들이다. HuggingFace가 이 문제를 정면으로 파고든 글을 2026년 4월 공개했다. transformers 모델을 Apple Silicon용 MLX 프레임워크로 포팅하는 AI 스킬을 만들면서, 에이전트 시대 오픈소스 기여가 어때야 하는지 기준을 제시했다. ...