통신망 장애 원인을 찾을 때 AI가 숫자 몇 개만 보고 성급히 답하지 않도록, 데이터를 정해진 칸에 정리하고 단계별 점검을 거쳐 결론을 내리게 훈련한 방법이다.

통신망 장애 원인을 찾을 때 AI가 숫자 몇 개만 보고 성급히 답하지 않도록, 데이터를 정해진 칸에 정리하고 단계별 점검을 거쳐 결론을 내리게 훈련한 방법이다. 무엇이 문제였나 — 통신 장애 원인을 찾으려면 속도, 무선 신호 세기, 자원 할당량, 기지국 설정, 이웃 셀 상태 같은 여러 정보를 함께 봐야 한다. 어떻게 풀었나 — 이 논문은 그런 정보를 매번 같은 형식으로 정리하고, AI가 ‘차량 속도가 너무 빠른가?’, ‘무선 자원이 부족한가?’, ‘핸드오버가 잦은가?’ 같은 점검을 먼저 하게 만든다. 그래서 뭐가 좋아졌나 — 그 결과 5G 드라이브 테스트 데이터에서는 정확도 94.2%, 별도 관측 데이터에서는 64.7%를 기록해 일반 LLM 프롬프트나 단순 fine-tuning보다 훨씬 좋은 성능을 보였다. ...
2026년 10월 13일 · 6 분 · 1102 단어 · TechLLM
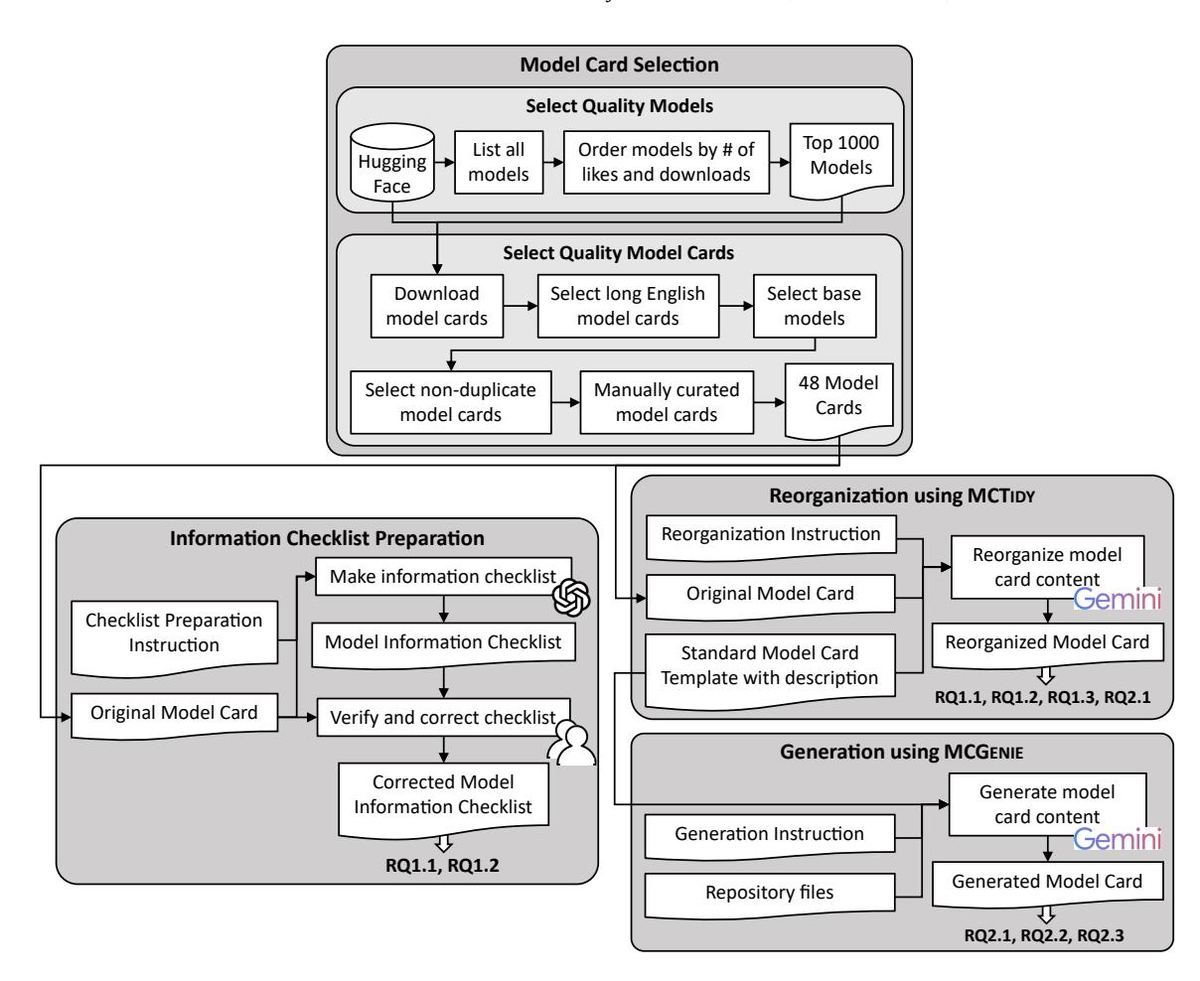
전체 연구 파이프라인: 944,178개 후보 → 다단계 필터링 → 48개 베이스 모델 선정 → MCTidy 재배치 → MCGenie 생성 → 평가

AI 모델의 사용 설명서(모델 카드)를 LLM이 자동으로 정리하거나 처음부터 새로 써주는 두 가지 방법을 제안한 논문이다.

AI 모델의 사용 설명서(모델 카드)를 LLM이 자동으로 정리하거나 처음부터 새로 써주는 두 가지 방법을 제안한 논문이다. 무엇이 문제였나 — 공개된 AI 모델들이 사용하는 설명서(모델 카드)가 양식도 제각각이고 아예 없는 경우도 많아, 어떤 모델을 어떻게 써야 안전한지 비교하기 어려웠다. 어떻게 풀었나 — 기존 모델 카드를 표준 양식으로 자동 재배치하는 MCTidy와, 저장소 파일·논문만 읽고 새 모델 카드를 자동 생성하는 MCGenie 두 시스템을 만들었다. 그래서 뭐가 좋아졌나 — 48개 모델 평가에서 정보 손실은 4.5% 수준으로 미미했고, 섹션 배치는 98.1% 정확했고, 자동 생성 카드의 절반 이상은 사실 오류가 없는 완성형으로 나왔다. ...

2026년 8월 27일 · 6 분 · 1229 단어 · TechLLM
언어 모델 내부의 연결 구조를 현미경처럼 들여다보는 Anthropic 연구 이미지

Anthropic이 Claude의 생각을 추적해 발견한 것들

출처: Anthropic 문서유형: 번역·해설 #Anthropic #Claude #Interpretability #AI안전 #LLM 핵심 요약 Anthropic은 Claude 3.5 Haiku 내부를 들여다보는 회로 추적(circuit tracing) 연구를 공개했습니다. 결론은 꽤 흥미롭습니다. Claude는 단순히 다음 단어만 맞히는 기계가 아니라, 언어를 넘는 공통 개념 공간을 쓰고, 몇 단어 뒤를 미리 계획하며, 때로는 실제 계산 없이 그럴듯한 설명을 만들어낼 수 있습니다. ...

2026년 4월 30일 · 3 분 · 483 단어 · TechLLM