한 회사에서 200개 넘는 서비스에 쓰던 여러 AI 모델을, 약한 부분만 따로 키운 뒤 하나로 합쳐서, 7배 큰 모델과 비슷한 품질을 더 싸게 쓰게 만든 방법.

한 회사에서 200개 넘는 서비스에 쓰던 여러 AI 모델을, 약한 부분만 따로 키운 뒤 하나로 합쳐서, 7배 큰 모델과 비슷한 품질을 더 싸게 쓰게 만든 방법. 무엇이 문제였나 — 한정된 GPU 풀에서 서비스마다 다른 AI 모델을 따로 돌리느라 비싸고 관리가 어려웠다. 어떻게 풀었나 — 약한 영역(지시 따르기, 도구 사용, 내부 분포)마다 강화학습으로 전문가를 따로 키우고, 가중치를 섞어 하나의 모델로 합쳤다. 그래서 뭐가 좋아졌나 — 7배 큰 모델과 비슷한 점수를 내면서 116M 요청/월을 50% 처리하고, 서버 비용을 2.8~3.9배 줄였다. ...
2026년 10월 14일 · 6 분 · 1157 단어 · TechLLM

AI가 논문에 인용을 붙일 때, 단어가 비슷한 논문이 아니라 그 문장을 실제로 뒷받침하는 논문을 고르게 만든 연구다.

AI가 논문에 인용을 붙일 때, 단어가 비슷한 논문이 아니라 그 문장을 실제로 뒷받침하는 논문을 고르게 만든 연구다. 무엇이 문제였나 — 문제: 기존 인용 추천은 실제 존재하는 논문을 가져오더라도, 그 논문이 문장의 주장을 제대로 뒷받침하지 못하는 경우가 많았다. 어떻게 풀었나 — 해결: ReCite는 먼저 인용이 필요한 위치를 찾고, 왜 인용이 필요한지 파악한 뒤, 후보 논문이 그 주장과 논리적으로 맞는지 확인한다. 맞지 않으면 검색어를 고쳐 다시 찾는다. 그래서 뭐가 좋아졌나 — 효과: 4B 규모 모델로 strict F1 39.15%, lenient F1 55.14%를 기록해 훨씬 큰 생성 모델과 일반 에이전트보다 좋은 인용 정확도를 보였다. ...

2026년 9월 20일 · 5 분 · 1004 단어 · TechLLM
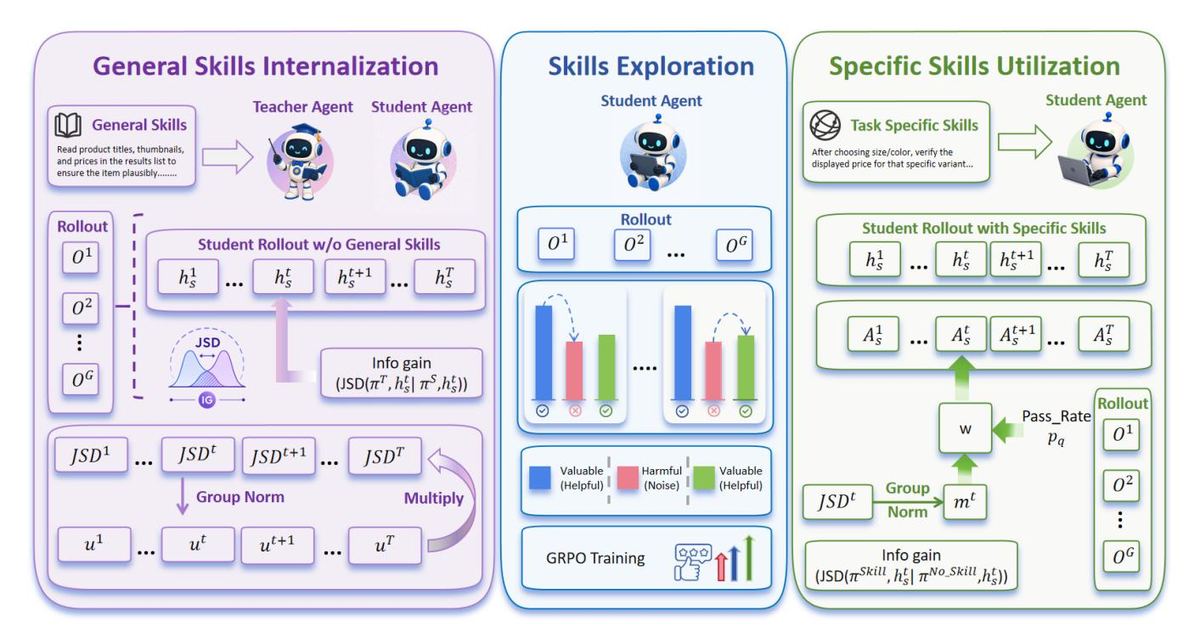
AUSO의 3단계 파이프라인 — General Skills Internalization → Skills Exploration(GRPO) → Specific Skill Utilization — 전체 구조 요약도

AUSO는 인공지능 에이전트가 '지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?'를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다.

AUSO는 인공지능 에이전트가 ‘지금 이 힌트가 내 다음 행동을 진짜로 바꾸고 있나?‘를 매 순간 따져 보고, 정말 도움이 된 행동만 더 강하게 익히게 하는 훈련법이다. 무엇이 문제였나 — 기존 방법은 문제 전체가 성공했는지 실패했는지만 보고, 힌트를 외우는 단계와 힌트를 쓰는 단계를 단순히 갈랐다. 같은 과정 안의 모든 행동이 똑같은 대우를 받아서, 쓸데없는 행동까지 강해질 수 있었다. 어떻게 풀었나 — AUSO는 힌트를 넣었을 때와 뺐을 때 에이전트가 고르는 다음 행동이 얼마나 달라지는지를 수학적으로 잰 뒤, 힌트에 민감한 행동과 둔감한 행동을 구분한다. 민감한 행동은 더 크게 배우고, 방해가 되는 행동은 억제한다. 그래서 뭐가 좋아졌나 — 그 결과, 훈련 때 봤던 문제에서는 성능을 유지하면서 처음 보는 문제에서도 더 높은 성공률을 보였고, 필요 없는 행동이 줄어 한 문제를 끝내는 데 걸리는 단계 수도 짧아졌다. ...

2026년 8월 25일 · 7 분 · 1295 단어 · TechLLM
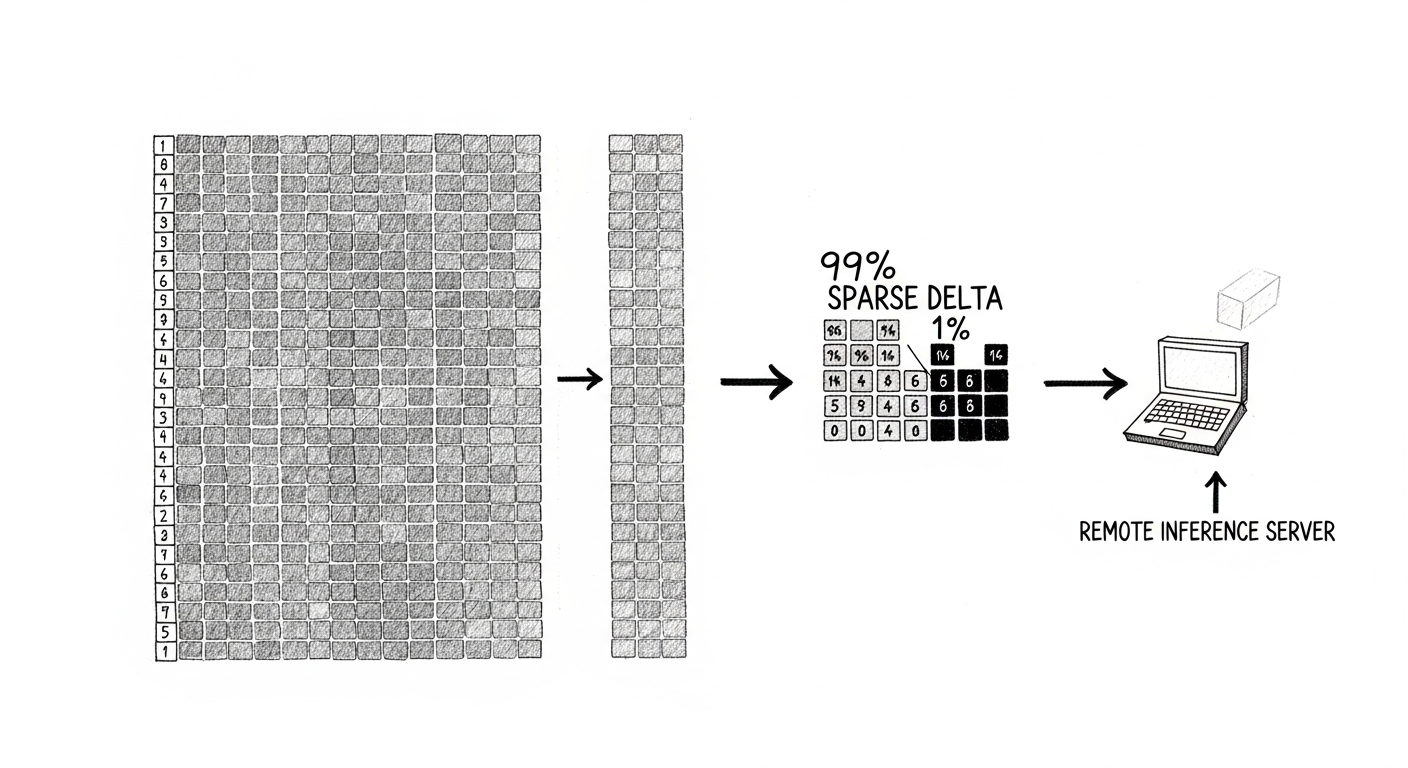
모델 가중치 변화를 희소 벡터로 인코딩해 전송하는 과정을 표현한 핸드드로잉 일러스트

Delta Weight Sync — 1TB 모델도 초당 동기화하는 비동기 RL 트릭

개요 비동기 강화학습(Async RL)에는 근본적인 문제가 있다. 매 최적화 단계마다 업데이트된 모델 가중치를 추론 엔진으로 전송해야 한다. 7B 모델이면 단계당 14GB, 1T 파라미터 모델이면 매 단계 1TB다. 비현실적이다. HuggingFace TRL 팀이 이 문제를 수학적으로 풀었다. BF16 가중치의 99% 이상은 한 옵티마이저 단계에서 실제로 변하지 않는다. 변경된 부분만 희소(sparse) 인코딩으로 전송하면 1.2GB → 20~35MB가 된다. ...

2026년 5월 27일 · 4 분 · 668 단어 · TechLLM