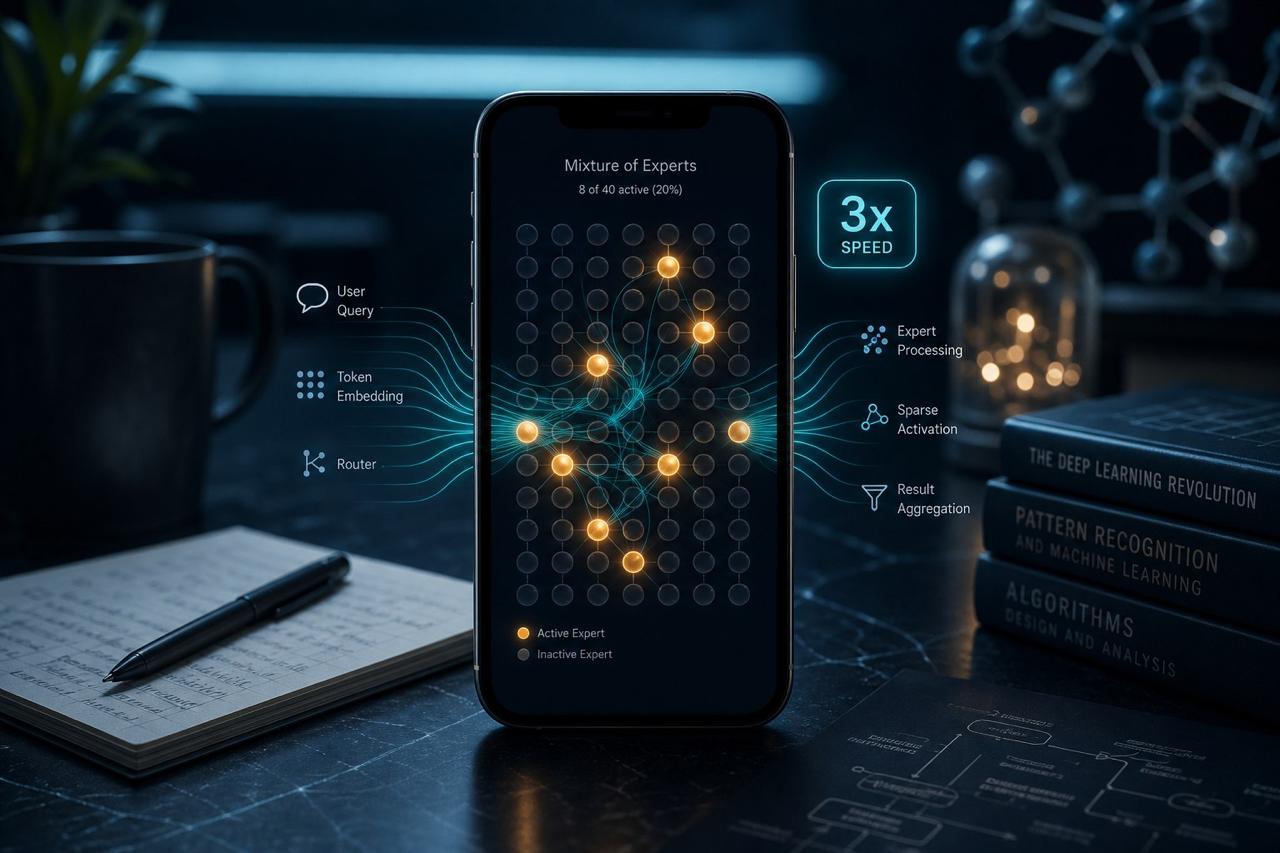
핵심 요약 새로 공개된 DECO는 sparse MoE를 dense Transformer 성능에 매칭시키는 아키텍처다 — 동일 total parameter 예산·학습 토큰 조건에서. 핵심은 세 가지: ① 학습 가능한 expert-wise scaling이 결합된 ReLU 기반 라우팅, ② SiLU 앞에 normalize를 두는 NormSiLU 활성화, ③ non-gated MLP expert + ReLU 라우팅 조합. 전체 expert 중 20%만 활성화해도 dense 모델 성능을 따라잡고, 기존 MoE baseline을 능가했다. 전용 가속 커널 적용 시 실제 하드웨어에서 dense 추론 대비 3.00× speedup. 코드와 체크포인트가 공개 예정이라 온디바이스 LLM에 MoE를 진지하게 적용해볼 첫 실용적 후보가 될 가능성이 있다. MoE는 왜 온디바이스에서 잘 안 됐나 Mixture-of-Experts(MoE)는 LLM 효율화의 단골 후보다. 전체 capacity는 크게, 한 번 추론에 쓰는 계산은 작게. 클라우드 환경에서는 이 트레이드오프가 매력적이지만, 휴대폰·노트북·임베디드 같은 end-side(온디바이스) 환경으로 옮기면 다른 문제가 튀어나온다.
...