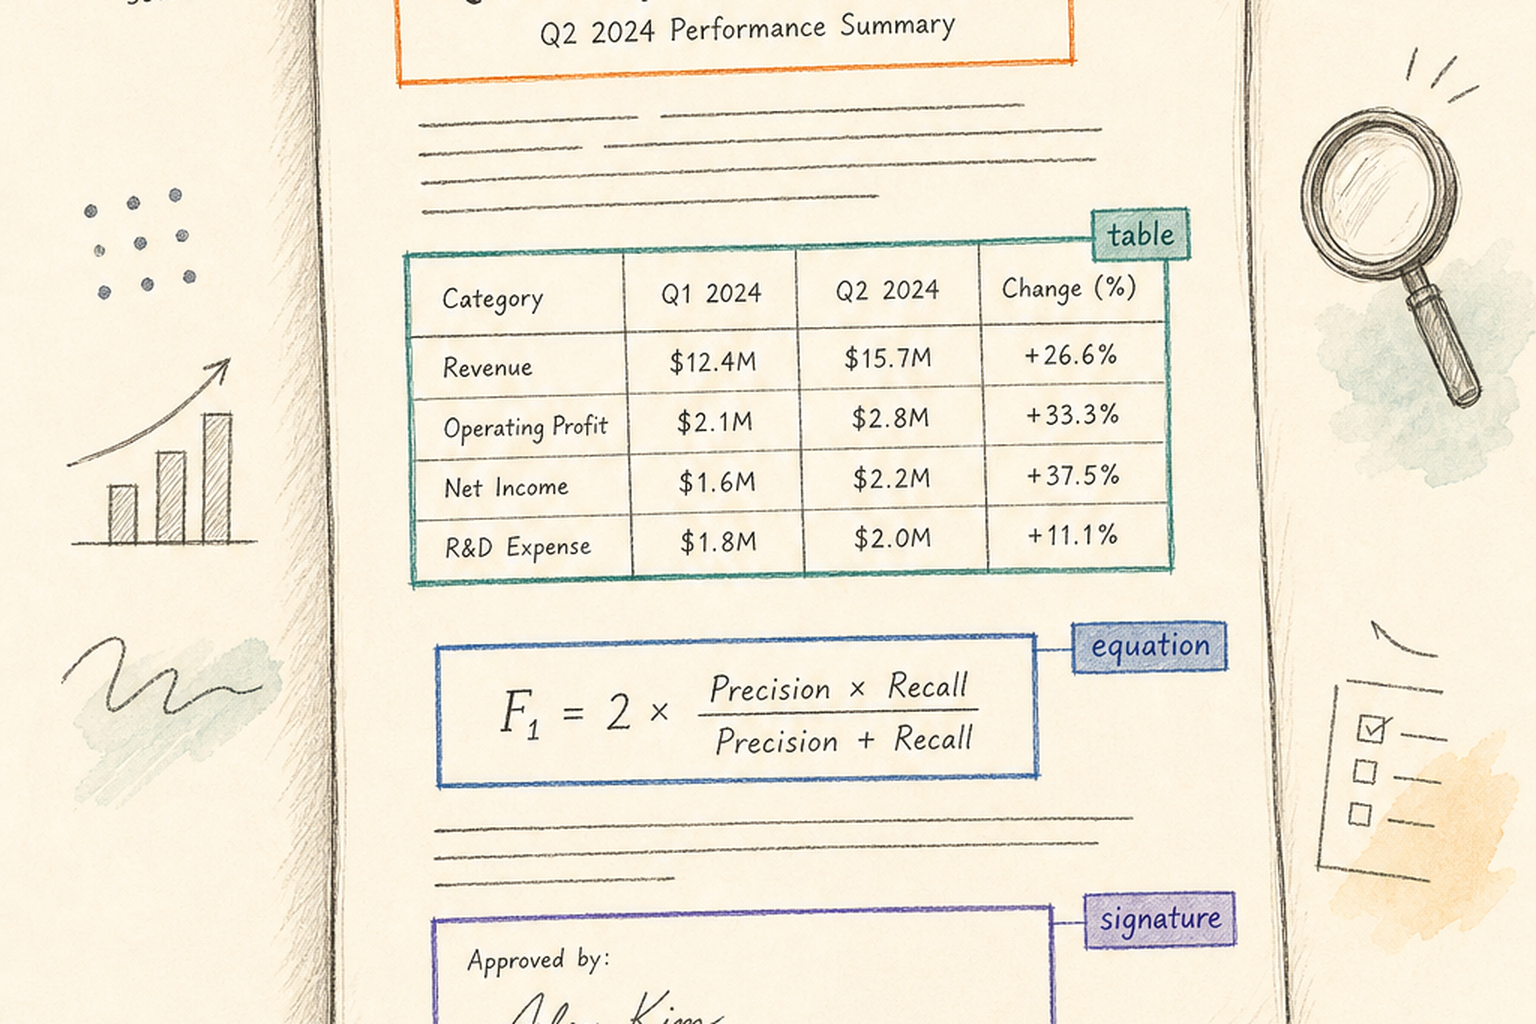
Mistral OCR 4가 문서를 스캔하면서 바운딩 박스와 블록 분류, 신뢰도를 함께 출력하는 모습

Mistral OCR 4: 위치·블록·신뢰도까지 같이 주는 OCR — RAG와 에이전트 파이프라인을 위한 인용 가능 구조화 출력

개요 문서에서 글자만 뽑아 주던 시대는 끝나가는 것 같습니다. Mistral이 6월 23일 공개한 OCR 4는 한 문서를 통째로 “구조"로 돌려줍니다. 어디에 무엇이 있고(바운딩 박스), 그 덩어리는 어떤 종류이며(제목·문단·표·수식·서명·그림), 모델이 얼마나 확신하는지(페이지·단어별 신뢰도)까지 같이 나옵니다. 그냥 보기 좋은 결과물이 아니라, RAG에 그대로 넣어도 인용이 되는 입력을 만들겠다는 설계입니다. ...
2026년 6월 24일 · 6 분 · 1112 단어 · TechLLM
에이전트가 여러 도구 카탈로그 사이를 가로질러 필요한 스킬을 직접 골라내는 일러스트

허깅페이스 ARD 공개 — 에이전트가 도구를 직접 검색하는 시대

개요 지금까지 에이전트에게 도구를 붙이는 방식은 늘 “먼저 설치하고 나중에 부른다” 였습니다. 개발자가 설정 파일에 URL을 박아 넣고, 사용자가 플러그인 메뉴에서 일일이 연결해 주고, 그 결과를 모두 LLM의 컨텍스트 창에 욱여넣어 모델이 알아서 고르게 하는 구조였죠. ...

2026년 6월 18일 · 4 분 · 688 단어 · TechLLM
Reflective prompt optimization with GEPA

GEPA로 짓는 반사형 프롬프트 최적화: 다중 컴포넌트 + 구조화 피드백 + 홀드아웃 검증

개요 수동 프롬프트 튜닝은 끝이 없다. 한 줄 고치고 돌려보고, 또 한 줄 고치고 다시 돌리고. MarkTechPost가 6월 7일 공개한 GEPA 튜토리얼은 그 루프를 LLM 두 대와 점수 함수에 떠넘긴다. 약한 작업 모델은 풀고, 강한 리플렉션 모델은 프롬프트를 고친다. 사람은 평가 기준만 정확히 적어주면 된다. ...

2026년 6월 8일 · 4 분 · 645 단어 · TechLLM
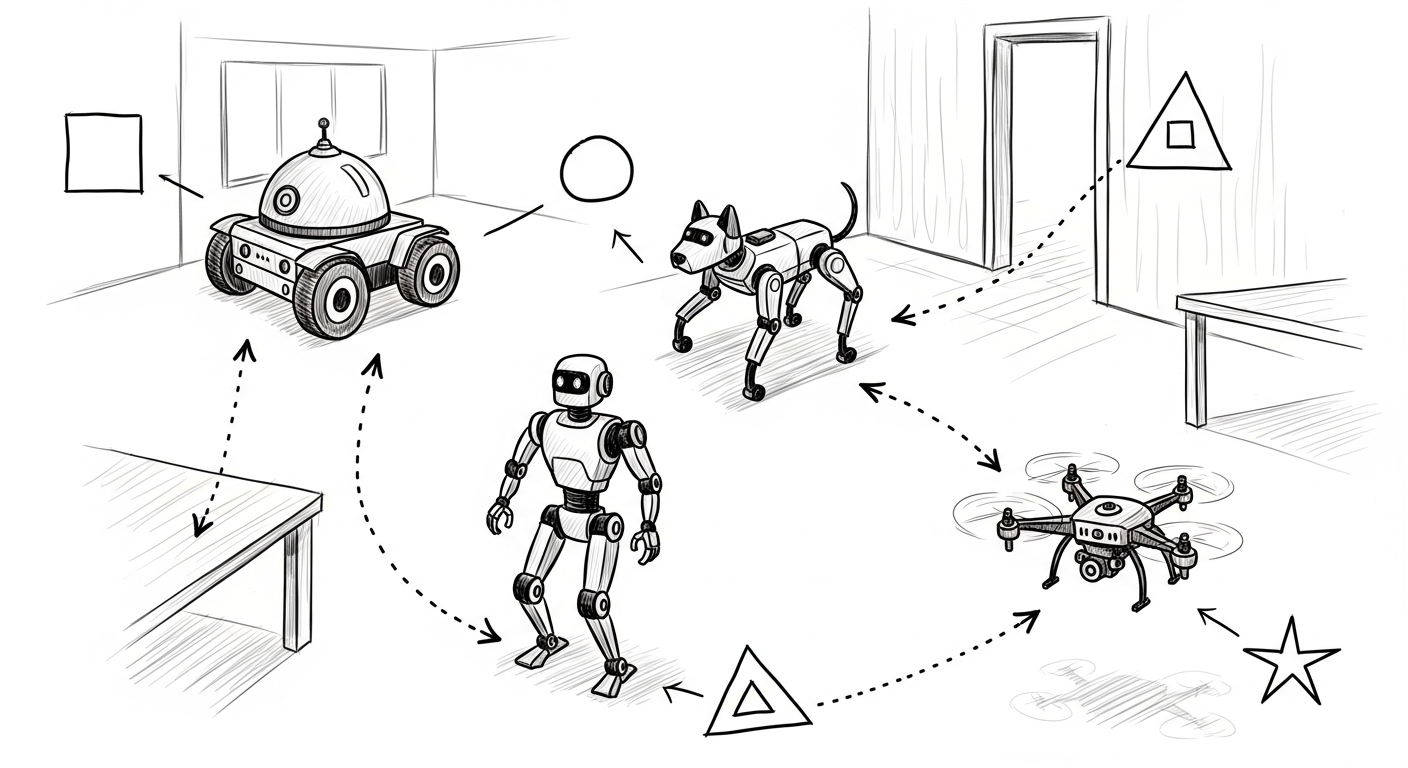
네 종류 로봇이 자연어 명령으로 복잡한 환경을 탐색하는 핸드드로잉 스타일 일러스트

Uni-LaViRA — 언어·비전·로봇 행동을 하나로 묶는 제로샷 체화 항법

개요 항법(Navigation)에는 특수한 성질이 있다. 목적지까지 가는 결정 구조가 언어 방향 명령과 픽셀 수준 시각 타깃이라는 두 출력으로 환원된다. 이 두 출력은 사전 학습된 MLLM의 자연 출력 공간 안에 있다. 즉, 로봇 데이터로 학습하지 않아도 추론으로 풀 수 있다. Uni-LaViRA는 이 통찰을 네 가지 과제 군과 네 종류 실제 로봇에 동시에 적용한 통합 에이전트 아키텍처다. ...

2026년 5월 28일 · 3 분 · 602 단어 · TechLLM
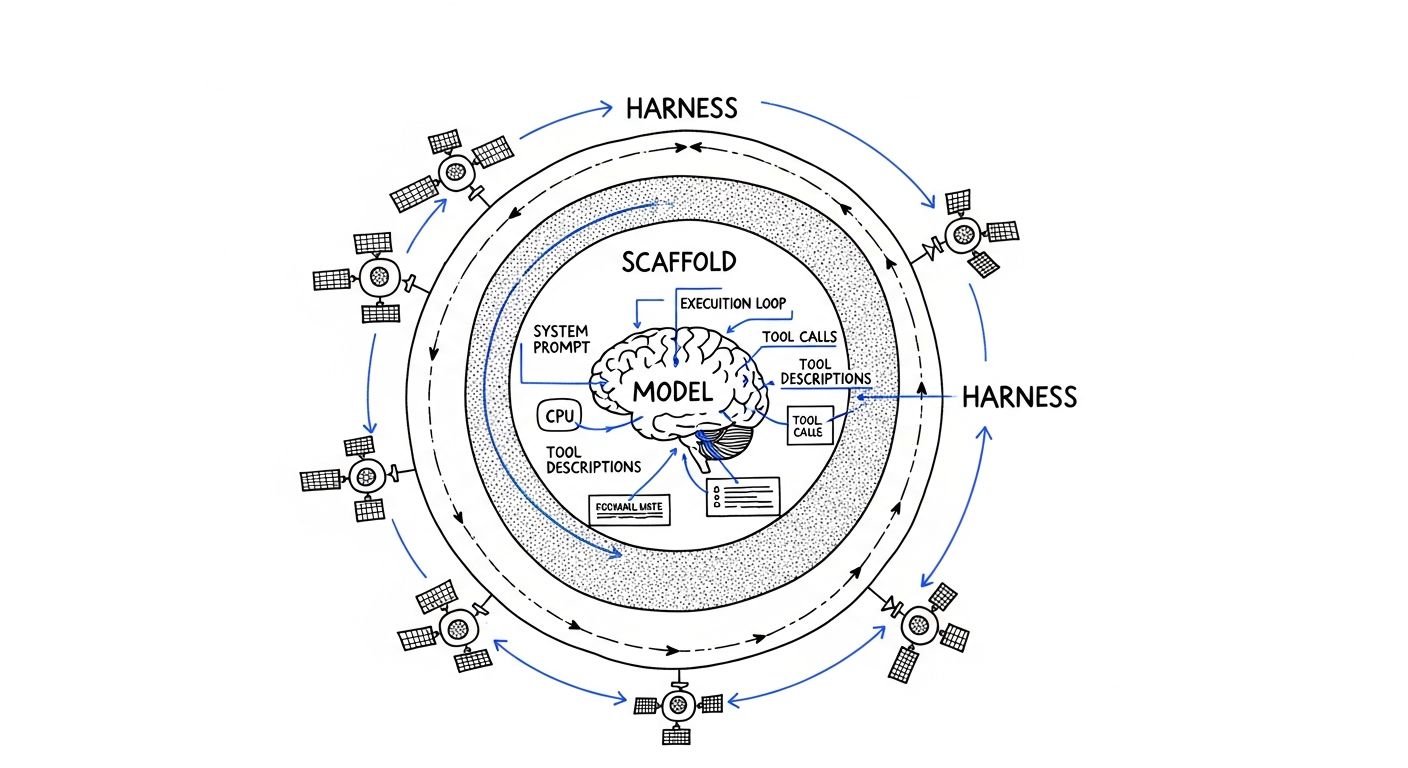
AI 에이전트 구성 요소를 도식화한 핸드드로잉 스타일 일러스트

AI 에이전트 용어 완전 정리 — 하네스·스캐폴드·오케스트레이터, 이제 헷갈리지 말자

개요 ICLR 2026에서 한 연구자가 던진 질문 하나가 HuggingFace 블로그 포스트의 출발점이 됐다. “에이전트 맥락에서 ‘harness’와 ‘scaffold’가 뭔가요? 컨퍼런스에서 설명을 여러 번 들었는데 하나로 수렴이 안 되더라고요.” AI 에이전트 분야는 기술보다 어휘가 더 빠르게 진화하고 있다. HuggingFace가 현장에서 혼용되는 핵심 용어를 정리했다. ...

2026년 5월 27일 · 4 분 · 720 단어 · TechLLM

Claude Code의 /goal 슬래시 커맨드 — 완료 조건이 충족될 때까지 자동으로 일하게 하는 법

Claude Code 사용자라면 한 번쯤 이런 순간을 만납니다. “테스트 다 통과시킬 때까지 그냥 알아서 해줬으면 좋겠는데” 같은 작업. 한 턴에 끝낼 수 없고, 그렇다고 매 턴 직접 다음 단계를 지시하기엔 번거로운 일들. Anthropic이 이 갭을 정확히 메우는 명령어를 추가했습니다. 바로 /goal 슬래시 커맨드입니다. ...

2026년 5월 13일 · 5 분 · 1044 단어 · TechLLM
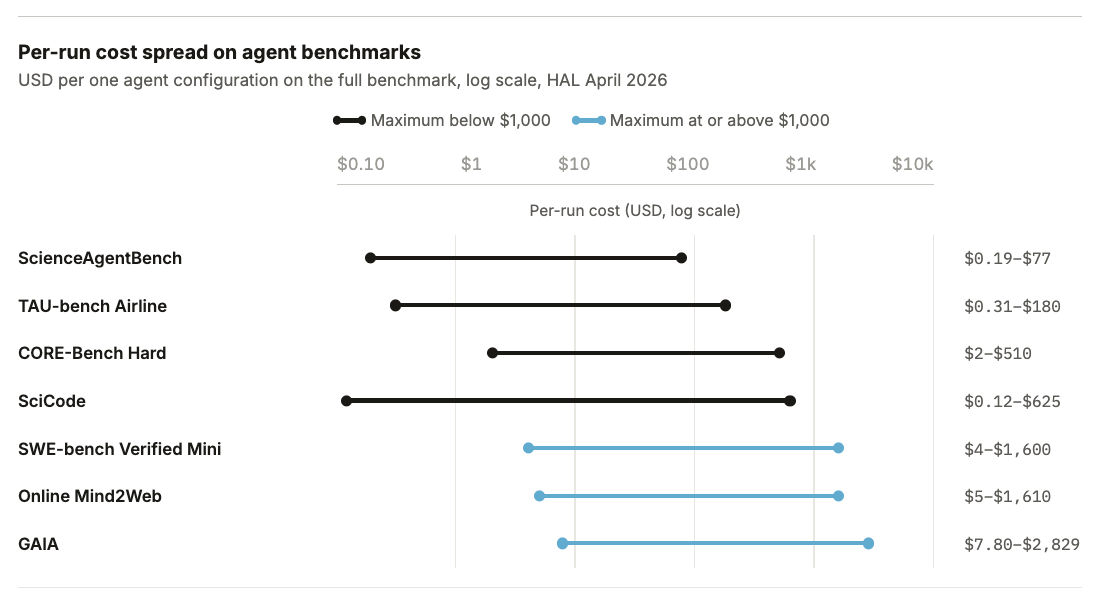
HAL 벤치마크별 에이전트 평가 비용 분포 — 일부 벤치마크는 1회 실행에 $1,000 이상

AI 평가가 새로운 compute 병목이 됐다 — $40,000짜리 벤치마크의 시대

모델을 훈련하는 비용이 문제라고 했다. 이제 평가하는 비용이 문제가 됐다. Holistic Agent Leaderboard(HAL)은 최근 9개 모델, 9개 벤치마크에서 21,730회 에이전트 롤아웃을 실행하는 데 4만 달러를 썼다. GAIA 벤치마크 하나를 최신 모델로 돌리면 캐싱 전 비용이 2,829달러다. PaperBench 1회 평가는 약 9,500달러다. ...

2026년 5월 10일 · 6 분 · 1172 단어 · TechLLM
AI Agent 모델 선택과 워크플로우를 다루는 TechLLM 블로그 대표 이미지

AI Agent 활용을 위한 모델 선택, 정말 그렇게 중요할까

출처: TechLLM 문서유형: 블로그 포스트 #AI #AIAgent #모델선택 #LLM #에이전트 #프롬프트엔지니어링 #워크플로우 #생산성 핵심 요약 AI Agent 성능은 모델 선택에 영향을 받지만, 실무에서는 모델 하나보다 과업 유형, 툴 사용, 프롬프트 구조, 검증 루프가 더 큰 차이를 만드는 경우가 많다. 비싼 모델이 항상 정답은 아니며, 작업에 맞는 모델과 운영 설계를 함께 맞추는 것이 훨씬 중요하다. ...

2026년 4월 23일 · 5 분 · 922 단어 · TechLLM