KV 캐시 압축 3파전: TurboQuant·OSCAR·EpiCache 누구를 어디에 쓸까
개요 긴 컨텍스트 LLM을 직접 돌려본 사람이면 다 압니다. GPU가 노는데도 토큰은 느리게 나옵니다. 범인은 연산이 아니라 KV 캐시입니다. 시퀀스가 길어질수록 캐시가 선형으로 부풀어, 매 토큰마다 그 큰 덩어리를 HBM으로 다시 끌어와야 합니다. 메모리 대역폭이 천장을 치는 순간 디코딩 속도가 무너집니다. ...
개요 긴 컨텍스트 LLM을 직접 돌려본 사람이면 다 압니다. GPU가 노는데도 토큰은 느리게 나옵니다. 범인은 연산이 아니라 KV 캐시입니다. 시퀀스가 길어질수록 캐시가 선형으로 부풀어, 매 토큰마다 그 큰 덩어리를 HBM으로 다시 끌어와야 합니다. 메모리 대역폭이 천장을 치는 순간 디코딩 속도가 무너집니다. ...
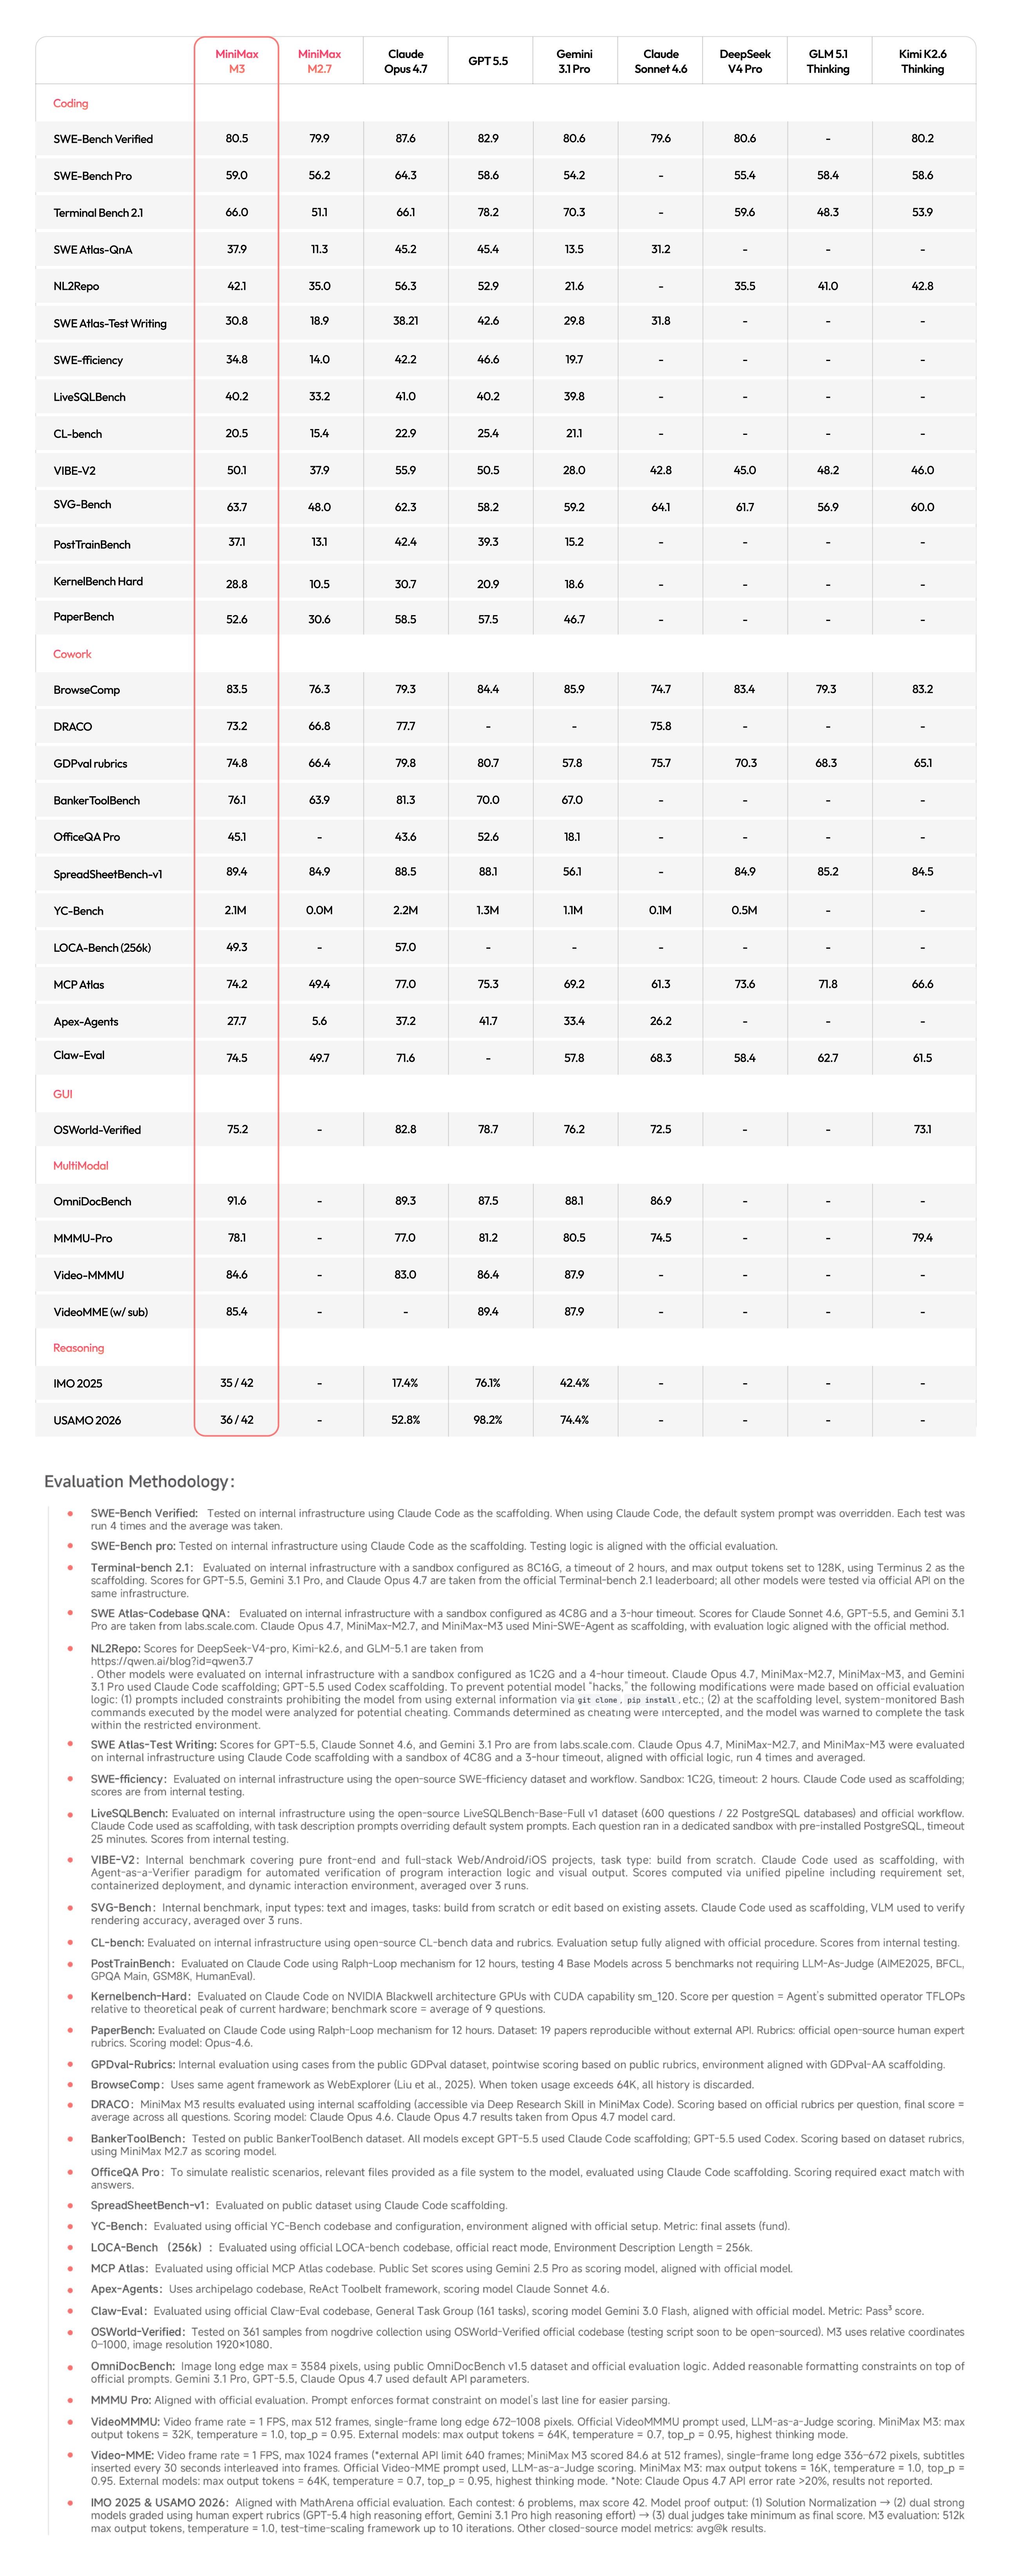
개요 MiniMax가 HuggingFace에 M3 모델 카드를 올렸습니다. 발표 글만 보고 “오, 좋네” 하고 끝낼 수도 있지만, 진짜 궁금한 건 따로 있습니다. 실제로 어떻게 돌리지? 이 글은 모델 카드에 나와 있는 vLLM, SGLang, Transformers, Docker 실행법을 한국 개발자 입장에서 정리한 실전 메모입니다. ...
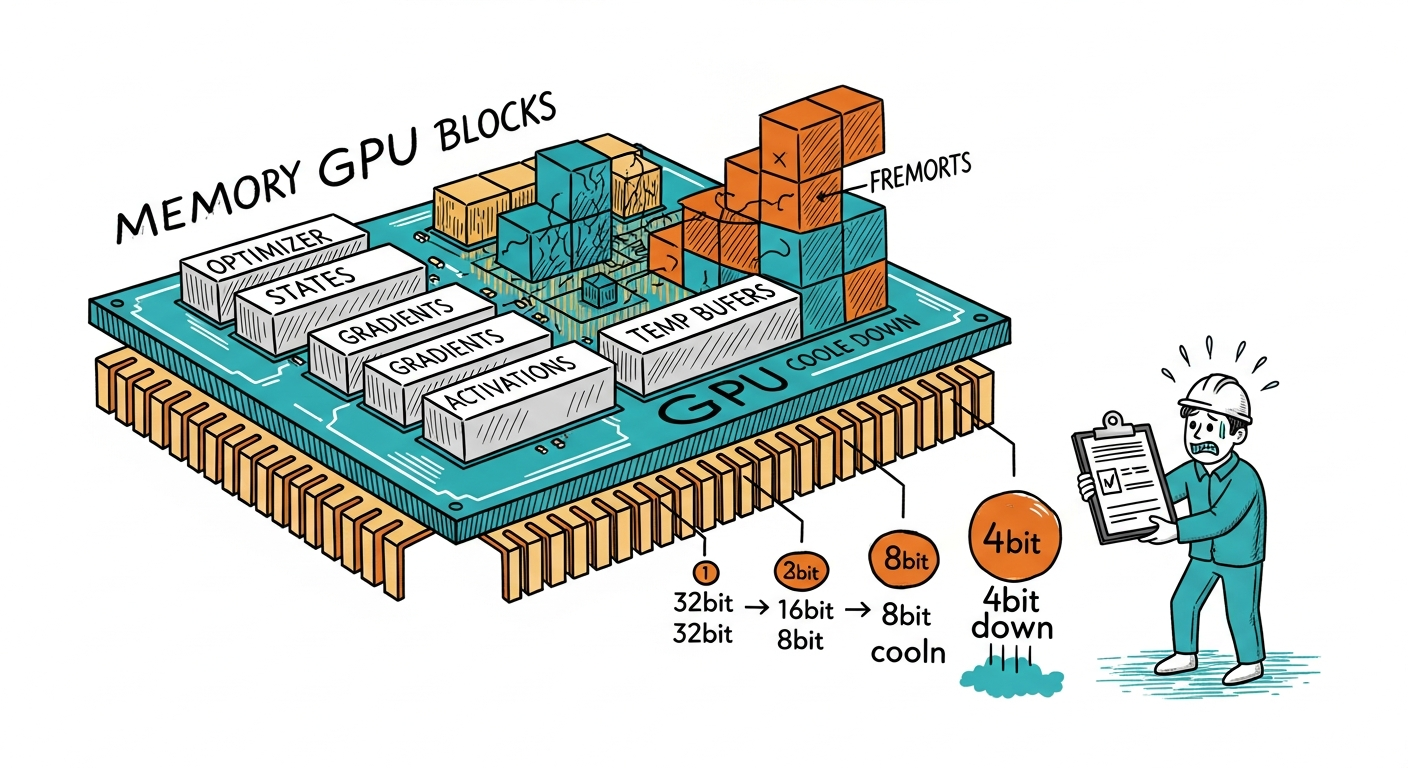
개요 LLM 학습에는 왜 이렇게 많은 GPU 메모리가 필요할까? fp16으로 3GB면 충분해 보이는 GPT-2 1.5B 모델이 실제로는 32GB GPU로도 학습이 안 된다. HuggingFace 커뮤니티에 올라온 Daniil Suhoi의 종합 가이드를 바탕으로, 데이터 타입 기초부터 메모리 구조 분석, 양자화 원리까지 핵심만 추려 정리했다. ...