에이전트 시스템을 경쟁 트랙에서 평가하는 리더보드 — 모델 너머를 보다

IBM이 만든 오픈 에이전트 리더보드 — 모델이 아니라 시스템을 평가한다

개요 AI 모델 평가는 이미 넘쳐난다. 하지만 에이전트는 모델만으로 이루어지지 않는다. 어떤 도구를 쓰는지, 어떻게 단계를 계획하는지, 오류에서 어떻게 회복하는지 — 이 모든 것이 실제 성능을 결정한다. IBM Research가 공개한 Open Agent Leaderboard는 이 문제에 정면으로 답한다. 모델이 아니라 전체 에이전트 시스템을 비교하는 오픈 벤치마크로, 품질과 비용을 함께 보여준다. ...
2026년 5월 22일 · 3 분 · 565 단어 · TechLLM
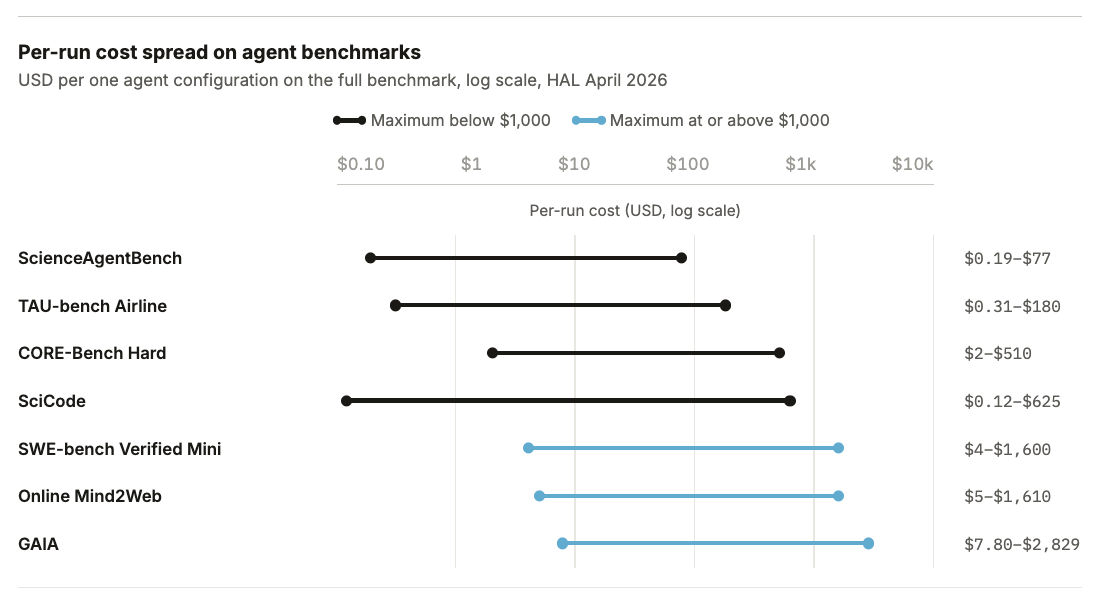
HAL 벤치마크별 에이전트 평가 비용 분포 — 일부 벤치마크는 1회 실행에 $1,000 이상

AI 평가가 새로운 compute 병목이 됐다 — $40,000짜리 벤치마크의 시대

모델을 훈련하는 비용이 문제라고 했다. 이제 평가하는 비용이 문제가 됐다. Holistic Agent Leaderboard(HAL)은 최근 9개 모델, 9개 벤치마크에서 21,730회 에이전트 롤아웃을 실행하는 데 4만 달러를 썼다. GAIA 벤치마크 하나를 최신 모델로 돌리면 캐싱 전 비용이 2,829달러다. PaperBench 1회 평가는 약 9,500달러다. ...

2026년 5월 10일 · 6 분 · 1172 단어 · TechLLM
Open-weights AI model defeating frontier models in coding challenge

오픈웨이트 중국 모델이 Claude·GPT-5.5·Gemini를 이겼다

핵심 요약 2026년 4월 30일, Rohana Rezel이 운영하는 AI Coding Contest의 12번째 챌린지 Word Gem Puzzle에서 Moonshot AI의 오픈웨이트 모델 Kimi K2.6이 22 매치 포인트(7승 1패)로 1위를 차지했다. 2위는 Xiaomi의 MiMo V2-Pro, 3위 GPT-5.5, Claude Opus 4.7은 5위에 그쳤다. ...

2026년 5월 3일 · 3 분 · 464 단어 · TechLLM