Thinking Machines 인터랙션 모델 — 외부 하네스 없이 모델이 직접 실시간 협업한다
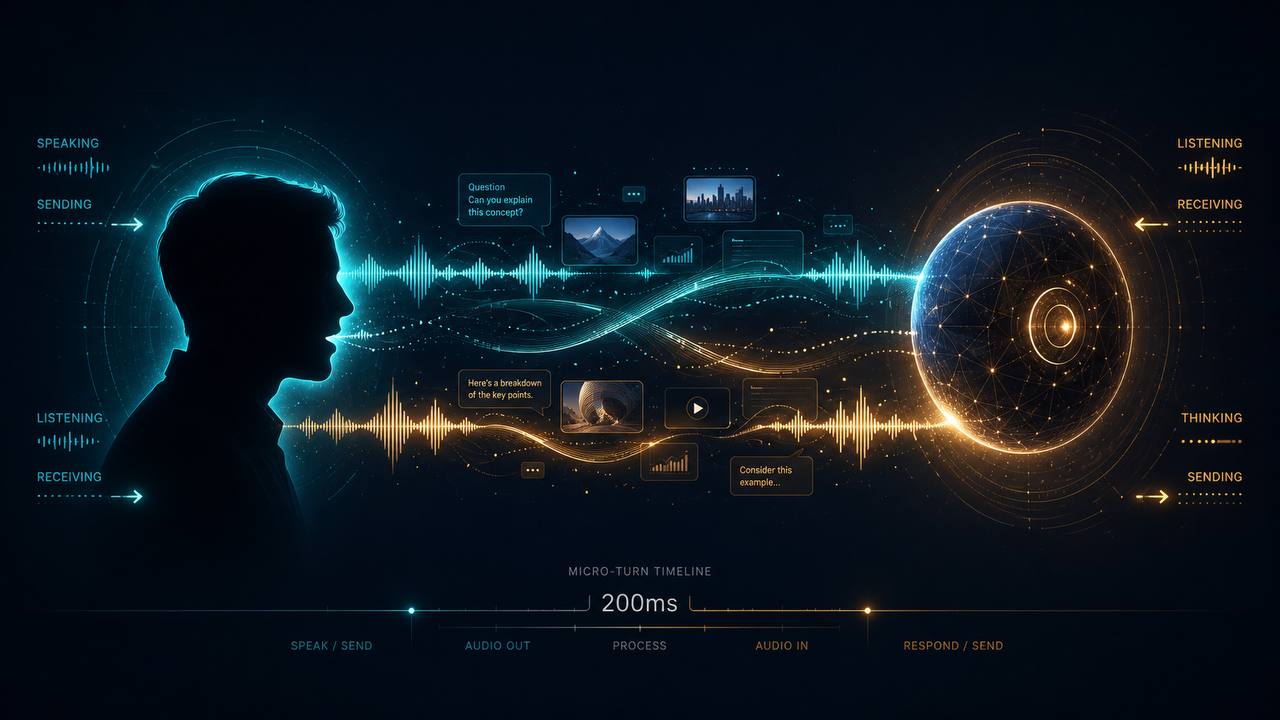
핵심 요약 Thinking Machines가 TML-Interaction-Small을 research preview로 공개했다. “AI와의 상호작용” 자체를 모델이 네이티브로 처리하는 새 패러다임이다. 현재 frontier 모델은 사용자를 자율 워크플로 밖으로 밀어내며 협업 대역폭을 좁히는 흐름이었다 — 인터랙션 모델은 이 추세를 반대 방향으로 잡는다. 핵심 설계는 time-aligned micro-turn (200ms) — 입력과 출력을 200ms 단위로 인터리브해 audio·video·text가 동시 흐른다. 인터랙션 모델 + 백그라운드 모델 이원 구조 — 실시간 응답성과 reasoning 깊이를 동시에 확보. 벤치마크: 턴테이킹 지연 0.40초(GPT-realtime-2.0 minimal 1.18초의 1/3), FD-bench v1.5 평균 77.8 (다음 후보 54.3), Audio MultiChallenge 43.4%(instant 모델 중 1위). 협업 병목 — 자율성 경쟁이 가린 사용자 AI 연구의 주류 서사는 모델이 사람 없이 얼마나 멀리 갈 수 있는가에 맞춰져 왔다. METR의 “long-task” 측정처럼 자율 능력이 핵심 지표로 자리 잡으며, 인터페이스는 사람이 빠진 자율 실행을 전제로 진화했다. Anthropic이 자사 model card에서 직접 짚었듯, 일부 모델은 hands-on-keyboard 패턴에서 너무 느리게 느껴져 가치가 작아 보이고, 장시간 자율 agent harness가 더 잘 작동한다는 평가가 자리 잡고 있다. ...