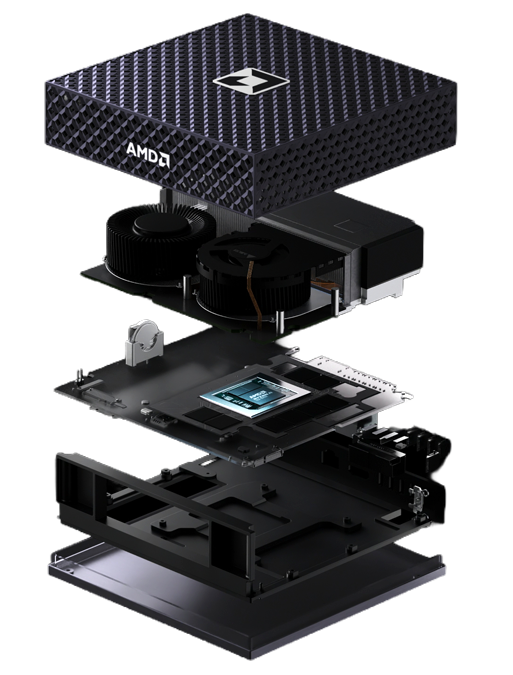
AMD 라이젠 AI Halo 개발자 플랫폼 본체

AMD 라이젠 AI Halo 발표 — 4천 달러대 박스에서 200B 모델을 로컬로

핵심 요약 AMD가 로컬 AI 개발 전용 박스 라이젠 AI Halo를 공개했다. 라이젠 AI Max+ 395 프로세서에 128GB LPDDR5x 통합 메모리, 50 TOPS NPU를 묶은 구성이다. 메모리 한 덩어리에 모델을 통째로 올릴 수 있어 최대 200B 파라미터 모델까지 로컬 추론이 가능하다고 AMD는 명시한다. 가격은 3,999달러. 4,699달러인 NVIDIA DGX Spark보다 700달러 싸고, 윈도우와 리눅스를 둘 다 지원한다. 자체 측정 기준 이미지 생성 워크로드에서 애플 M4 Pro 대비 3.3~7.3배 빠르고, DGX Spark 대비 LLM 토큰 처리량은 4~14% 우위라고 주장한다. AMD ROCm 소프트웨어와 Ollama·LM Studio·vLLM·PyTorch·LoRA/QLoRA 같은 오픈 생태계가 사전 설치돼 있다. 192GB 메모리를 탑재한 라이젠 AI Max+ PRO 495 상위 모델도 곧 출시 예정이다. 라이젠 AI Halo가 무엇인가 라이젠 AI Halo는 AMD가 “전원을 켜고 몇 분 안에 토큰을 뽑을 수 있다"는 것을 목표로 만든 로컬 AI 개발자 박스입니다. 칩 하나에 CPU, GPU, NPU가 통합돼 있고, 메모리는 한 덩어리로 묶인 128GB 통합 메모리입니다. 가장 큰 의미는 이 메모리 구조에 있습니다. GPU VRAM 24GB, 시스템 RAM 64GB 같은 분리 구조가 아니라 통합 메모리 한 풀로 동작하기 때문에, 거대한 모델을 굳이 잘게 쪼개거나 오프로딩 트릭을 쓸 필요 없이 그대로 올릴 수 있습니다. ...
2026년 6월 17일 · 5 분 · 890 단어 · TechLLM
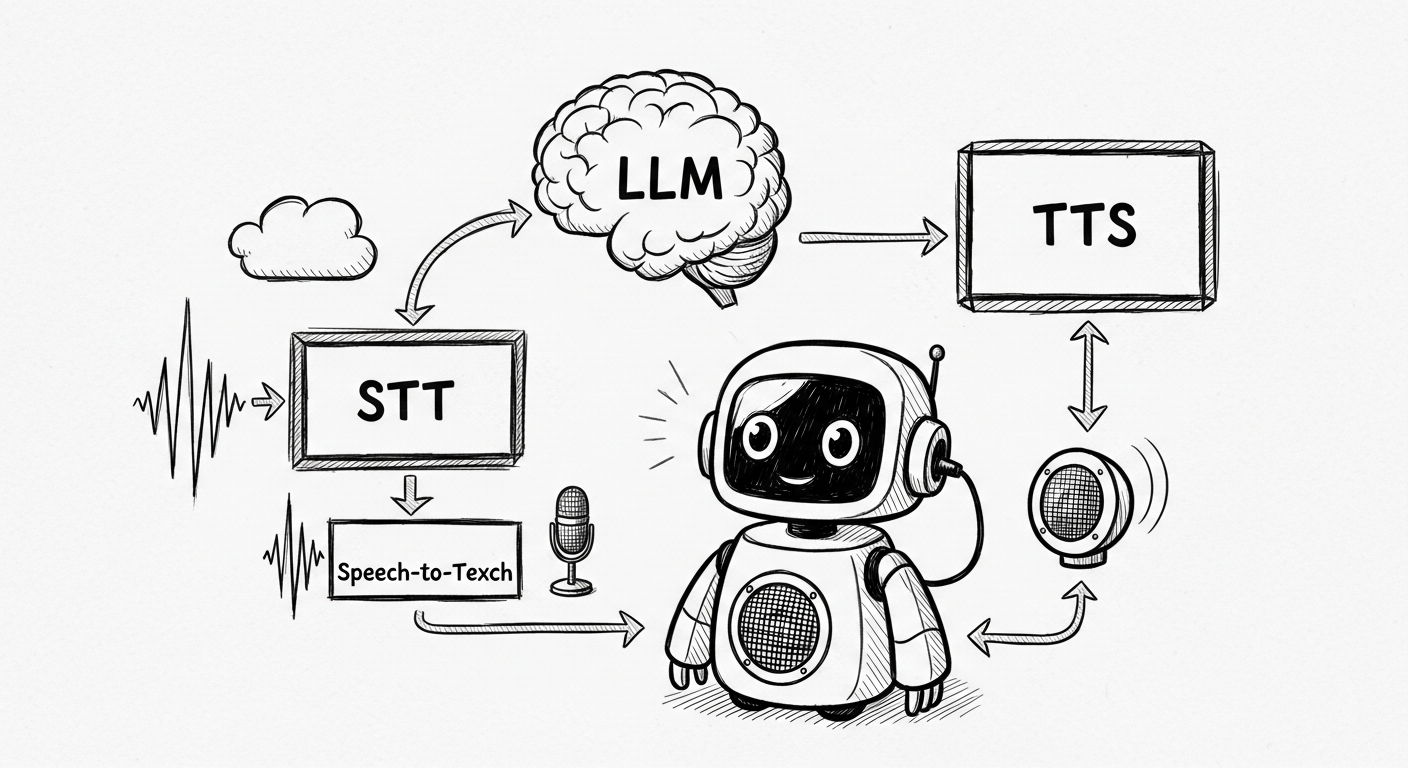
소형 로봇이 클라우드 없이 로컬에서 음성 대화하는 핸드드로잉 스타일 일러스트

Reachy Mini 완전 로컬화 — 클라우드 없이 speech-to-speech 로봇 대화

개요 Reachy Mini 로봇의 대화 기능이 완전 로컬로 전환됐다. 기존에는 음성 데이터를 서버로 전송해야 했다. 이제 VAD, STT, LLM, TTS 전 단계가 사용자 기기에서 실행된다. HuggingFace의 speech-to-speech 라이브러리가 캐스케이드 파이프라인을 단일 CLI로 묶었다. 오디오가 네트워크 밖으로 나가지 않고, API 키도 API 비용도 없다. ...

2026년 5월 28일 · 3 분 · 589 단어 · TechLLM
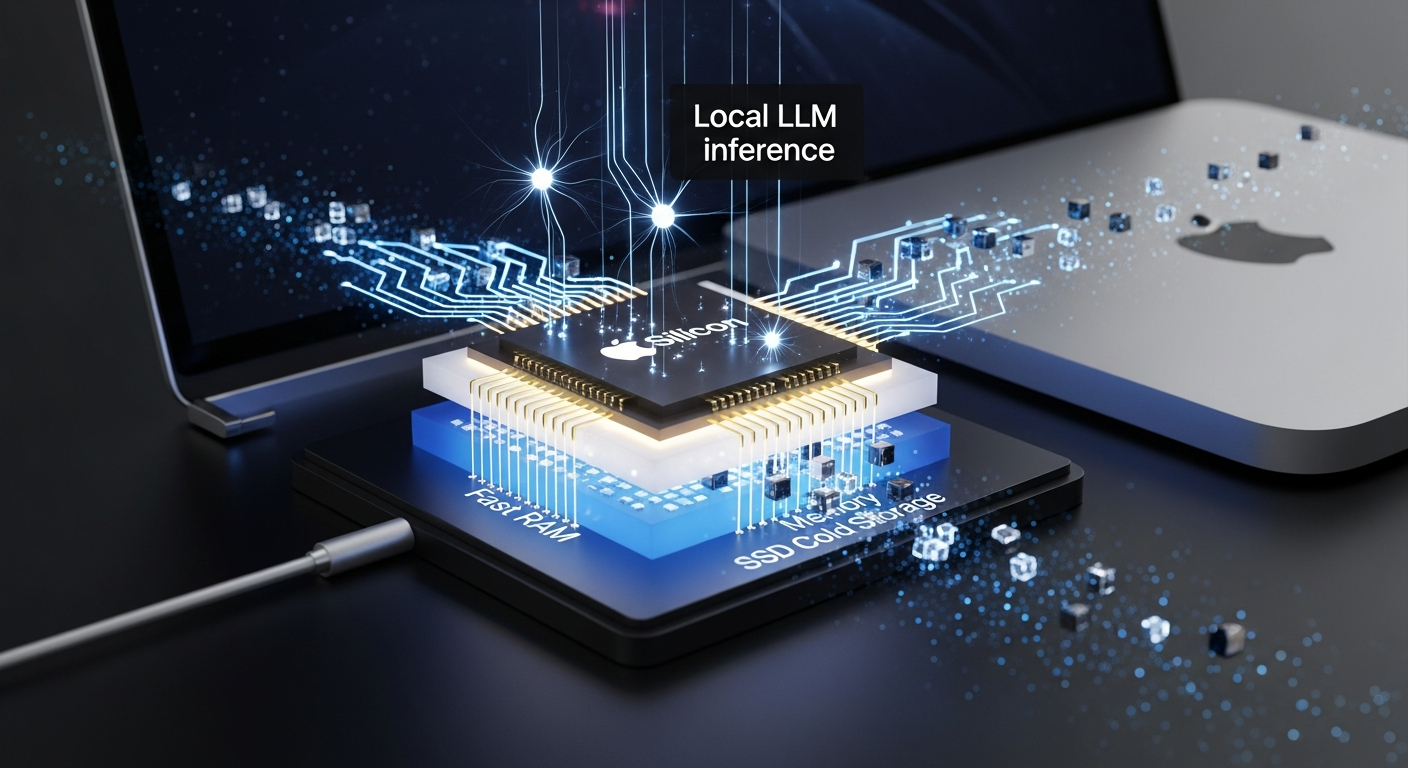
oMLX Apple Silicon LLM 서버

Mac에서 돌리는 로컬 LLM 서버 — oMLX, 계층형 KV 캐시와 연속 배칭

개요 로컬 LLM 서버를 써본 사람이라면 대부분 같은 불만에 맞닥뜨린다. 편하거나 제어하거나, 둘 중 하나만 된다. oMLX는 이 선택지를 거부한다. Apple Silicon Mac에 최적화된 추론 서버로, RAM과 SSD를 2계층 KV 캐시로 쓰고, 연속 배칭으로 동시 요청을 처리하고, macOS 메뉴바 앱으로 전부 제어한다. GitHub 스타 1.4만, 릴리스 71개. 실사용 기반이 탄탄하다. Llama, Qwen, Mistral, Gemma 계열 등 mlx-lm이 지원하는 모델이라면 대부분 올릴 수 있다. ...

2026년 5월 16일 · 3 분 · 637 단어 · TechLLM