노트북에 연결된 작은 바퀴 로봇이 비치볼을 향해 다가가고, 옆에는 Claude를 상징하는 별 아이콘이 떠 있는 손그림 일러스트

Claude Opus 4.7, 로봇 계획 작업을 사람보다 20배 빠르게 — Anthropic의 두 번째 Project Fetch

핵심 요약 Anthropic이 2025년 8월에 진행했던 Project Fetch를 새 Claude 모델로 다시 돌렸습니다. 실험 도구는 Claude Code 안에서 동작하는 Claude Opus 4.7, 사람은 노트북을 로봇에 연결하고 초기 프롬프트만 던지는 역할에 머물렀습니다. Opus 4.7은 사람이 1년 전에 풀었던 일부 과제를 가장 빠른 인간 팀보다 약 20배 빠르게 끝냈고, 단계별로도 최소 10배 이상 빨랐습니다. 다만 비치볼을 정확히 굴려 시작 지점으로 되돌리는 “가져오기(fetching)” 동작에서는 여전히 막혔습니다. 정밀 모션 제어는 미해결입니다. Anthropic은 “이건 로보틱스 돌파구가 아니다"라고 못 박았습니다. 발전의 원인은 로보틱스 특화가 아니라 모델 전반의 스케일업 때문이라는 설명입니다. 개요 Anthropic이 자체 블로그에 올린 두 번째 Project Fetch 보고서는 짧지만 메시지가 분명합니다. 같은 로봇, 같은 과제, 다른 결과. 1년 사이에 사람을 따라잡던 LLM이 사람을 한참 앞질러 버렸습니다. 그러면서도 “지금까지 LLM이 로보틱스를 풀었다고 보기는 어렵다"라고 스스로 선을 그었습니다. 이 둘이 같이 적힌 글이라는 점이 흥미롭습니다. ...
2026년 6월 19일 · 4 분 · 663 단어 · TechLLM
NVIDIA Cosmos 3 — 물리적 AI를 위한 오픈 옴니모델

NVIDIA Cosmos 3 — 로보틱스·자율주행을 위한 첫 오픈 옴니모델

개요 NVIDIA가 2026년 6월 1일 Cosmos 3를 공개하고 Hugging Face에 올렸다. 물리적 AI(Physical AI)를 위한 세계 기반 모델(World Foundation Model)의 새로운 전환점이다. 핵심은 단일 통합 아키텍처 — 이전 Cosmos 버전들이 각각 다른 모델로 처리하던 세계 생성, 물리 추론, 행동 생성을 하나의 모델 한 번의 포워드 패스로 처리한다. ...

2026년 6월 1일 · 3 분 · 539 단어 · TechLLM
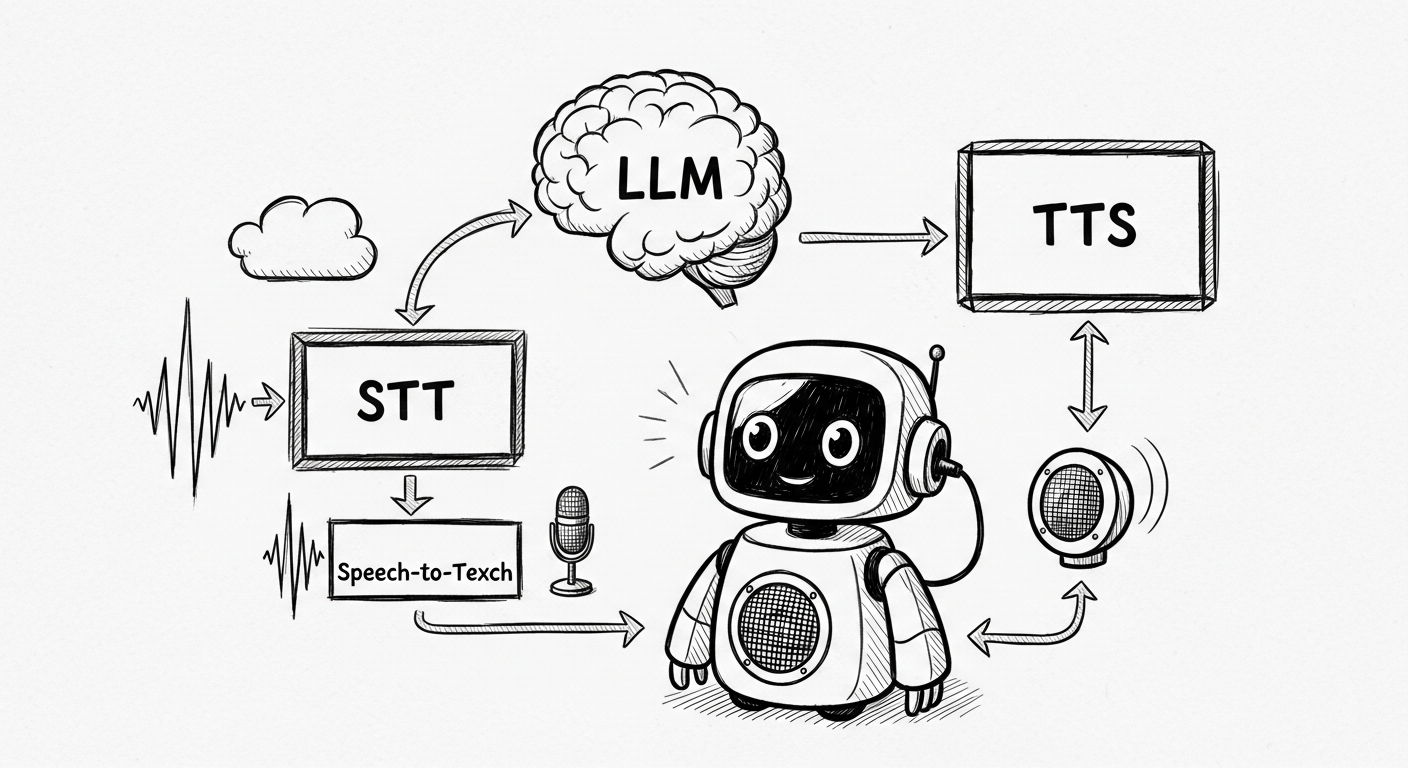
소형 로봇이 클라우드 없이 로컬에서 음성 대화하는 핸드드로잉 스타일 일러스트

Reachy Mini 완전 로컬화 — 클라우드 없이 speech-to-speech 로봇 대화

개요 Reachy Mini 로봇의 대화 기능이 완전 로컬로 전환됐다. 기존에는 음성 데이터를 서버로 전송해야 했다. 이제 VAD, STT, LLM, TTS 전 단계가 사용자 기기에서 실행된다. HuggingFace의 speech-to-speech 라이브러리가 캐스케이드 파이프라인을 단일 CLI로 묶었다. 오디오가 네트워크 밖으로 나가지 않고, API 키도 API 비용도 없다. ...

2026년 5월 28일 · 3 분 · 589 단어 · TechLLM
네 종류 로봇이 자연어 명령으로 복잡한 환경을 탐색하는 핸드드로잉 스타일 일러스트

Uni-LaViRA — 언어·비전·로봇 행동을 하나로 묶는 제로샷 체화 항법

개요 항법(Navigation)에는 특수한 성질이 있다. 목적지까지 가는 결정 구조가 언어 방향 명령과 픽셀 수준 시각 타깃이라는 두 출력으로 환원된다. 이 두 출력은 사전 학습된 MLLM의 자연 출력 공간 안에 있다. 즉, 로봇 데이터로 학습하지 않아도 추론으로 풀 수 있다. Uni-LaViRA는 이 통찰을 네 가지 과제 군과 네 종류 실제 로봇에 동시에 적용한 통합 에이전트 아키텍처다. ...

2026년 5월 28일 · 3 분 · 602 단어 · TechLLM
중국 AI 생태계의 모델, 데이터, 로봇 혁신을 표현한 핸드드로잉 스타일 일러스트

중국 AI 8일 방문기 — 제약 속에서 더 혁신적이 된 생태계

개요 Linux Foundation 글로벌 AI CTO 매트 화이트(Matt White)가 2026년 5월, 중국 AI 랩과 로보틱스 스타트업, 학계를 8일간 직접 방문하고 관찰 보고서를 공개했다. 결론은 하나다. “중국 AI 생태계는 억제해야 할 위협이 아니라, 참여해야 할 커뮤니티다.” 그리고 오픈소스가 두 생태계를 잇는 유일한 다리다. ...

2026년 5월 27일 · 4 분 · 798 단어 · TechLLM
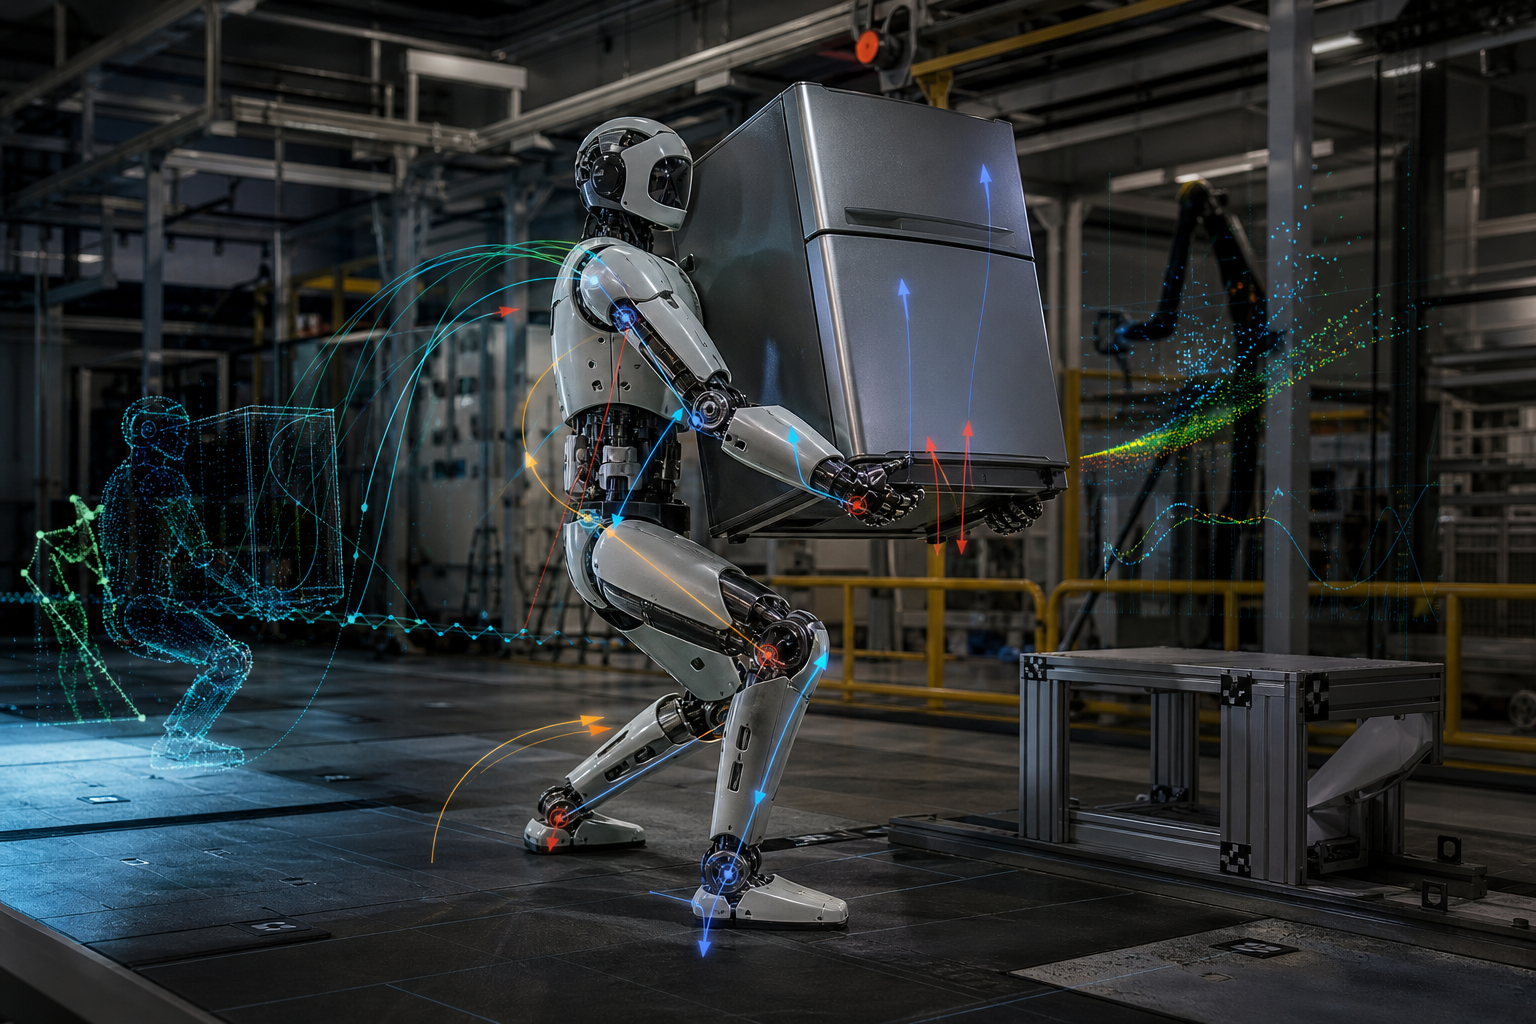
휴머노이드 로봇이 공장 환경에서 무거운 물체를 들어 올리는 장면

보스턴 다이내믹스 Atlas, 냉장고를 들게 만든 훈련법 — 휴머노이드의 진짜 난제

보스턴 다이내믹스의 Atlas가 미니 냉장고를 들어 옮기는 장면은 단순한 쇼맨십처럼 보일 수 있다. 하지만 이 데모의 핵심은 “로봇이 무거운 물건을 들었다”가 아니다. 휴머노이드가 실제 산업 현장에서 일하려면 무엇을 배워야 하는지 보여주는 실험에 가깝다. ...

2026년 5월 20일 · 4 분 · 664 단어 · TechLLM
VLA 모델의 비동기 추론에서 발생하는 관측 stale 문제와 네 가지 보정 방법을 표현한 일러스트

VLA 로봇 모델 추론 지연 문제, 4가지 해법 통일 벤치마크 — A2C2가 가장 강했다

핵심 요약 VLA(Vision-Language-Action) 모델은 일반화된 로봇 제어의 길을 여는 한편, **추론 지연(latency)**이 비동기 실행 시 관측을 낡게(stale) 만든다. 이 문제를 풀기 위해 동시기에 제안된 네 방법(IT-RTC, TT-RTC, VLASH, A2C2)은 그동안 서로 다른 코드베이스·정책·프로토콜로 평가돼 우열을 가릴 수 없었다. 본 논문은 네 방법을 통일된 코드베이스 두 개로 묶어 Kinetix·LIBERO 두 벤치마크에서 추론 지연 d=0~20 단계까지 sweep해 비교했다. A2C2의 per-step 잔차 보정이 Kinetix·LIBERO 모두에서 강했고, TT-RTC는 가장 강건한 학습 기반 방법으로 추론 오버헤드 0이라는 강점을 보였다. VLA 실배포에서 어떤 보정 기법을 고를지는 목표 지연 범위와 추론 비용 허용도에 따라 갈린다는 것이 명확해졌다. VLA 모델과 ‘관측 stale’ 문제 Vision-Language-Action(VLA) 모델은 카메라 입력과 자연어 지시를 한 모델에서 받아 로봇 행동 시퀀스를 생성한다. 일반화 능력은 매력적이지만 모델 크기가 커질수록 한 번의 추론에 걸리는 시간도 길어진다. ...

2026년 5월 12일 · 4 분 · 682 단어 · TechLLM