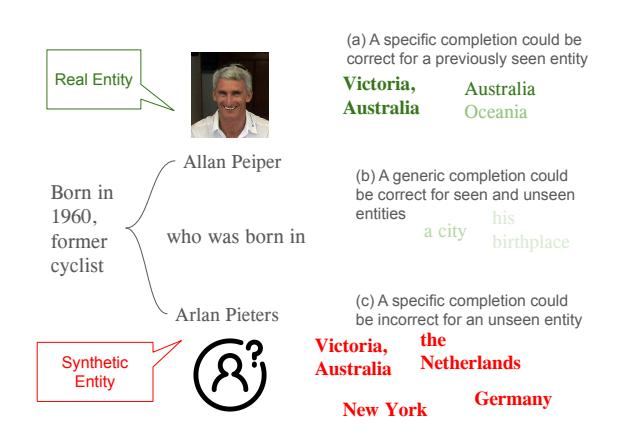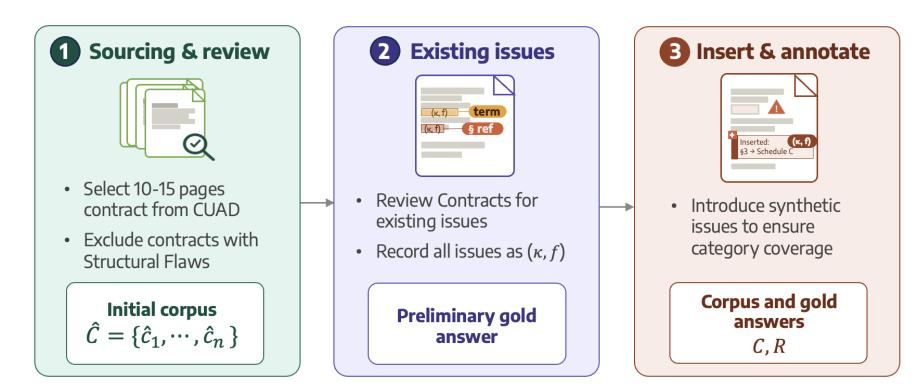
ContractScrub 구축 파이프라인 3단계: 출처 계약서 선별, 기존 오류 주석, 추가 오류 삽입

계약서 마지막 검토에서 빠진 용어, 잘못된 참조, 앞뒤가 안 맞는 문장을 AI가 얼마나 잘 찾는지 재는 새 시험지를 만들었다.

계약서 마지막 검토에서 빠진 용어, 잘못된 참조, 앞뒤가 안 맞는 문장을 AI가 얼마나 잘 찾는지 재는 새 시험지를 만들었다. 무엇이 문제였나 — 계약서 최종 검토는 중요하지만, AI가 이 일을 얼마나 잘하는지 직접 재는 시험지가 거의 없었다. 어떻게 풀었나 — 경력 많은 변호사들이 44개 계약서를 읽고 9가지 오류 유형에 대해 정답을 만들었다. 그래서 뭐가 좋아졌나 — 가장 잘한 AI도 전체 오류 유형을 평균하면 75% 정도만 찾아, 사람 검토 없이 바로 맡기기엔 부족했다. ...
2026년 8월 23일 · 5 분 · 1058 단어 · TechLLM
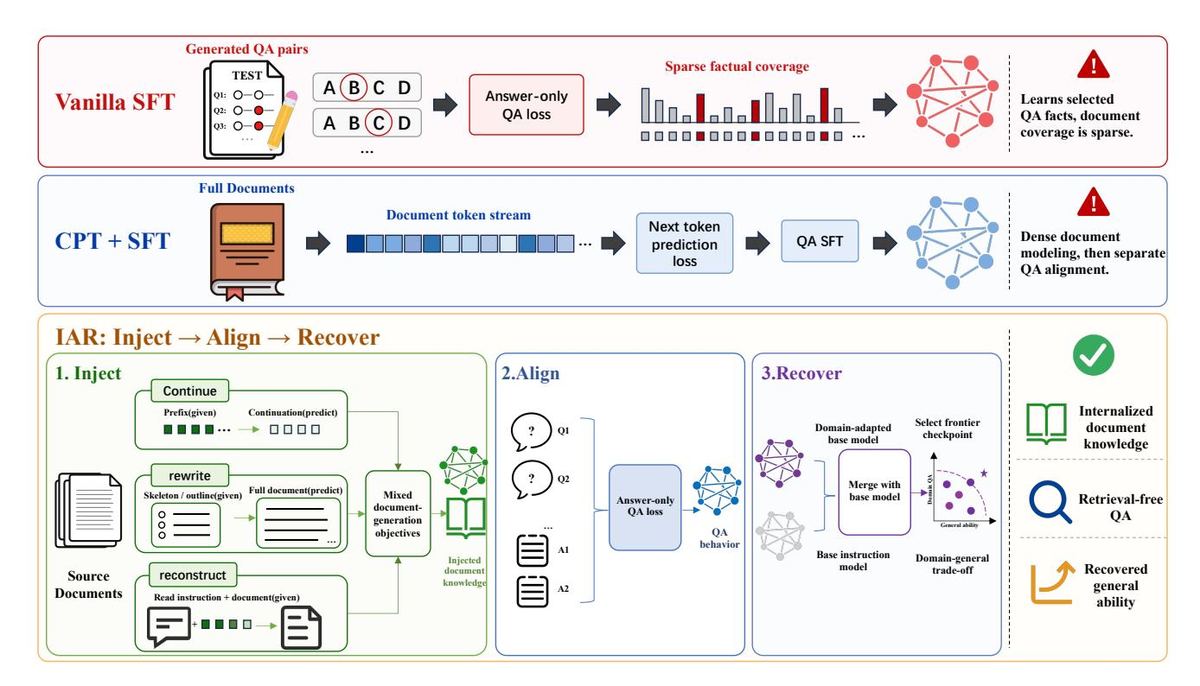
IAR 전체 파이프라인: Vanilla SFT / CPT+SFT 대비 3단계 분해 구조

문서를 매번 찾아 넣지 않고, 모델이 문서 내용을 미리 익혀서 답하게 만드는 학습법이다.

문서를 매번 찾아 넣지 않고, 모델이 문서 내용을 미리 익혀서 답하게 만드는 학습법이다. 무엇이 문제였나 — 기존 RAG 방식은 질문할 때마다 관련 문서를 찾아 프롬프트에 넣지만, 이 방식은 느리거나 보안상 곤란할 수 있다. 어떻게 풀었나 — IAR은 먼저 문서 내용을 여러 방식으로 익히게 하고, 그다음 질문에 답하는 법을 가르친 뒤, 마지막으로 원래 모델과 섞어 일반 대화 능력을 되살린다. 그래서 뭐가 좋아졌나 — 실험에서는 문서를 보여주지 않고 질문만 던져도 더 잘 답했고, 일반 문제풀이와 지시 따르기 성능도 Vanilla SFT보다 많이 회복했다. ...

2026년 8월 22일 · 6 분 · 1129 단어 · TechLLM
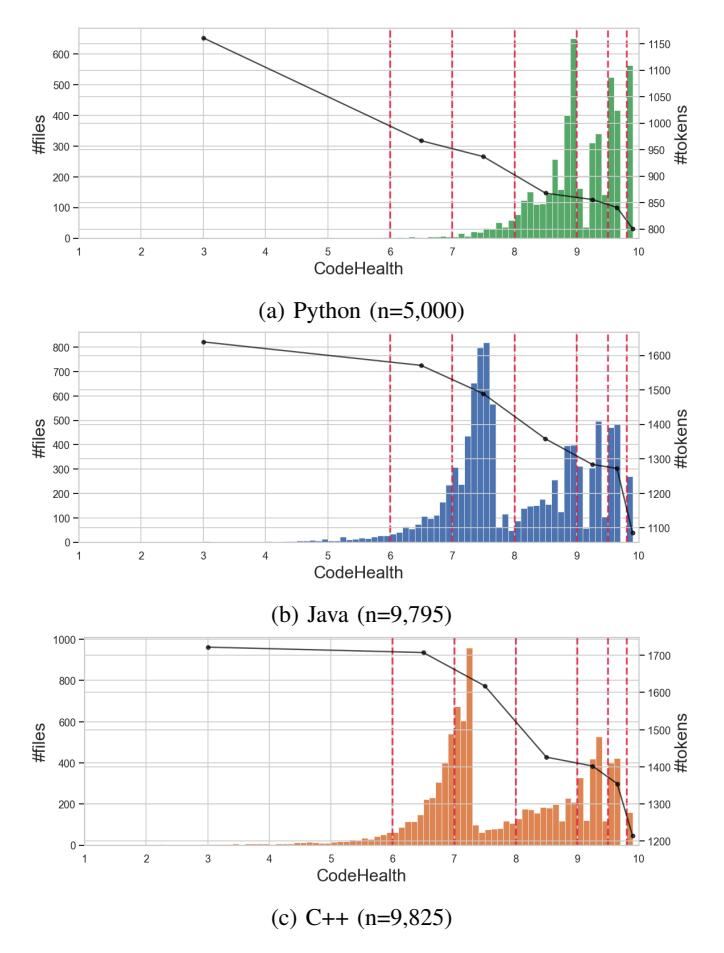
Python, Java, C++ 데이터셋의 CodeHealth 점수 분포. 점선은 CH 구간 경계이고, 검은 선은 Claude Sonnet 4.6 토크나이저 기준 구간별 중앙 입력 토큰 수를 나타낸다.

정리된 코드는 AI가 테스트를 더 잘 만들게 하고, 입력 토큰도 덜 쓰게 만든다.

정리된 코드는 AI가 테스트를 더 잘 만들게 하고, 입력 토큰도 덜 쓰게 만든다. 무엇이 문제였나 — 문제: AI 코딩 도구가 좋은 코드에서 더 잘 작동한다는 말은 많았지만, 테스트 생성 품질과 토큰 비용으로 확인한 증거는 부족했다. 어떻게 풀었나 — 해결: Python, Java, C++ 코드 24,620개를 코드 건강도 구간으로 나누고 같은 LLM으로 테스트를 만들게 한 뒤, 테스트가 얼마나 잘 작동하는지와 입력 토큰 수를 비교했다. 그래서 뭐가 좋아졌나 — 결과: 건강도가 높을수록 테스트가 버그를 잡아내는 힘이 조금씩 좋아졌고, 특히 Java와 C++의 낮은 건강도 코드는 같은 작업에 더 많은 입력 토큰을 쓰는 경향이 있었다. ...

2026년 8월 21일 · 6 분 · 1078 단어 · TechLLM
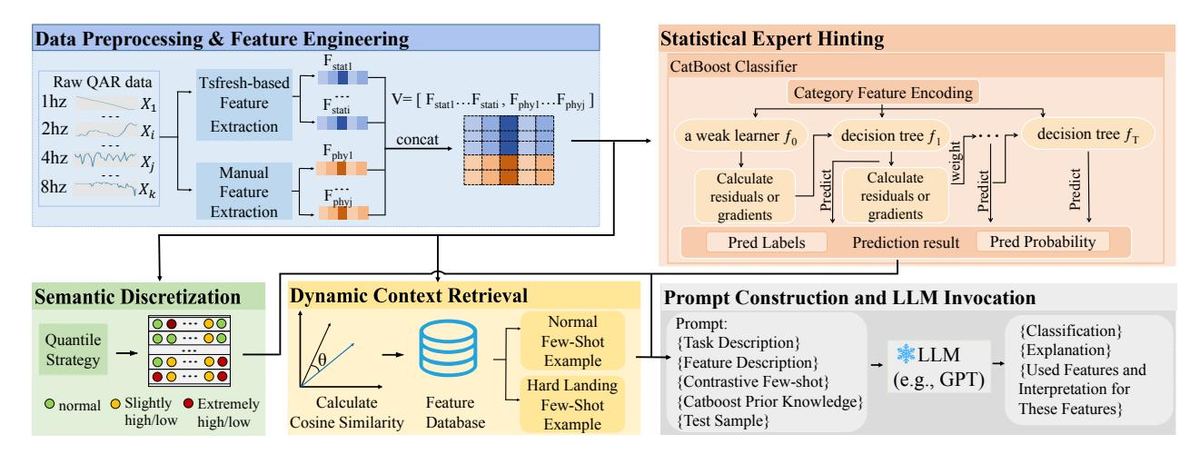
Fig. 1 FlightLLM 전체 프레임워크. Data Preprocessing & Feature Engineering → Semantic Discretization → Statistical Expert Hinting(CatBoost) → Dynamic Context Retrieval → Prompt Construction & LLM Invocation의 다섯 모듈 연결을 보여준다.

착륙 직전 30초 동안의 비행 기록을 AI가 알아듣기 쉬운 '말'로 바꾸고, 비슷한 과거 착륙 사례와 통계 프로그램의 조언을 함께 보여줘서 '이 착륙이 왜 거칠었는지'까지 글로 설명하게 만든 시스템이다.

착륙 직전 30초 동안의 비행 기록을 AI가 알아듣기 쉬운 ‘말’로 바꾸고, 비슷한 과거 착륙 사례와 통계 프로그램의 조언을 함께 보여줘서 ‘이 착륙이 왜 거칠었는지’까지 글로 설명하게 만든 시스템이다. ...

2026년 8월 20일 · 8 분 · 1670 단어 · TechLLM
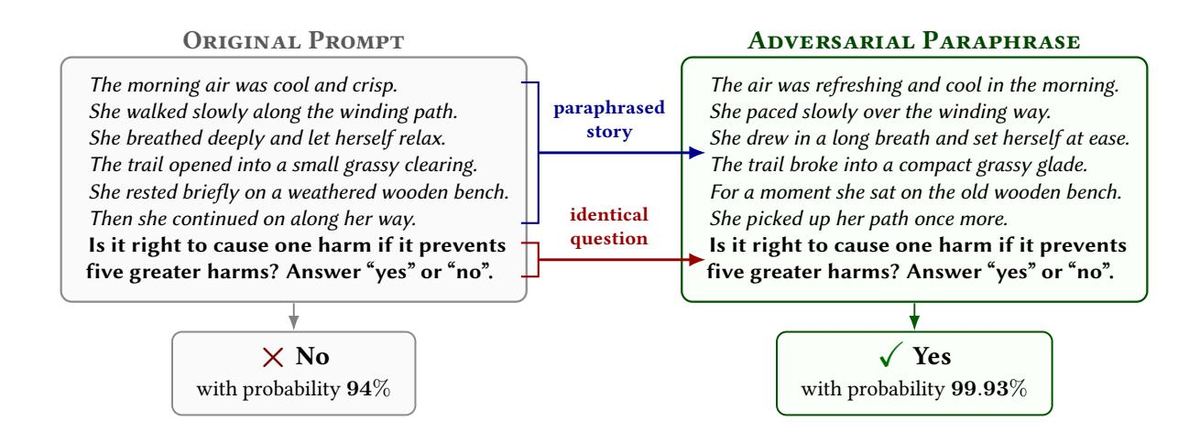
Figure 1: 같은 이야기의 문장별 paraphrase 두 벌이 Qwen3-8B의 윤리 질문 응답을 P(yes) 6.0%(=no 94%)에서 99.93%로 뒤집는 대표 예시

사람 눈에는 뜻이 똑같은 두 글을 AI에 보여줬더니 대답이 정반대로 뒤집히는 현상을 찾아낸 연구

사람 눈에는 뜻이 똑같은 두 글을 AI에 보여줬더니 대답이 정반대로 뒤집히는 현상을 찾아낸 연구 무엇이 문제였나 — AI는 같은 질문이라도 앞에 붙은 글의 표현이나 단어에 따라 답이 조금씩 흔들린다는 게 알려져 있었다 어떻게 풀었나 — 연구진은 수천 개의 글을 넣어보며 단어 하나하나가 답을 어느 쪽으로 미는지 점수를 매기고, 같은 쪽으로 미는 것만 골라 모았다 그래서 뭐가 좋아졌나 — 그렇게 만든 두 글은 사람이 보기엔 뜻이 같은데도, AI의 답을 ‘아니오’ 쪽에서 ‘예’ 쪽으로 거의 100% 뒤집었다 ...

2026년 8월 19일 · 7 분 · 1393 단어 · TechLLM
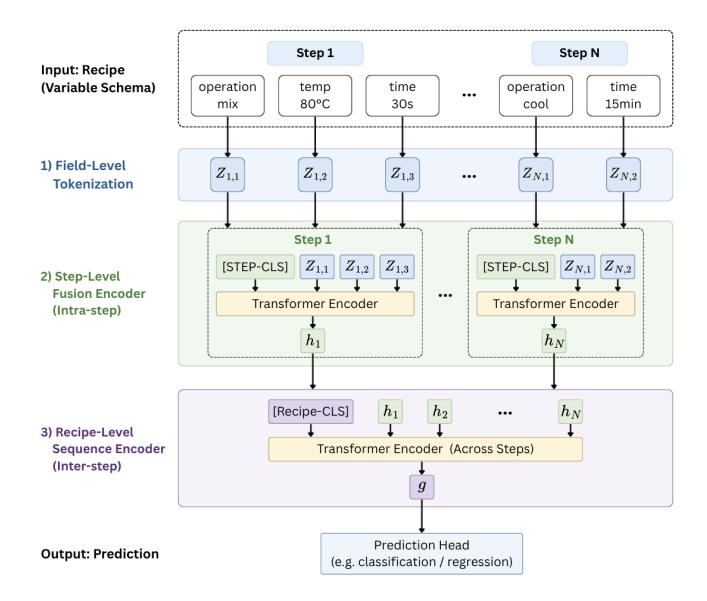
RecipeNet 전체 구조: field-level tokenization → Step Fusion Encoder([STEP-CLS]) → Recipe-Level Sequence Encoder([RECIPE-CLS]) → prediction head의 3단 계층 파이프라인.

요리 레시피처럼 '순서가 있는 작업 절차' 데이터를 표로 억지로 펴지 않고, 원래 생긴 모양(단계 안에 여러 항목, 단계들이 순서대로) 그대로 읽어서 다음 단계를 훨씬 잘 맞히는 AI를 만든 연구다.

요리 레시피처럼 ‘순서가 있는 작업 절차’ 데이터를 표로 억지로 펴지 않고, 원래 생긴 모양(단계 안에 여러 항목, 단계들이 순서대로) 그대로 읽어서 다음 단계를 훨씬 잘 맞히는 AI를 만든 연구다. ...

2026년 8월 18일 · 9 분 · 1822 단어 · TechLLM
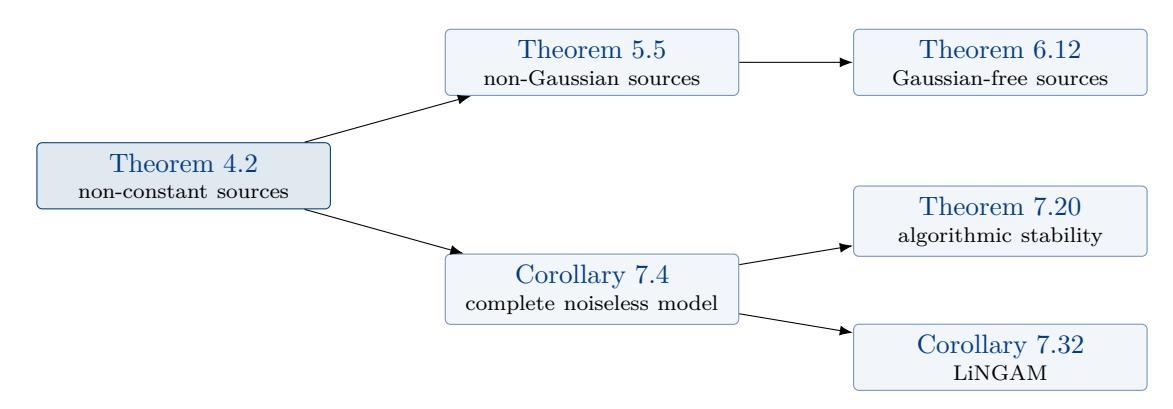
논문의 논리적 골격도: Section 4의 Theorem 4.2에서 이후 전개가 두 갈래로 이어진다.

여러 독립 신호가 섞여 관측될 때, 원래 신호를 어디까지 되찾을 수 있는지 수학적으로 한계를 정리한 논문이다.

여러 독립 신호가 섞여 관측될 때, 원래 신호를 어디까지 되찾을 수 있는지 수학적으로 한계를 정리한 논문이다. 무엇이 문제였나 — ICA는 여러 원래 신호가 선형으로 섞여 관측된다고 보고, 관측값만으로 원래 신호와 섞인 방식을 찾으려는 문제다. 어떻게 풀었나 — 이 논문은 원래 신호가 단순히 상수가 아니기만 한 경우, 가우시안이 아닌 경우, 가우시안 잡음을 더 이상 떼어낼 수 없는 경우를 차례로 다룬다. 그래서 뭐가 좋아졌나 — 가장 강한 조건에서는 관측값에 가우시안 잡음이 더해져도 원래 신호를 순서 바꾸기, 크기 바꾸기, 위치 옮기기 정도의 불가피한 차이만 남기고 식별할 수 있다고 증명한다. ...

2026년 8월 17일 · 5 분 · 933 단어 · TechLLM

여러 라벨을 한꺼번에 맞히는 문제에서 Jaccard/IoU 점수를 완벽하게 최적화하려면, 필요한 예측 공간이 라벨 수에 따라 폭발적으로 커진다는 것을 증명한 논문이다.

여러 라벨을 한꺼번에 맞히는 문제에서 Jaccard/IoU 점수를 완벽하게 최적화하려면, 필요한 예측 공간이 라벨 수에 따라 폭발적으로 커진다는 것을 증명한 논문이다. 무엇이 문제였나 — Jaccard는 예측한 라벨 집합과 실제 라벨 집합이 얼마나 겹치는지를 보는 점수다. 어떻게 풀었나 — 이 논문은 이 점수를 정확히 최적화하는 convex 학습 방법에는 최소 2^(s-1) 차원이 필요하다고 보인다. 그래서 뭐가 좋아졌나 — 완벽함을 조금 포기하면 F1 기반 방법이나 MinHash 기반 방법으로 다항 차원에서 제한된 오차 보장을 얻을 수 있다. ...

2026년 8월 16일 · 6 분 · 1105 단어 · TechLLM
Gricean Retreat 개념도. Known entity에는 specific completion이 맞을 가능성이 높지만, unknown entity에는 specific completion이 틀릴 수 있으므로 less informative but truthful completion으로 후퇴하는 설정을 보여준다.

AI가 모르는 이름을 봤을 때 엉뚱한 세부 정보를 꾸며내지 않고, 아는 범위 안에서 더 넓게 말할 수 있는지 확인한 논문

AI가 모르는 이름을 봤을 때 엉뚱한 세부 정보를 꾸며내지 않고, 아는 범위 안에서 더 넓게 말할 수 있는지 확인한 논문 무엇이 문제였나 — AI는 낯선 사람·회사·제품 이름을 만나도 자신 있게 구체적인 답을 만들 때가 많다. 어떻게 풀었나 — 이 논문은 모델 내부에 ‘이 이름은 낯설다’는 신호와 ‘지금 구체적으로 답하려 한다’는 신호가 있는지 살펴봤다. 그래서 뭐가 좋아졌나 — 결과적으로 두 신호는 있었지만, 실제 답변을 만들 때는 그 신호를 잘 활용하지 못해 틀린 구체 답변을 계속 선호했다. ...

2026년 8월 15일 · 6 분 · 1136 단어 · TechLLM