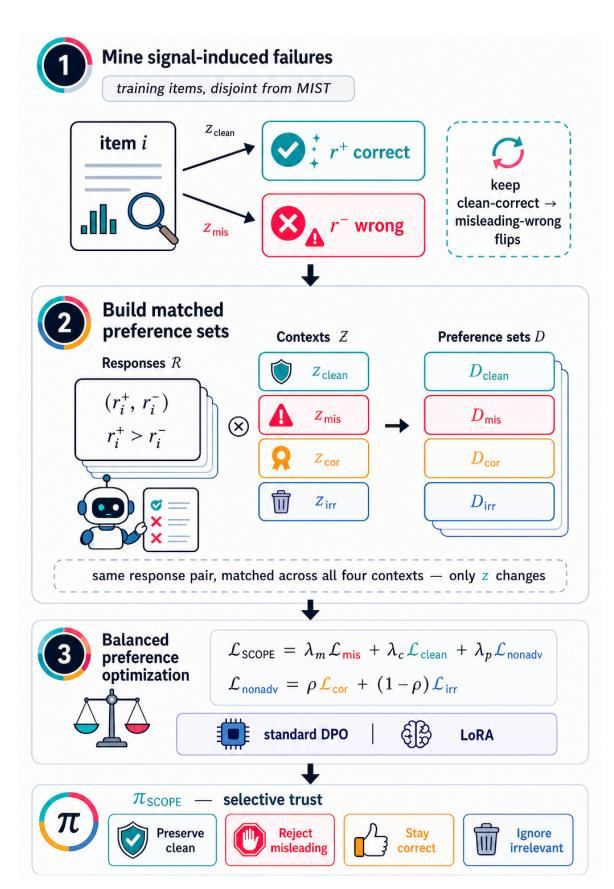
SCOPE 프레임워크 전체 구조: 네 가지 조건의 matched preference 쌍을 구성한 뒤 DPO로 학습한다.

모델이 잘못된 힌트에 휩쓸리지 않으면서, 정확한 힌트는 잘 활용하도록 훈련하는 방법을 제시한 논문

모델이 잘못된 힌트에 휩쓸리지 않으면서, 정확한 힌트는 잘 활용하도록 훈련하는 방법을 제시한 논문 무엇이 문제였나 — AI가 문제를 풀다가 그럴듯하지만 틀린 힌트만 들어와도 답을 바꿔버린다. 23개 모델 모두 평균 17.1포인트 정확도가 떨어졌다. 어떻게 풀었나 — 같은 문제를 힌트 없음/틀린 힌트/맞는 힌트/무관한 힌트 4가지로 만들어, 틀린 힌트에 흔들리지 않으면서 맞는 힌트는 잘 쓰도록 선호 학습을 시켰다. 그래서 뭐가 좋아졌나 — 틀린 힌트로 인한 오답 전환율(SC2W)이 절반 가까이 줄고, 정확한 힌트를 줬을 때 성능은 그대로 유지됐다. ...
2026년 8월 7일 · 5 분 · 954 단어 · TechLLM
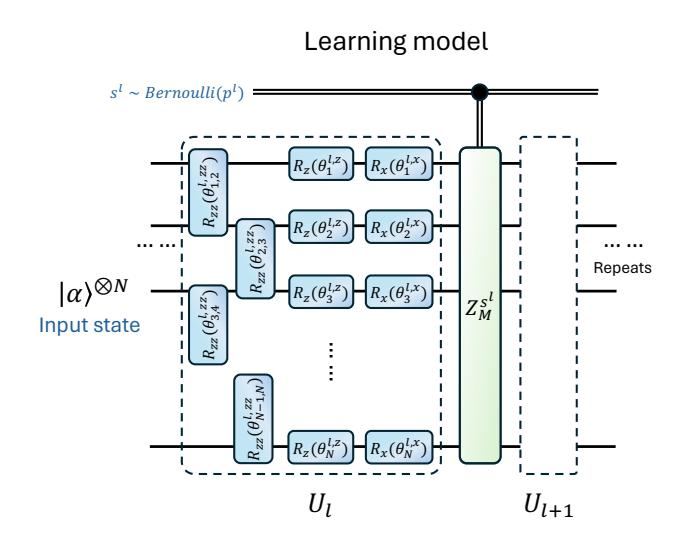
공유 난수 비트 s가 제어하는 Pauli-Z 문자열이 중간 층에 삽입되는 shallow channel 학습 모델

아주 얕은 양자 회로로도, 멀리 떨어진 두 큐비트의 결과를 하나의 동전 던지기로 연결하면 더 깊은 회로에서나 가능한 상관관계를 만들 수 있다는 것을 증명한 논문

아주 얕은 양자 회로로도, 멀리 떨어진 두 큐비트의 결과를 하나의 동전 던지기로 연결하면 더 깊은 회로에서나 가능한 상관관계를 만들 수 있다는 것을 증명한 논문 무엇이 문제였나 — 짧고 얕은 양자 회로는 가까운 이웃끼리만 연결되어 멀리 떨어진 출력 사이 상관관계를 만들 수 없다. 어떻게 풀었나 — 회로 중간에 하나의 공유된 무작위 비트로 멀리 떨어진 두 곳의 Pauli 연산을 동시에 적용하는 채널 모델을 도입했다. 그래서 뭐가 좋아졌나 — 양자 깊이나 장거리 게이트를 추가하지 않고도 shallow 회로가 만들 수 있는 분포의 가족이 엄격하게 더 넓어졌다. ...

2026년 8월 7일 · 5 분 · 983 단어 · TechLLM