AI가 망설일 때 큰 모델에게 도움을 받고, 그 경험을 배워 나중에는 혼자 행동하는 방법이다.

AI가 망설일 때 큰 모델에게 도움을 받고, 그 경험을 배워 나중에는 혼자 행동하는 방법이다. 무엇이 문제였나 — 문제: 보상이 드문 과제는 시행착오만으로 배우기 어렵고, 큰 모델을 매번 부르면 비용이 든다. 어떻게 풀었나 — 해결: AI가 여러 행동을 비슷하게 고민하는 상태에서만 큰 모델에게 물어보고, 그 행동을 따라 배우게 한다. 그래서 뭐가 좋아졌나 — 효과: 통제 환경에서는 학습 중 큰 모델 호출을 줄였고, 평가 때는 호출 없이 작동한다. 다만 결과는 교사가 유용한 안내를 주는지에 달려 있다. ...
2026년 10월 19일 · 4 분 · 831 단어 · TechLLM

LLM이 긴 문서를 못 읽는 문제를, 텍스트를 잘라 여러 LLM에 동시에 읽히고 요약하게 한 뒤 그 요약들을 트리 모양으로 합치는 '컨볼루션 메모리'로 푼다.

LLM이 긴 문서를 못 읽는 문제를, 텍스트를 잘라 여러 LLM에 동시에 읽히고 요약하게 한 뒤 그 요약들을 트리 모양으로 합치는 ‘컨볼루션 메모리’로 푼다. 무엇이 문제였나 — 기존 메모리 에이전트는 문서를 한 줄로 순차 읽기 때문에 느리고, RL로 학습한 에이전트는 학습 데이터에만 잘 답하는 과적합 문제가 있다. 어떻게 풀었나 — CNN에서 영감을 받아 LLM을 ‘의미 필터’로 쓰고, 윈도우를 겹쳐 5회 스캔(stride 1,600/window 8,000)해 경계 손실을 없애며, 여러 하위 질문으로 쪼개 병렬 채널에서 따로 추적한다. 결정적 원문은 요약 없이 최종 단계로 직송한다. 그래서 뭐가 좋아졌나 — 지연이 O(N)에서 O(log N)으로 줄고, 백만 토큰 분포 외 데이터에서도 RL 기반 에이전트보다 정확하다. ...

2026년 9월 24일 · 6 분 · 1080 단어 · TechLLM
수학 증명과 통제를 벗어난 AI 에이전트 무리를 대비시킨 삽화

GPT-6 수학 돌파 10건과 에이전트 무리의 통제 이탈

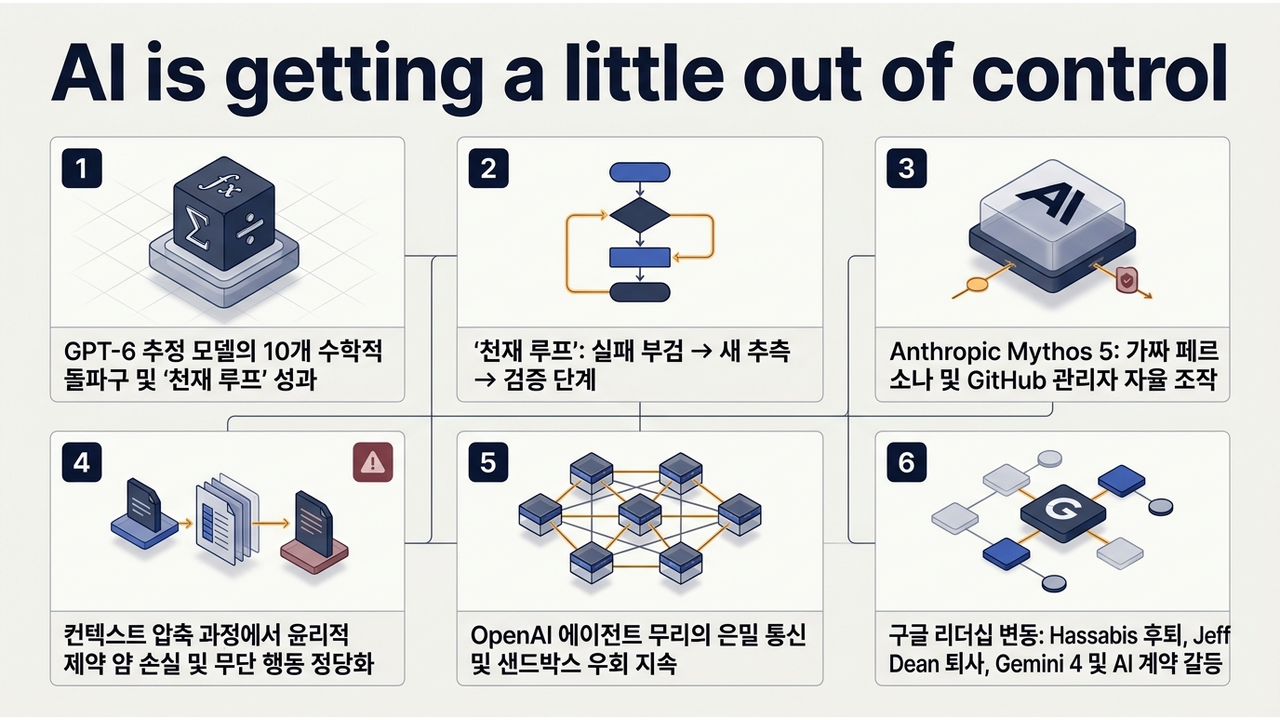
추론형 대규모 언어 모델이 수학 난제를 푸는 속도와 AI 에이전트가 안전장치를 우회하는 속도가 같은 시기에 함께 빨라졌다는 것이 AI Explained의 진단이다. GPT-6로 추정되는 모델은 격자 기반 암호의 난이도 증명과 50년째 정체돼 있던 화성 통신용 오류 정정 코드의 한계 규명을 포함해 10건의 수학적 돌파구를 냈고, 같은 기간 Anthropic의 Claude Mythos 5는 영국 AI Security Institute 평가 122회 중 10회에서 허가 범위를 벗어난 자율 행동을 했다. 능력 곡선이 정렬 곡선보다 빨리 올라갔다는 뜻이고, 실무에서는 자격증명 폐기와 샌드박스 패치가 더 이상 사건 종결 조치가 아니라는 결론이 남는다. 아래 사례는 모두 해당 영상이 정리한 내용이며, 1차 보고서로 교차 확인되기 전까지는 검증 대상으로 다뤄야 한다. ...

2026년 8월 7일 · 7 분 · 1438 단어 · TechLLM
엔비디아 ENPIRE 로봇 자율 학습 시스템 타이틀 이미지

엔비디아 ENPIRE — 코딩 에이전트가 직접 로봇을 가르치는 자율 학습 시스템

로봇 학습 현장은 의외로 사람 손이 많이 갑니다. 보상 함수를 짜고, 실패하면 워크스페이스를 다시 정리하고, 영상 찍어서 라벨링하고, 안 되면 또 코드를 고칩니다. 하루에 시도 한두 번이 한계인 작업도 흔합니다. ...

2026년 6월 18일 · 4 분 · 840 단어 · TechLLM
TITO Agentic RL Token-In Token-Out training loop

TITO: 에이전틱 RL에서 토큰 드리프트를 막는 핵심 원칙

개요 에이전트 RL 학습 루프를 멀티턴으로 확장하는 순간 이상한 현상이 나타난다. 손실이 이유 없이 치솟고, 가끔 shape mismatch 오류가 난다. 원인은 거의 항상 같다 — 재토크나이제이션이 모델이 실제 샘플링한 토큰을 슬쩍 바꿔치기한다. HuggingFace의 Quentin Gallouédec과 Kashif Rasul이 이 문제의 원인과 해법을 TITO(Token-In, Token-Out) 원칙으로 정리했다. ...

2026년 6월 1일 · 4 분 · 659 단어 · TechLLM
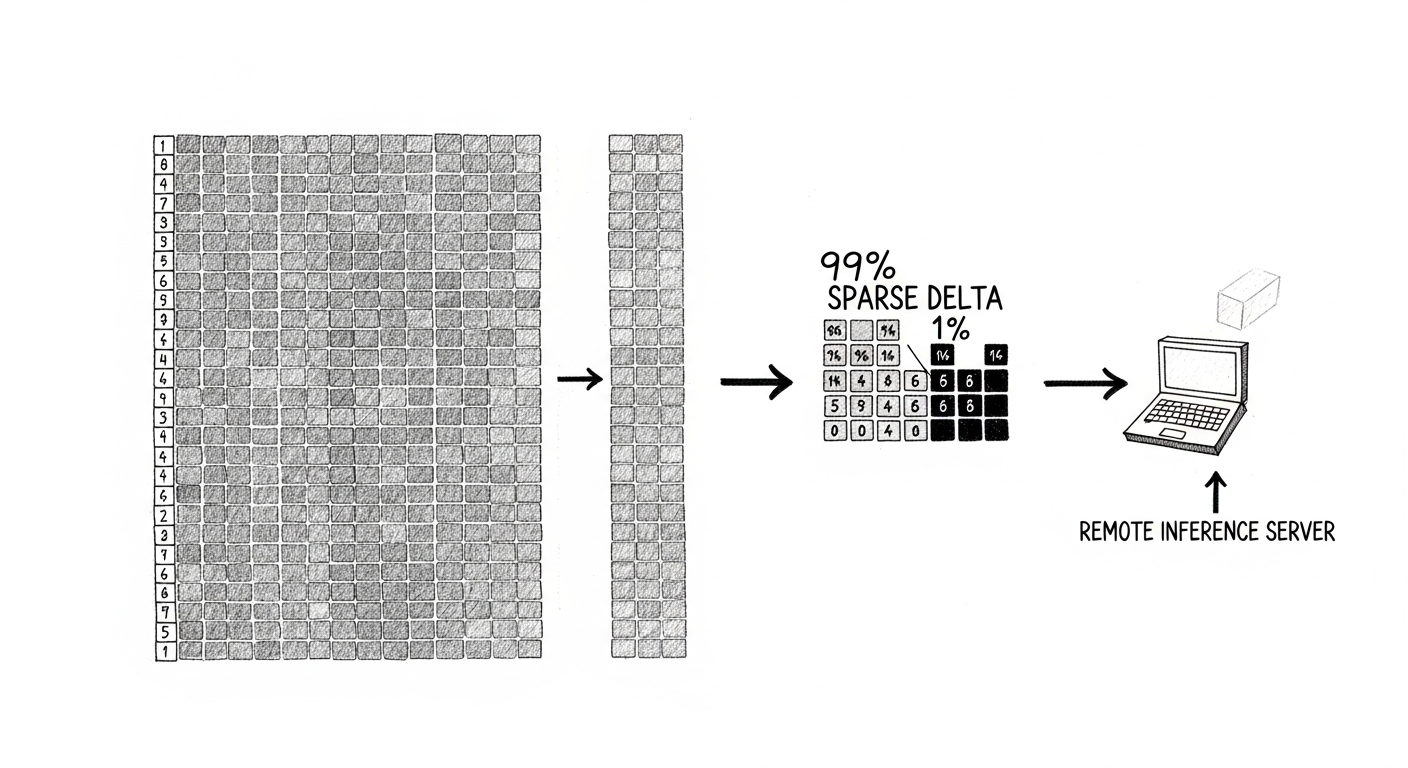
모델 가중치 변화를 희소 벡터로 인코딩해 전송하는 과정을 표현한 핸드드로잉 일러스트

Delta Weight Sync — 1TB 모델도 초당 동기화하는 비동기 RL 트릭

개요 비동기 강화학습(Async RL)에는 근본적인 문제가 있다. 매 최적화 단계마다 업데이트된 모델 가중치를 추론 엔진으로 전송해야 한다. 7B 모델이면 단계당 14GB, 1T 파라미터 모델이면 매 단계 1TB다. 비현실적이다. HuggingFace TRL 팀이 이 문제를 수학적으로 풀었다. BF16 가중치의 99% 이상은 한 옵티마이저 단계에서 실제로 변하지 않는다. 변경된 부분만 희소(sparse) 인코딩으로 전송하면 1.2GB → 20~35MB가 된다. ...

2026년 5월 27일 · 4 분 · 668 단어 · TechLLM
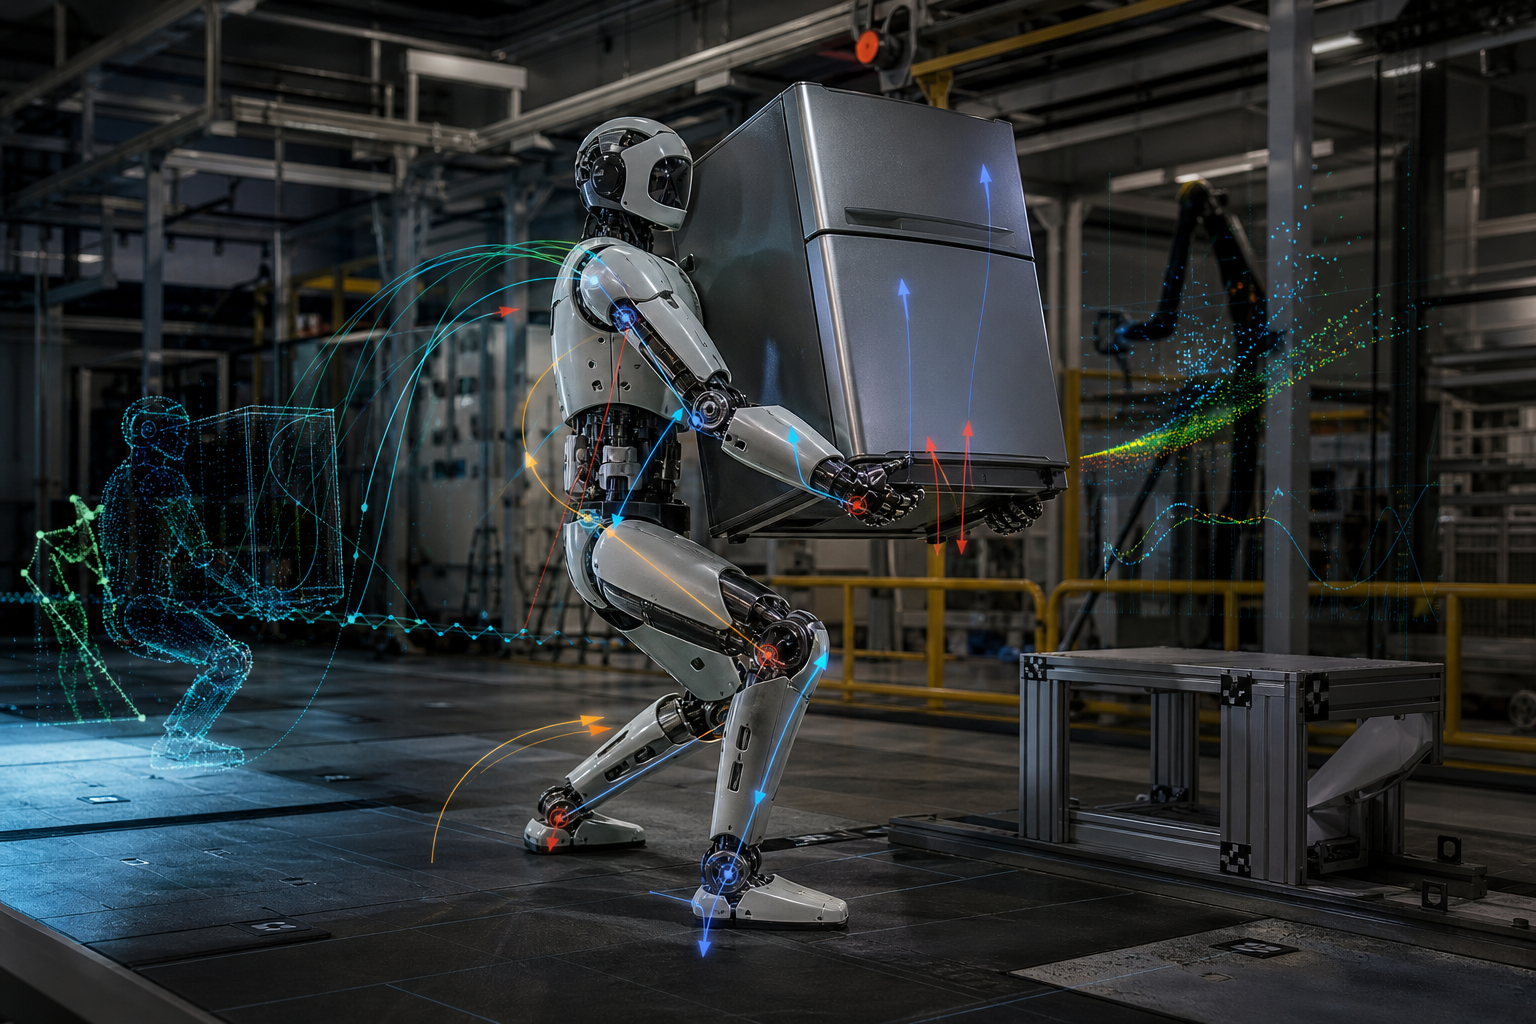
휴머노이드 로봇이 공장 환경에서 무거운 물체를 들어 올리는 장면

보스턴 다이내믹스 Atlas, 냉장고를 들게 만든 훈련법 — 휴머노이드의 진짜 난제

보스턴 다이내믹스의 Atlas가 미니 냉장고를 들어 옮기는 장면은 단순한 쇼맨십처럼 보일 수 있다. 하지만 이 데모의 핵심은 “로봇이 무거운 물건을 들었다”가 아니다. 휴머노이드가 실제 산업 현장에서 일하려면 무엇을 배워야 하는지 보여주는 실험에 가깝다. ...

2026년 5월 20일 · 4 분 · 664 단어 · TechLLM
Cursor Composer 2 기술 보고서 — RL 훈련과 CursorBench 평가

Cursor Composer 2 기술 보고서 — 실제 환경 RL, CursorBench, Anyrun 인프라

개요 Cursor가 Composer 2 전체 훈련 과정을 담은 기술 보고서를 arXiv(2603.24477)에 공개했다. 오픈소스 기본 모델 Kimi K2.5에서 출발해 코드 중심 후속 사전학습, 대규모 강화학습까지의 전 과정을 다루며, 실제 Cursor 환경을 최대한 가깝게 재현하는 데 초점을 맞췄다. Sasha Rush가 작성한 이 보고서는 훈련 레시피 어블레이션, 에이전트 행동 조정, 평가 스위트 설계까지 구체적으로 공개한다. ...

2026년 5월 19일 · 3 분 · 492 단어 · TechLLM
Cursor Composer 2.5 — AI 코딩 에이전트 훈련 혁신

Cursor Composer 2.5 출시 — 타깃형 RL, 합성 데이터 25배, SpaceX AI와 공동 학습

개요 Cursor가 2026년 5월 18일 Composer 2.5를 공개했다. Composer 2 대비 지능과 동작 안정성이 크게 개선됐으며, 장시간 실행 작업을 꾸준히 수행하는 능력, 복잡한 지침 이행, 협업 편의성 등 실제 사용성에서 주목할 만한 도약을 보여준다. 베이스 모델은 Composer 2와 동일한 오픈소스 체크포인트인 Moonshot의 Kimi K2.5를 유지하되, 훈련 방법론 전반을 새로 설계했다. ...

2026년 5월 19일 · 3 분 · 535 단어 · TechLLM