개요
Zyphra가 6월 12일에 Zamba2-VL을 풀었습니다. 1.2B, 2.7B, 7B 세 가지 크기를 같이 공개했고, 가중치와 코드 모두 Apache 2.0 라이선스입니다. 뼈대가 좀 특이합니다. 같은 크기의 다른 오픈 VLM이 거의 다 트랜스포머만 쓰는 데 비해, Zamba2-VL은 Mamba2 SSM 블록 위에 소수의 공유 트랜스포머 블록을 끼워 넣은 하이브리드입니다. 그 결과가 글 제목 그대로입니다. 32k 토큰짜리 긴 입력을 받았을 때, 첫 토큰이 돌아올 때까지 걸리는 시간이 비슷한 크기 트랜스포머 VLM 대비 약 1/6 수준으로 떨어집니다.
핵심 요약
- 모델 가족: Zamba2-VL 1.2B / 2.7B / 7B. Mistral v0.1 토크나이저를 그대로 가져왔습니다.
- 비전 인코더: Qwen2.5-VL의 ViT를 2D 회전 임베딩(RoPE)과 함께 사용. 인코더 출력은 2층 MLP 어댑터로 언어 모델 쪽에 붙입니다.
- 언어 백본: 선형 시간으로 도는 Mamba2 레이어 사이에 공유 트랜스포머 블록을 드문드문 끼우고, 각 블록마다 LoRA 어댑터를 따로 둡니다.
- 학습 데이터: 공개 웹에서 모은 100B 토큰(비전-텍스트 + 순수 텍스트 혼합).
- 속도: 32k 프리필 기준 TTFT가 같은 급 트랜스포머 VLM보다 약 한 자릿수(≈10×) 낮음. 산점도상 Zamba2-VL-7B는 약 400ms, 비교 대상 Qwen3-VL-8B는 약 2,300ms.
- 벤치마크(2.7B): DocVQA 90.9, ChartQA 79.6, PixMoCount 82.5(InternVL3.5-2B 32.8 대비 2배 이상), CountBenchQA 87.5.
- 약점: MMMU(val) 37.7, MathVista 51.0으로 지식·수리 추론은 같은 급 Qwen3-VL-4B에 밀립니다. OCRBench도 73.6으로 InternVL3.5-2B(83.4)보다 낮습니다.
아키텍처 — 왜 첫 토큰이 빠른가
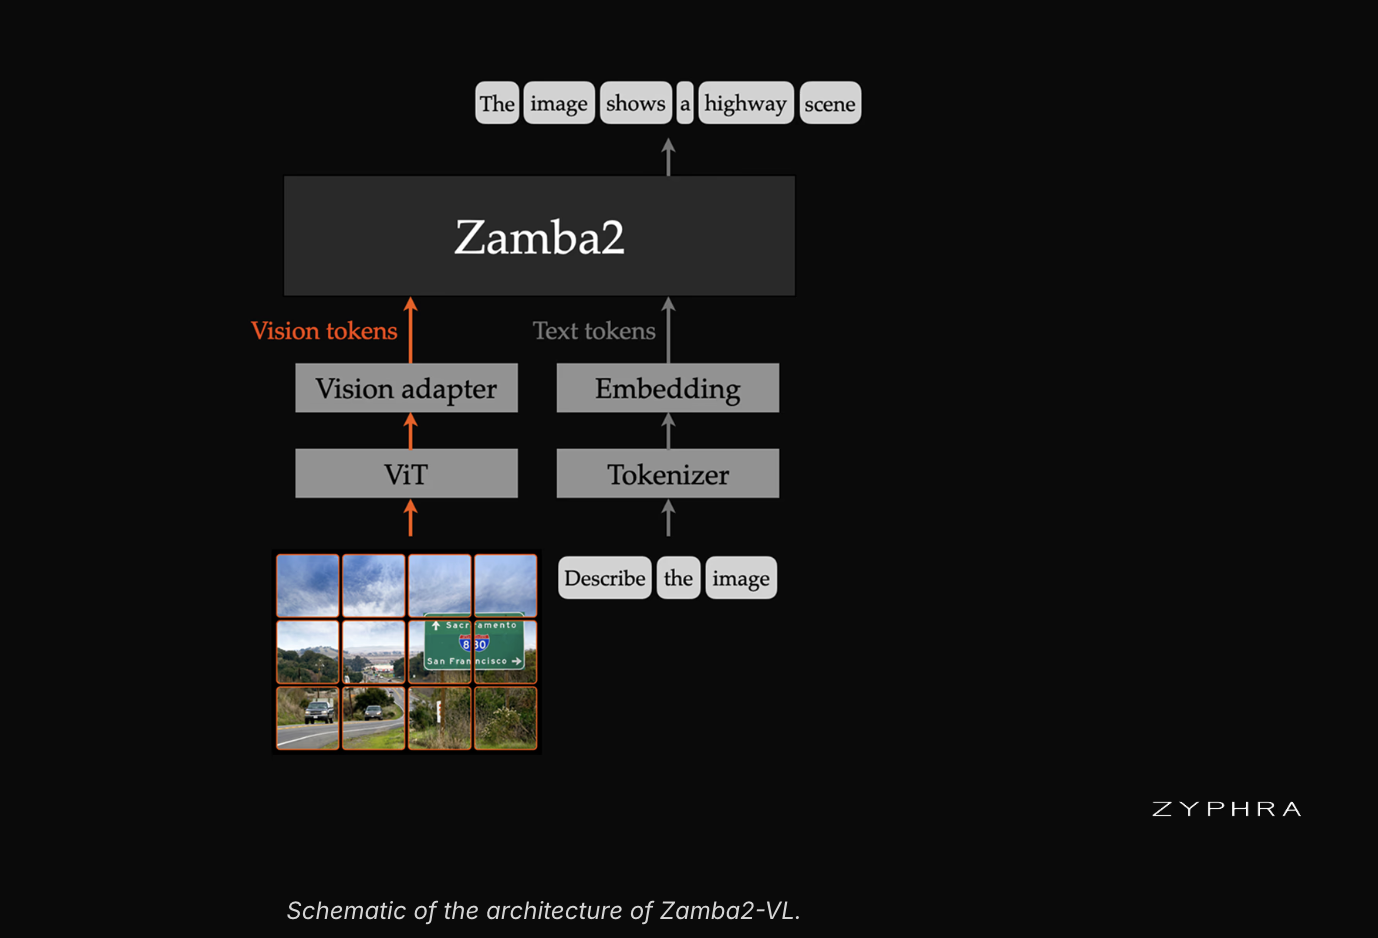
VLM에서 가장 부담스러운 구간은 보통 **프리필(prefill)**입니다. 이미지 한 장이 토크나이저 입장에서는 수백~수천 개의 비전 토큰으로 풀리고, 거기에 사용자 프롬프트가 더 붙습니다. 풀 어텐션 트랜스포머는 이 구간에서 시퀀스 길이의 제곱으로 비용이 늡니다. 입력이 길어질수록 첫 토큰을 토하기까지 점점 더 오래 걸린다는 뜻입니다.
Zamba2의 백본은 이 부분을 다르게 풉니다.
- Mamba2 레이어가 대부분을 차지합니다. 상태 공간 모델(SSM)이라 시퀀스 길이에 대해 선형 시간으로 돌고, 상태 크기는 고정입니다. KV 캐시처럼 끝없이 늘어나는 메모리가 없습니다.
- 그 사이에 공유 트랜스포머 블록을 띄엄띄엄 끼웁니다. 공유라는 말은 같은 파라미터를 여러 자리에서 재사용한다는 뜻입니다. 다만 자리마다 LoRA 어댑터를 따로 달아, 위치별 미세 차이를 잡습니다.
- 이렇게 하면 트랜스포머의 표현력은 어느 정도 살리면서 어텐션이 만드는 비용 폭발을 피할 수 있습니다.
비전 쪽은 Qwen2.5-VL에서 검증된 ViT를 그대로 끌어다 썼습니다. 어댑터는 단순한 2층 MLP입니다. 새로운 비전 모델을 처음부터 학습한 게 아니라, 언어 백본 쪽 혁신에 집중한 모양새입니다.
TTFT 한 자릿수, 산점도로 보기
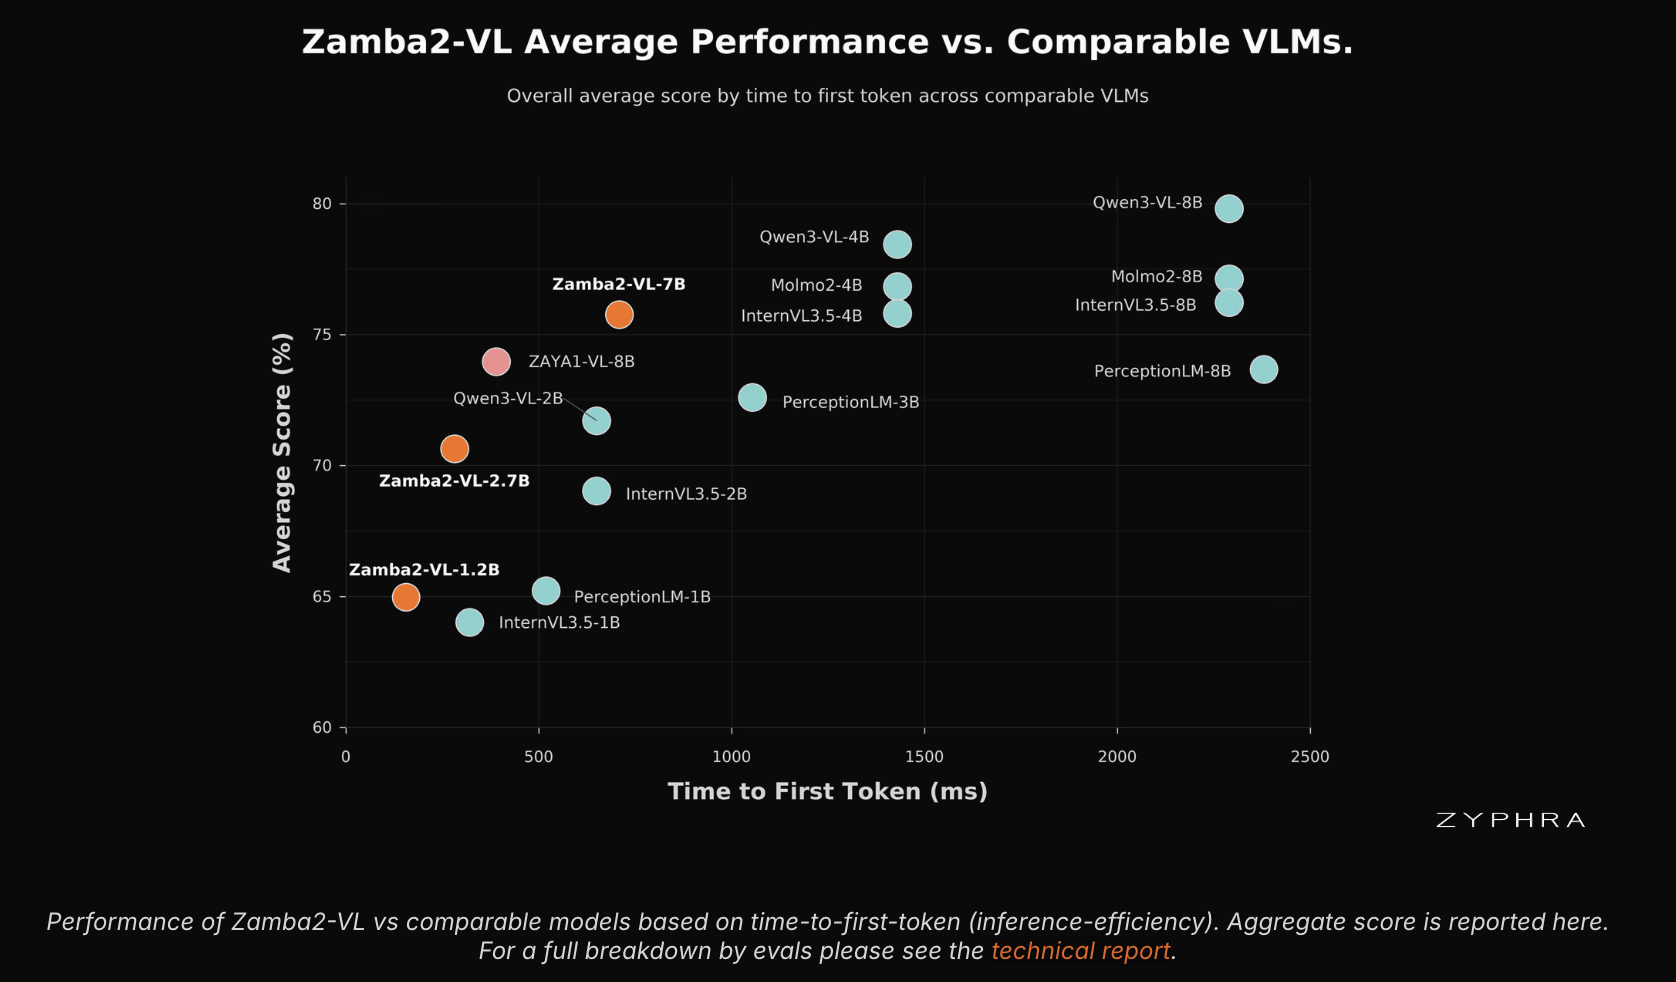
Zyphra가 공개한 산점도가 핵심을 한 장에 다 담습니다. 가로축은 첫 토큰까지 걸리는 시간(ms), 세로축은 평균 점수입니다. 같은 점수 라인에서 보면 Zamba2-VL이 왼쪽 끝에 몰려 있습니다.
- Zamba2-VL-7B(약 400ms, 76%)는 점수상 Qwen3-VL-4B·Molmo2-4B와 붙는데, TTFT는 5~6배 빠릅니다.
- Zamba2-VL-2.7B(약 300ms, 70%)는 InternVL3.5-2B와 비슷한 점수지만 TTFT는 절반 이하입니다.
- Zamba2-VL-1.2B(약 150ms, 65%)는 온디바이스 영역을 노린 크기입니다. PerceptionLM-1B·InternVL3.5-1B와 같은 점수대인데 가장 빠릅니다.
문제는 점수 상한입니다. 위쪽 80% 구간에는 Qwen3-VL-8B·Molmo2-8B가 자리 잡고 있고, Zamba2-VL은 아직 거기까지는 못 갑니다. 빠른 응답이 더 중요한 시나리오인지, 마지막 1~2점 더 끌어올리는 게 중요한 시나리오인지에 따라 선택이 갈립니다.
잘 하는 것과 못 하는 것
2.7B 모델 기준으로 항목을 나눠 보면 그림이 더 분명합니다.
시각 카운팅과 문서 이해에 강합니다.
- PixMoCount 82.5 — 같은 급 InternVL3.5-2B의 32.8 대비 두 배 반. 영수증 항목 수 세기, 매장 진열 수량 점검처럼 개수 세는 작업에서 큰 차이가 납니다.
- CountBenchQA 87.5, DocVQA 90.9, ChartQA 79.6 — 표·차트·서식 같은 정형 문서 쪽이 안정적입니다.
지식·수리 추론은 같은 급에 비해 약합니다.
- MMMU(val) 37.7 vs Qwen3-VL-4B 51.4. 학술 시각 추론에서 13점 이상 벌어집니다.
- MathVista(mini) 51.0 vs Qwen3-VL-4B 63.6. 수학 시각 추론도 비슷한 격차.
- OCRBench 73.6 vs InternVL3.5-2B 83.4. 글자 인식 정확도는 오히려 더 낮습니다.
OCR과 수리 추론은 학습 데이터와 후처리(post-training) 비중을 늘리면 끌어올릴 수 있는 항목입니다. 첫 공개 버전의 점수라는 점을 감안하고 봐야 합니다.
실무자가 볼 핵심 포인트
- 온디바이스를 보고 있다면 1.2B. ARM·노트북에서 응답성이 결과를 좌우하는 어시스턴트 시나리오라면 TTFT 150ms대가 큰 무기입니다. 단, CUDA 커널이 빠른 경로라 CPU에서는 같은 속도가 안 나옵니다.
- 백오피스 문서 자동화에는 2.7B. 영수증·송장·재고 사진처럼 개수를 세고 표·차트를 읽어내는 작업에 잘 맞습니다. DocVQA·ChartQA·PixMoCount 점수가 그걸 뒷받침합니다.
- 지식형 시각 QA가 핵심이면 신중하게. MMMU·MathVista 점수가 받쳐주지 않습니다. 학술 문제 풀이나 복잡한 다단계 추론은 Qwen3-VL 계열을 같이 봐두는 게 안전합니다.
- 인프라 비용 절감 효과는 프리필이 길수록 큽니다. 멀티페이지 PDF, 고해상도 이미지처럼 토큰이 많이 풀리는 입력일수록 한 자릿수 TTFT 차이가 그대로 비용으로 돌아옵니다.
- 셀프 호스팅 부담은 있습니다.
flash_attn,causal_conv1d,mamba_ssm커스텀 포크가 필요하고, Transformers v4.57.1 기반 코드를 직접 받아 돌려야 합니다. 매니지드 API로는 아직 안 풀려 있습니다.
정리
Zamba2-VL은 “점수 한 줄 위에 올라간 모델“이 아니라 같은 점수대에서 응답 시간을 갈아 끼운 모델입니다. 어텐션을 통째로 SSM으로 바꾸지 않고, 트랜스포머 블록을 공유 형태로 남겨 표현력을 챙긴 절충도 합리적입니다. 학술 추론 점수는 다음 릴리스에서 채워야 할 숙제로 남아 있지만, 영수증 카운팅이나 멀티페이지 PDF 같은 현장 작업부터 보면 지금 당장 써볼 만한 카드가 하나 늘었습니다.
원문 출처
- 원문 기사: Zyphra Release Zamba2-VL — MarkTechPost (2026-06-12)
- 기술 보고서: zyphra.com/our-work/zamba2-vl
- 코드: github.com/Zyphra/transformers (zamba2-vl 브랜치)
- 가중치: Hugging Face — Zyphra Zamba2-VL 컬렉션