코딩 에이전트가 한두 번 답을 잘 내놓는 건 이제 새롭지 않습니다. 진짜 문제는 그다음입니다. 30턴, 50턴 넘어가면 슬슬 헛소리가 시작됩니다. 앞에서 뭘 했는지 흐려지고, 끝났다고 멋대로 손을 떼버리고, 컨텍스트 창은 어느새 가득 찹니다.
샤오미 MiMo 팀이 6월 10일 공개한 ‘MiMo Code’는 정확히 이 지점을 정조준한 터미널 코딩 에이전트입니다. OpenCode를 기반으로 MIT 라이선스로 풀린 오픈소스고, 짧은 작업이 아니라 ‘오래 가는’ 작업(long-horizon task)을 위해 처음부터 다시 설계했다는 게 핵심입니다.
개요
MiMo Code는 세 가지 기둥 위에 서 있습니다. 연산(Computation), 메모리(Memory), 진화(Evolution). 단순히 모델만 좋게 만든 게 아니라, 모델을 둘러싼 런타임이 어떻게 일을 분담하느냐를 다시 짰습니다. 결과는 동일한 모델로도 긴 작업에서 훨씬 안정적으로 돌아가는 에이전트입니다.
핵심 요약
- 세 가지 병목을 명확히 분리. 단일 턴 의사결정 = 연산, 다중 턴 연속성 = 상태 관리, 세션 간 개선 = 경험 축적.
- Max Mode: 한 턴에 5개 후보를 동시에 만들고 저온도 심판이 고름. SWE-Bench Pro에서 10
20% 향상, 토큰은 45배. - Goal 검증기: ‘모든 테스트 통과 + 커밋’ 같은 종료 조건을 별도 모델이 확인. 무한 루프 확률 0.5% 미만.
- Cycle 구조: 컨텍스트가 차기 전에 writer 서브에이전트가 상태를 디스크에 적어두고, 한도 직전에 창을 닫고 새 창에 재주입. 세션이 사실상 끝없이 이어집니다.
- 4계층 메모리: session / project(MEMORY.md) / global / history(SQLite 전체 원본).
- Dream(7일)·Distill(30일): 흩어진 기억을 압축·정리하고, 반복되는 패턴은 스킬·CLI 명령으로 굳힘.
- 사람 더블블라인드 A/B: 개발자 576명, 실제 사설 저장소 474개, 판정 가능한 페어 1,213건. 200스텝 이하에서는 박빙이지만, 200스텝을 넘기면 MiMo Code 승률이 65% 이상으로 올라갑니다.
본문
연산 — 한 턴을 진짜로 잘 두기
가장 눈에 띄는 건 Max Mode입니다. 같은 턴에 후보 다섯 개를 병렬로 생성하고, 각자 추론과 도구 호출 계획까지 따로 짭니다. 실제 실행은 안 합니다. 그다음 저온도 심판 모델이 다섯 개를 비교해서 가장 견고한 한 개를 고릅니다. 토큰을 45배 쓰지만, SWE-Bench Pro에서 1020%포인트가 더 붙습니다. 어려운 한 수에 자원을 몰아주는 방식입니다.
Goal 검증기는 ‘에이전트가 일을 너무 일찍 끝내는’ 고질병에 대한 답입니다. 사용자가 자연어로 “모든 테스트 통과하고 커밋까지” 같은 종료 조건을 적어둡니다. 에이전트가 ‘끝났다’고 선언하려는 순간, 또 다른 독립된 모델이 같은 컨텍스트를 받아서 정말로 조건을 만족했는지 따로 확인합니다. 일치하지 않으면 어디가 모자란지 구체적으로 짚어 다시 일하게 시킵니다. 통과돼야 할 걸 막아세우는 false-block이 그 반대보다 자주 나오는데, 대부분 환경 문제로 인한 테스트 실패라고 합니다.
도구 호출 문법도 흥미롭습니다. JSON이나 XML이 아니라 셸 비슷한 명령어 문법을 일부러 제한적으로 씁니다. 모델이 셸 환경 데이터를 워낙 많이 봤기 때문에 토큰이 적게 들고 포맷 오류도 덜합니다. 단, 파이프·리다이렉션·변수 치환은 못 쓰게 막아뒀습니다. 자유도를 줄여서 안전을 산 셈입니다.
대규모 병렬 오케스트레이션인 Dynamic Workflow는 한 발 더 나갑니다. 자연어 프롬프트에 흐름 제어를 맡기지 않고, 메인 에이전트가 JavaScript를 만들어 샌드박스에서 결정론적으로 실행시킵니다. agent()·parallel()·pipeline() 같은 원시 함수로 서브에이전트를 띄우고, 결과는 그때그때 디스크에 동기 기록됩니다. 중간에 죽어도 처음부터 다시 안 돌고 로그에서 이어 붙입니다.
메모리 — 사실상 끝없는 세션
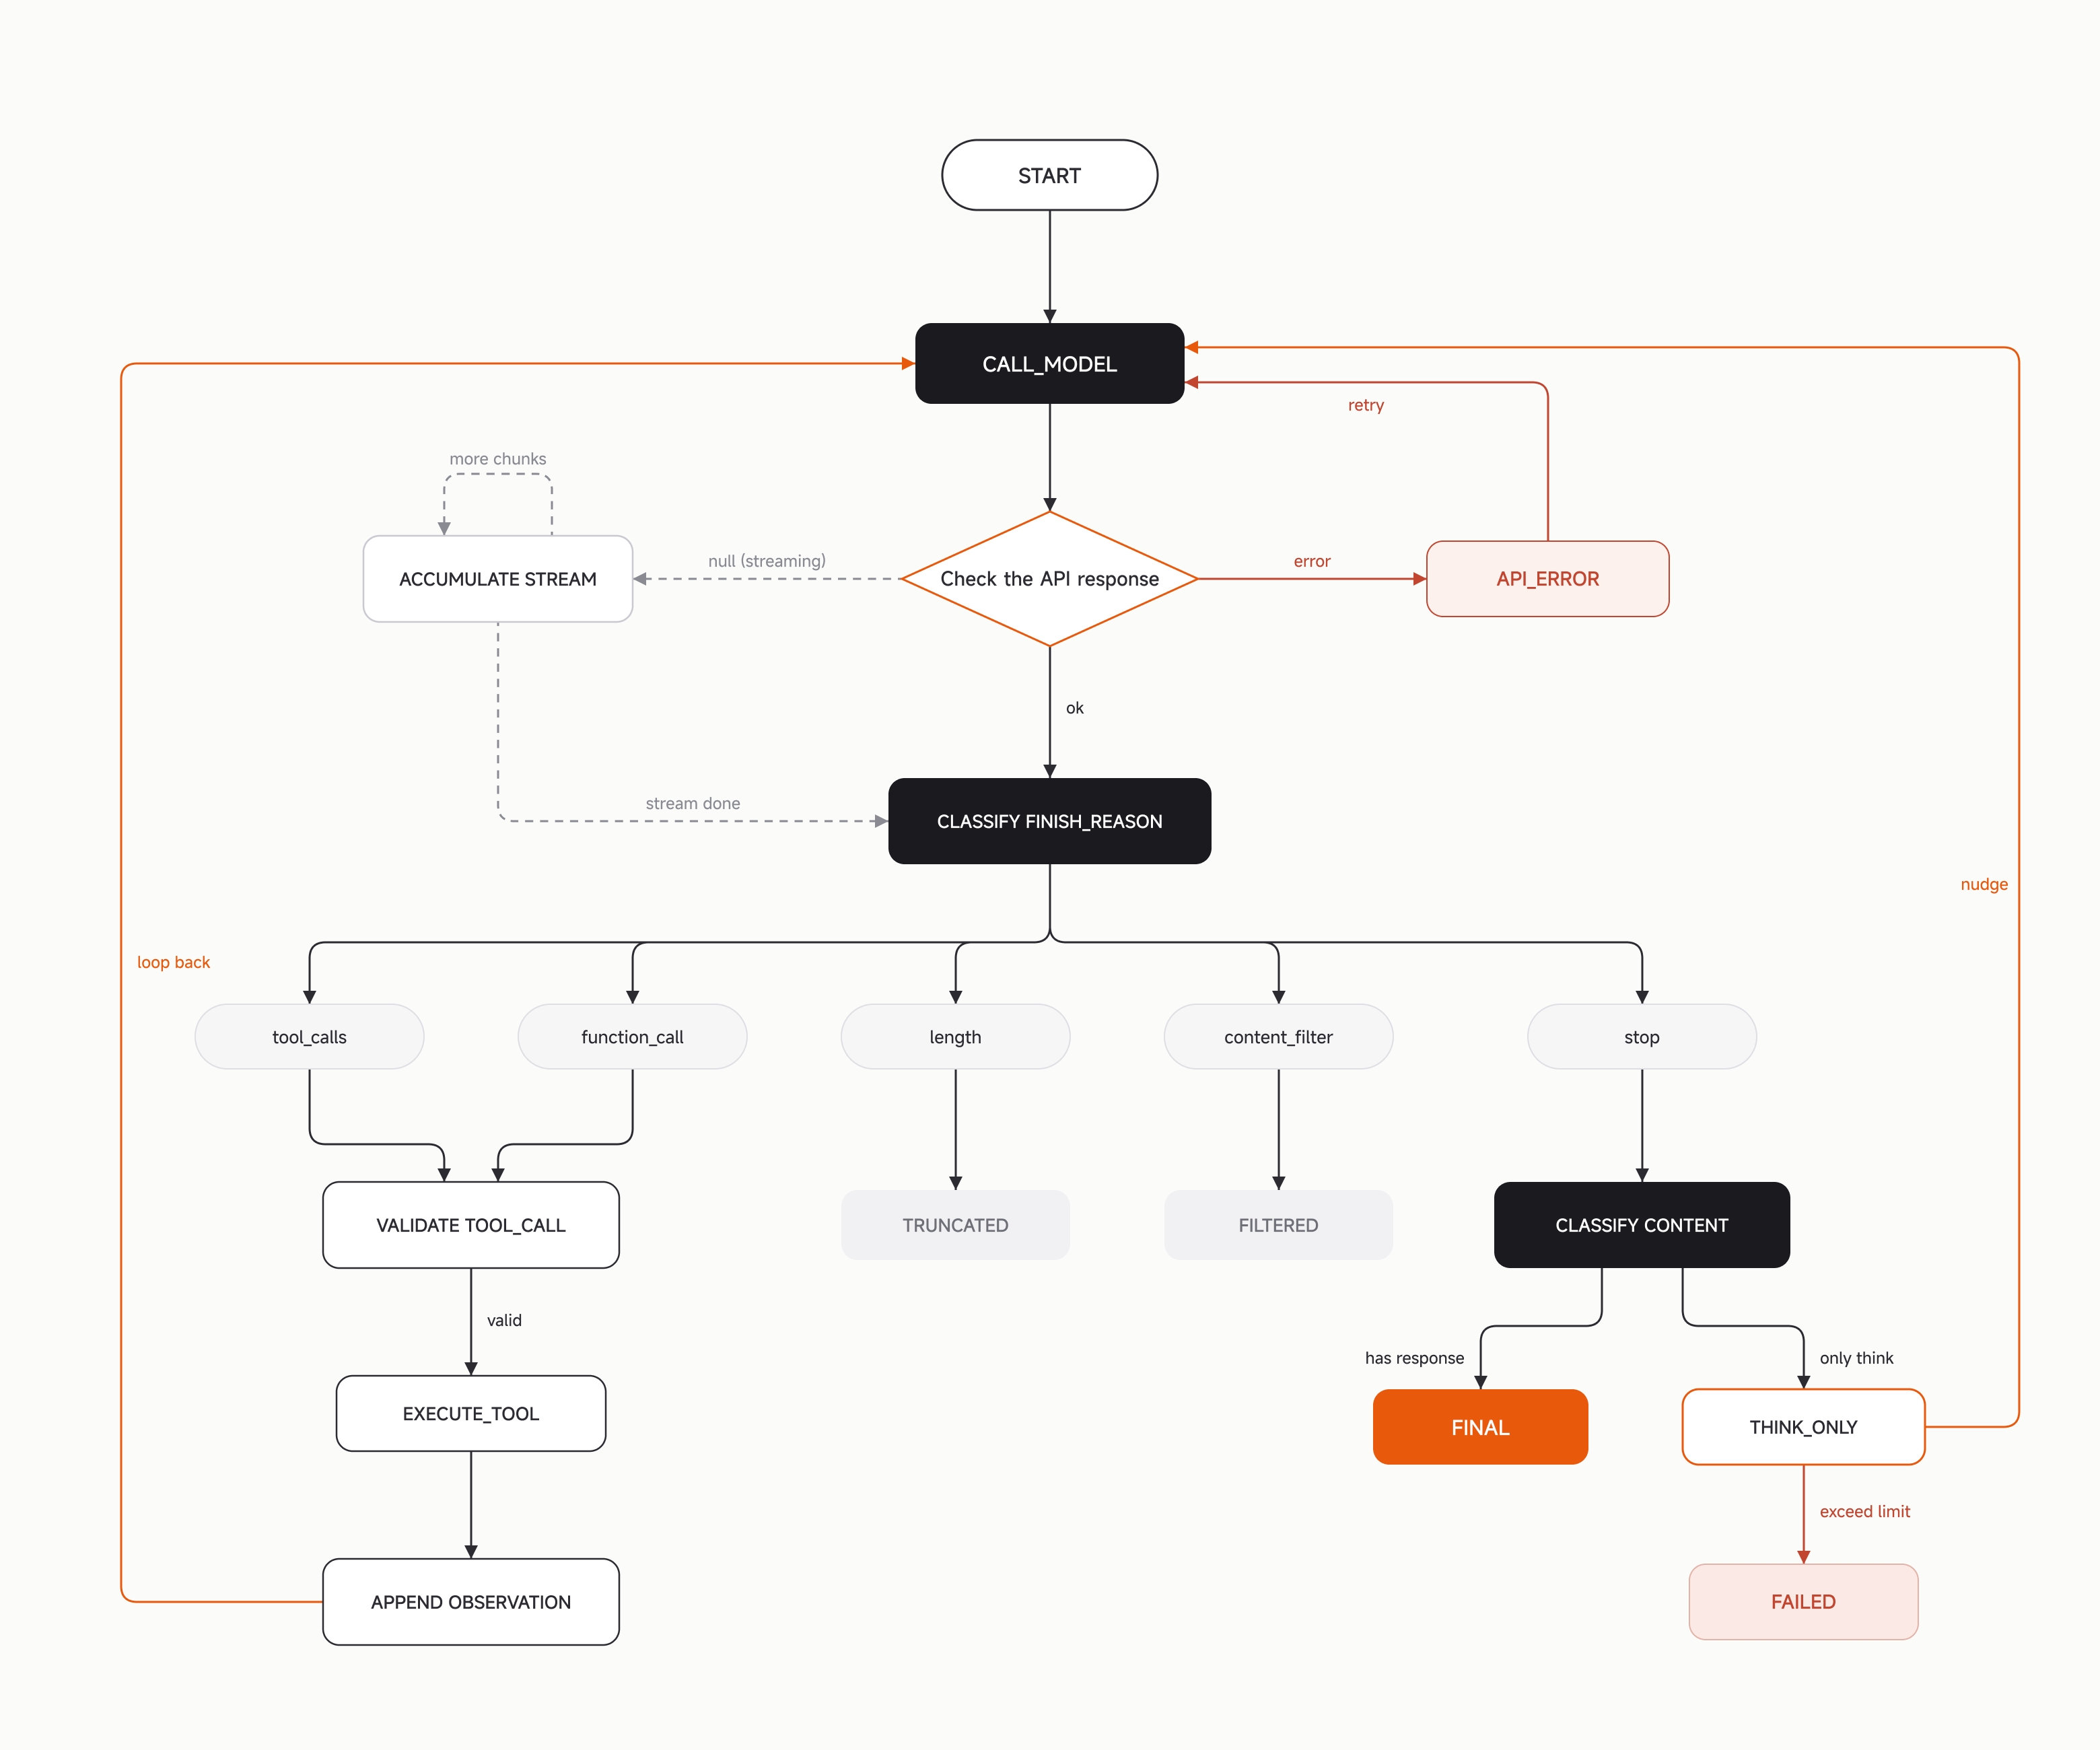
여기가 진짜 핵심입니다. MiMo Code는 컨텍스트 한도를 ‘재구성(rebuild)‘으로 푸는데, 그 단위가 Cycle입니다.
한도가 차오르기 전, 약 20%·45%·70% 지점에서 writer 서브에이전트가 끼어듭니다. 메인 에이전트가 일하는 동안 writer는 따로 대화 이력을 읽고 구조화된 체크포인트 파일을 디스크에 적어둡니다. 한도에 가까워지면 현재 창을 닫고, 적어둔 파일을 씨앗 삼아 새 창에 재주입합니다. 모델 입장에선 대화가 끊긴 적이 없습니다. 런타임 입장에선 새 물리적 창이 열린 거죠.
왜 90%, 95%까지 안 기다리고 일찍 빼느냐. 모델은 컨텍스트가 꽉 차면 ‘중간이 흐려지는(lost in the middle)’ 현상이 심해집니다. 추출 자체도 자원을 쓰는데, 95%에서는 추출할 공간이 없습니다. 30% 시점이면 여유가 있고요. 합리적입니다.
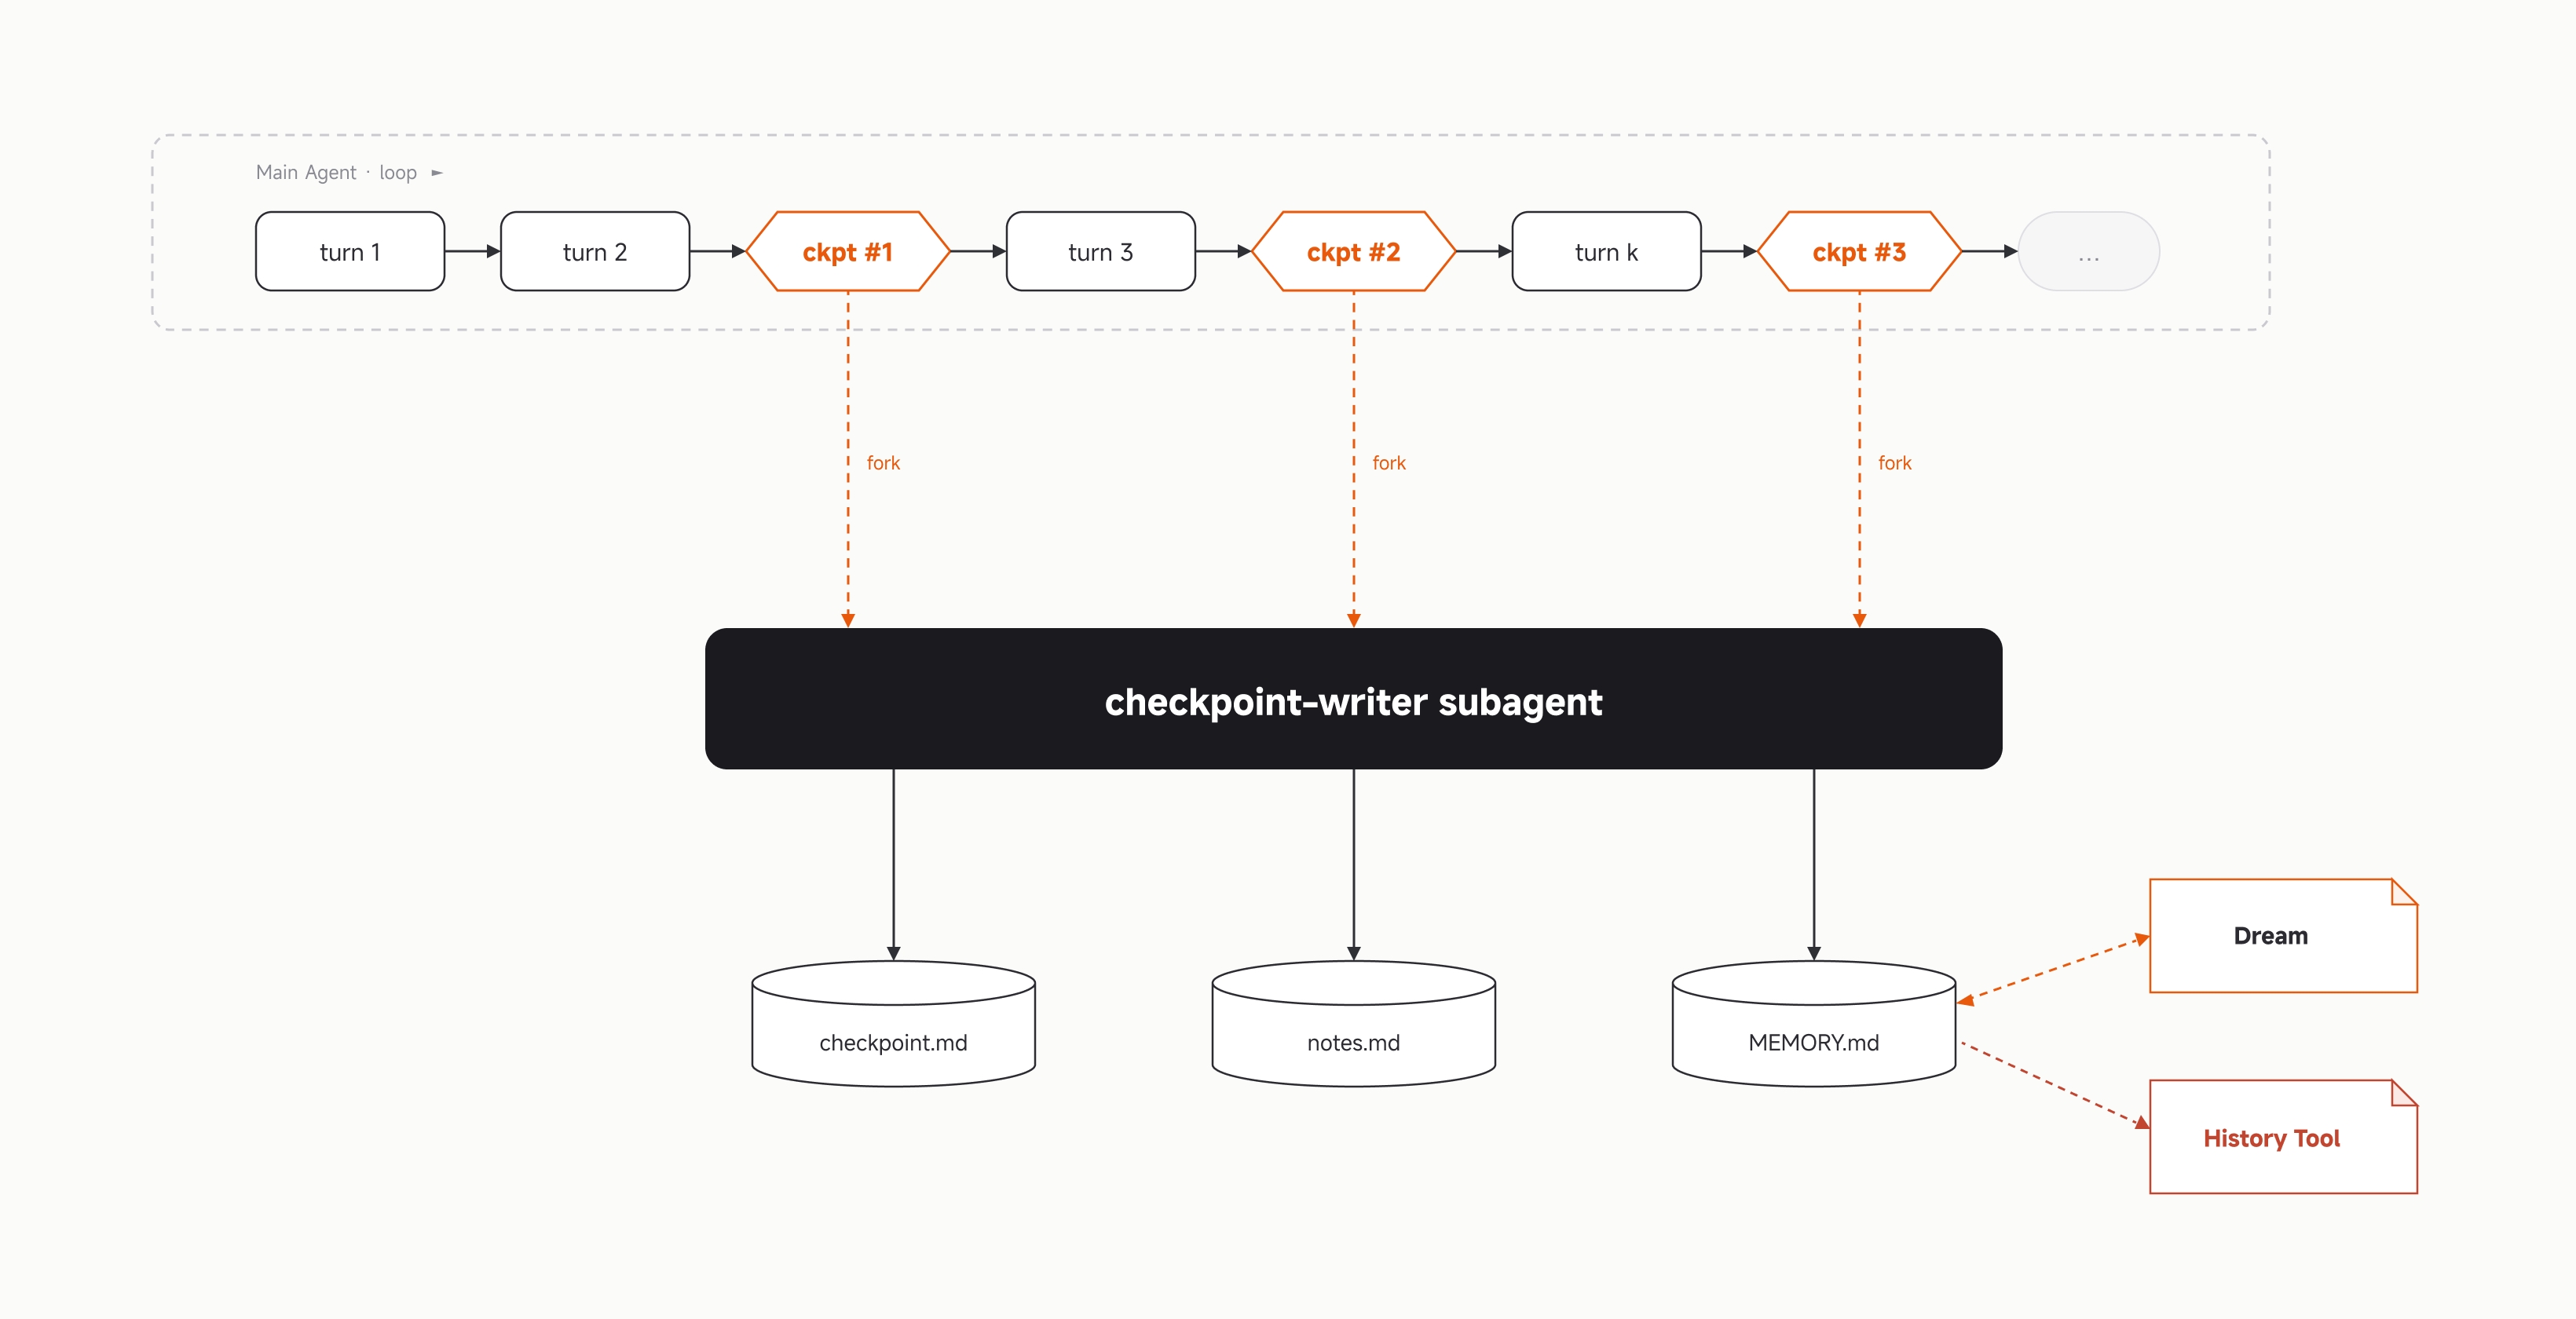
체크포인트에는 11가지 필드가 들어갑니다. 현재 의도, 다음 행동, 작업 제약, 작업 트리, 지금 하는 일, 관련 파일, 교차 발견, 에러와 수정, 런타임 상태, 설계 결정, 기타 메모. 단일 writer만 쓰게 강제해서 동시 수정으로 인한 일관성 깨짐을 막습니다.
메모리는 네 층입니다. session(checkpoint.md)은 현재 세션, project(MEMORY.md)는 프로젝트 영구 지식, global은 사용자 선호, history는 SQLite에 원본 그대로 다 들어갑니다. 위로 갈수록 압축되고 영속적이며, 아래로 갈수록 크고 느립니다. 메인 에이전트는 구조화 파일에 대해 읽기 전용이고, 예외는 자유 메모장인 notes.md 하나입니다. 체크포인트 때 writer가 적절한 필드로 분류해 옮기고 비웁니다.
진화 — 7일과 30일
세션이 끝나도 학습은 이어집니다. Dream은 7일마다 돌면서 흩어진 메모리를 병합·중복 제거·압축합니다. Distill은 30일마다 과거 세션을 분석해 반복되는 작업 패턴을 찾아내 재사용 가능한 스킬, CLI 명령, 커스텀 에이전트, SOP 문서로 굳힙니다. 벡터 DB가 아니라 Markdown 파일이라 사람이 직접 열어보고 틀린 걸 지울 수 있다는 점도 작지만 중요한 결정입니다.
평가는 어떻게 됐나
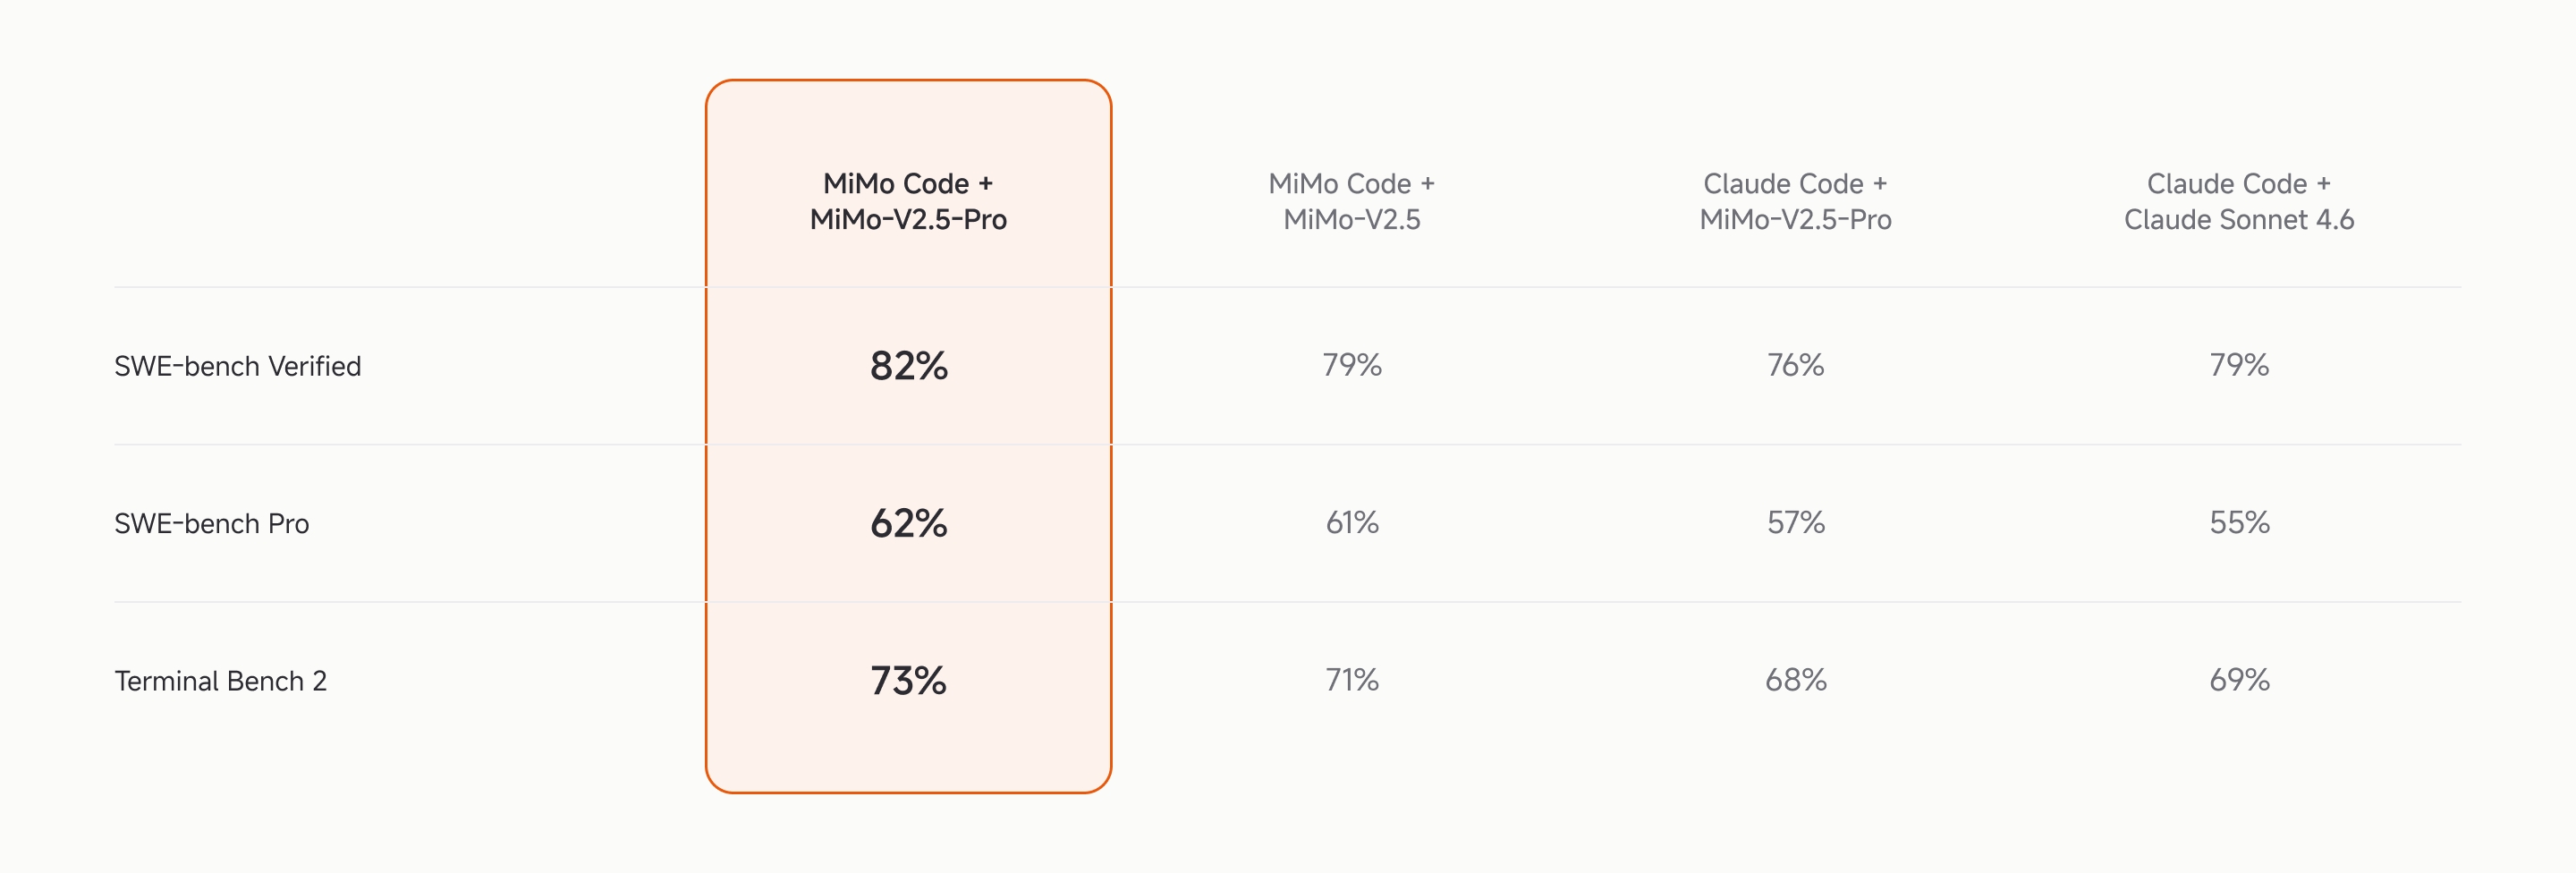
오프라인 벤치에서 MiMo Code + MiMo-V2.5-Pro 조합이 Claude Sonnet 4.6 + Claude Code를 세 가지 주요 벤치마크에서 앞섰습니다. 그런데 MiMo 팀 본인들이 솔직하게 말합니다. 그런 벤치는 단발성 문제 풀이라 MiMo Code가 진짜 노린 멀티턴·메모리·검증·진화의 강점을 다 못 보여준다고요.
그래서 사람이 직접 더블블라인드로 비교했습니다. 베타 기간에 개발자 576명, 실제 사설 저장소 474개에서 1,213쌍의 명확한 판정이 나왔습니다. 짧은 작업(200스텝 이하)에서는 승률이 거의 5대 5. 그런데 200스텝을 넘기는 순간 MiMo Code가 65% 이상으로 치고 올라갑니다. 길어질수록 격차가 벌어진다는 뜻입니다. 설계 의도가 실측으로 증명된 셈입니다.
실무자가 볼 핵심 포인트
- 모델만 키운다고 long-horizon이 풀리지 않습니다. 런타임이 메모리를 어떻게 분리·재주입하느냐가 더 결정적입니다.
- 메모리는 파일이어야 사람이 통제합니다. 벡터 임베딩보다 Markdown + 전체 텍스트 인덱스가 디버깅·수정에 압도적으로 유리하다는 판단입니다.
- 검증을 메인 에이전트와 분리하세요. 같은 모델이라도 따로 호출하면 ‘alignment bias’ 없이 종료 조건을 점검할 수 있습니다.
- 체크포인트는 일찍. 90%에서 압축하지 말고, 20%·45%·70%에서 점진적으로 적어두는 편이 추출 품질과 안정성 모두에 낫습니다.
- 벤치마크 점수와 실사용 만족도는 다른 축입니다. 짧은 태스크에서 박빙이라도, 긴 태스크에서 무너지지 않는 에이전트가 결국 개발자에게 선택됩니다.
- 설치는 한 줄 curl 또는 npm. 첫 실행 시 MiMo Auto(한시 무료, 100만 토큰 컨텍스트), 샤오미 MiMo 플랫폼 로그인, Claude Code 설정 가져오기, 커스텀 모델 중에서 고르게 됩니다.