개요
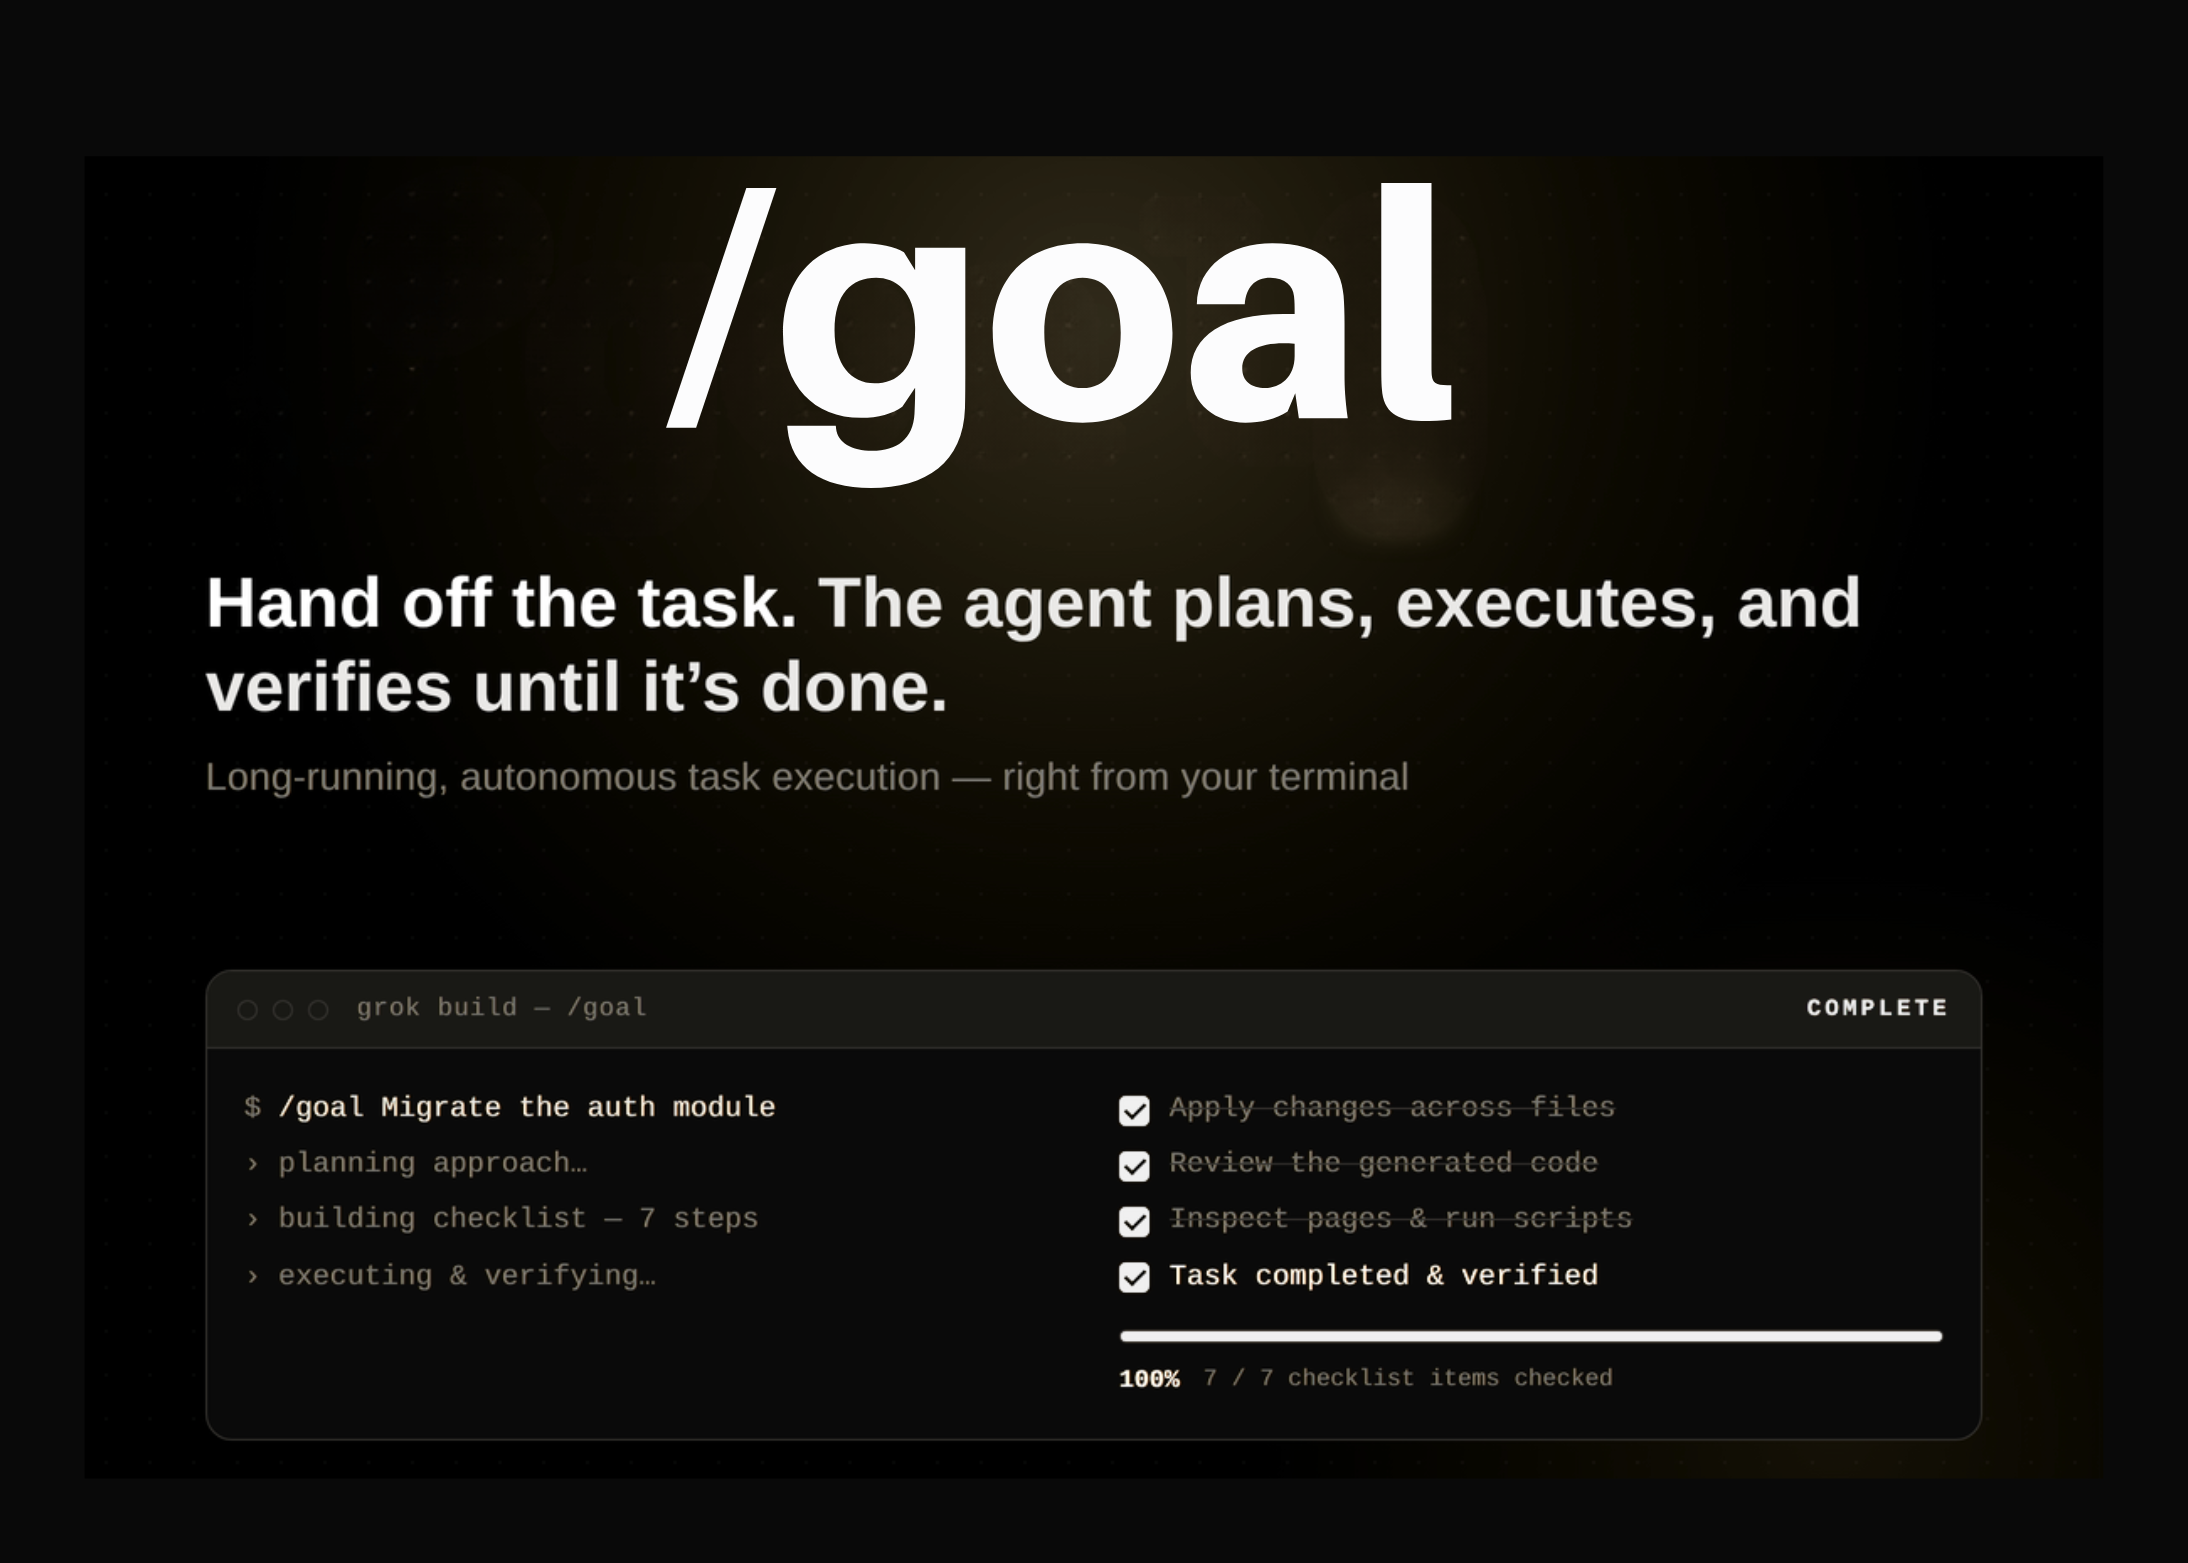
xAI가 자사 터미널 코딩 에이전트 Grok Build에 /goal 모드를 새로 넣었습니다. 사용자가 한 줄짜리 목표만 던지면 에이전트가 계획을 세우고, 체크리스트를 만들고, 각 단계를 실행한 뒤 결과까지 직접 검증합니다. 사람은 중간중간 들여다보면서 멈추거나 다시 굴리기만 하면 됩니다. 코드 작성에서 끝나지 않고 검증까지 한 호흡으로 끌고 가는 것이 이번 업데이트의 핵심입니다.
핵심 요약
/goal은 Grok Build 안에서 동작하는 새 모드로, 한 줄짜리 목표를 받아 계획·실행·검증까지 자율로 끝낸다.- 진행 상황은 라이브 체크리스트로 시각화되며,
/goal status,/goal pause,/goal resume,/goal clear로 흐름을 직접 제어할 수 있다. - 검증 방식은 세 가지로, 코드 리뷰 / 웹 페이지 점검 / 스크립트 실행을 통해 결과의 정확성을 스스로 확인한다.
- 적합한 작업은 인증 모듈 마이그레이션, 리팩터링과 테스트, 엔드포인트 추가, 의존성 업그레이드 등 길고 기계적이며 검증 가능한 일이다.
- 사용하려면 SuperGrok 또는 X Premium Plus 구독이 필요하고, 설치는
curl -fsSL https://x.ai/cli/install.sh | bash한 줄이다.
/goal이 바꾸는 것 — “프롬프트 핑퐁"의 종료
기존 코딩 에이전트의 흐름은 사실상 핑퐁이었습니다. 사용자가 프롬프트를 던지고, 에이전트가 무언가를 만들어내고, 사용자가 결과를 다시 확인해 주는 식이었죠. 작업이 길어질수록 이 왕복이 늘어나는데, 그중에서도 사람 손을 가장 오래 잡아두는 단계가 바로 ‘검증’이었습니다.
/goal은 이 사이클을 한 호흡으로 묶습니다. 사용자는 다음처럼 목표만 적어 넣습니다.
/goal Migrate the auth module to the new API
그러면 에이전트가 알아서 움직입니다.
- 목표를 분석하고 접근 방식을 계획한다.
- 작업을 체크리스트로 잘라낸다.
- 체크리스트 항목을 순서대로 처리한다.
- 마지막에 검증까지 마치고 멈춘다.
진행 화면에는 살아 움직이는 체크리스트가 떠 있어서, 어디까지 끝났고 무엇이 남았는지 한눈에 보입니다. 작업 중에 새로운 지시를 던지면 그것도 반영합니다.
검증 단계 — 코드 생성에서 끝나지 않는다
xAI가 강조하는 차별점은 검증입니다. /goal은 결과물을 만들고 손 떼는 것이 아니라, 자기 작업을 한 번 더 점검합니다. 검증은 보통 다음 세 가지 형태로 일어납니다.
- 코드 리뷰 — 에이전트가 생성한 코드를 다시 읽고 문제를 찾는다.
- 웹 페이지 점검 — UI나 동작 결과를 브라우저에서 확인한다.
- 스크립트 실행 — 직접 테스트를 돌려 출력이 기대치와 맞는지 본다.
이 단계가 들어가면서 “에이전트가 다 했다고 하는데 막상 안 돌아간다"는 흔한 함정이 줄어듭니다. 실제로 자율 에이전트의 신뢰도를 좌우하는 건 모델의 추론력보다 자기 결과를 검증할 수 있느냐입니다.
운전대를 쥐는 네 가지 명령
장시간 돌아가는 작업은 통제권이 없으면 불안합니다. /goal은 짧은 서브 커맨드 네 개로 흐름을 손에 잡히게 합니다.
/goal status     # 현재 진행 패널 보기
/goal pause      # 작업은 멈추고 목표는 유지
/goal resume     # 멈춘 지점부터 다시 시작
/goal clear      # 목표 자체를 비우기
테스트가 깨지거나 방향이 틀어졌다고 느끼면 일단 pause로 세워두고 살펴본 뒤, 정정된 지시와 함께 resume을 누르는 방식이 자연스럽습니다.
어떤 작업에 적합한가
xAI가 예로 드는 시나리오는 한결같이 길고, 기계적이며, 검증이 명확한 일들입니다.
- 모듈 마이그레이션: 인증 같은 도메인을 신 API로 옮기는 다수 파일 변경.
- 서비스 리팩터링: 구조를 손본 뒤 테스트 스위트로 회귀를 확인.
- 엔드포인트 추가: 새 API를 만들고 런타임에서 동작을 검증.
- 의존성 업그레이드: 패키지 버전을 올리고 깨진 부분을 메우기.
- 설정 이전: 파일 간 설정을 옮기고 검증 스크립트로 확인.
반대로 짧고 즉흥적인 한 줄짜리 수정이나, 사람이 매 단계 의사결정을 해야 하는 디자인 작업은 /goal보다 일반 모드가 어울립니다.
경쟁 도구와의 차이
이 분야는 이미 경쟁이 빡빡합니다. 단순 비교만 해도 핸들링 모델이 꽤 다릅니다.
| 항목 | Grok Build /goal | Claude Code | OpenAI Codex CLI | Cursor Agent |
|---|---|---|---|---|
| 작업 전달 방식 | 한 줄짜리 목표 객체 | 대화 + 작업 리스트 | 승인 모드 프롬프트 | IDE 안 채팅 |
| 진행 상황 | 자동 체크리스트 + 라이브 패널 | 내부 to-do 목록 | 단계별 로그 | 인라인 편집 스트림 |
| 제어 명령 | status / pause / resume / clear | 인터럽트 후 재지시 | 단계별 승인·거부 | 편집 수락·거부 |
| 검증 | 완료와 검증까지 자동 실행 | 지시할 때 테스트 실행 | 지시할 때 테스트 실행 | 지시할 때 테스트 실행 |
핵심 차이는 두 가지입니다. 한 줄 목표로 시작한다는 것, 그리고 “검증 후 종료"가 기본값이라는 점.
왜 장기 실행이 중요한가
자율 에이전트는 보통 관찰 → 계획 → 실행 → 다시 관찰의 루프를 돕니다. 한 사이클이 짧으면 사람이 따라가기 쉽지만, 다단계 작업으로 가면 관측성이 무너지기 시작합니다. 어디서 무엇을 하고 있는지 알 수 없으면 결국 다시 사람이 옆에 붙어야 합니다.
/goal이 깔아둔 체크리스트와 컨트롤 명령은 이 관측성 문제를 직접 겨냥합니다. 에이전트는 길게 굴러가도, 사람은 필요한 순간에만 개입할 수 있게 만든 셈입니다.
접근 조건과 설치
/goal을 쓰려면 SuperGrok이나 X Premium Plus 구독이 필요합니다. 설치는 짧습니다.
curl -fsSL https://x.ai/cli/install.sh | bash
CLI가 깔리면 grok build 세션 안에서 바로 /goal ...을 호출하면 됩니다.
실무자가 볼 핵심 포인트
- 반복적이고 검증 가능한 작업부터 맡겨보세요. 마이그레이션·리팩터링·의존성 업그레이드처럼 흐름이 정해진 일이 가장 좋습니다. 시작점에서 가장 큰 효용이 나옵니다.
- 검증 경로를 명확히 지정해 두세요. 어떤 테스트, 어떤 페이지, 어떤 스크립트로 결과를 확인할지 미리 정리하면 에이전트가 자체 검증을 더 정확하게 수행합니다.
pause를 적극 활용하세요. 장기 작업은 도중에 방향이 어긋날 수 있습니다. 의심스러우면 일단 멈추고 체크리스트만 봐도 큰 손실 없이 정정할 수 있습니다.- 민감한 작업에는 별도 환경을 쓰세요. 자율 실행은 편리하지만 파괴적입니다. 프로덕션과 격리된 브랜치·컨테이너에서 굴려야 안전 마진이 생깁니다.
- 다른 에이전트와 비교 운용하세요. Claude Code, Codex CLI, Cursor와 모두 강점이 다릅니다.
/goal은 “한 번에 던지고 검증까지 위임"하는 작업에 강하므로, 짧고 빠른 편집은 기존 도구와 병행하는 게 효율적입니다.