7가지 LLM 캐시 삭제 정책을 같은 조건에서 비교했더니 복잡한 기하학 기반 정책이 단순한 LFU보다 더 좋지 않았고, 매칭 임계값을 잘못 고르면 매치의 96%가 쓸모 없는 답변이라는 사실이 드러났다.
무엇이 문제였나 — LLM 답변 재사용 캐시에서 어떤 항목을 지울지(축출 정책)가 비용과 속도를 좌우하는데, 기존 연구들은 서로 다른 조건에서 비교해서 결론이 정반대였다. 어떻게 풀었나 — 동일한 프로토콜(CLEVER) 하에서 7개 정책을 3개 데이터셋, 3개 캐시 크기, 2개 임베딩 모델 총 18개 설정에서 비교하고, LLM 심사위원으로 실제 답변 대체 가능성도 함께 측정했다. 그래서 뭐가 좋아졌나 — 복잡한 정책들이 실제로는 단순한 LFU보다 낫지 않다는 사실과, 운영 시 임계값이 모델마다 재보정되어야 하며 매치의 실제 품질을 함께 측정해야 함을 보였다.
도서관 사서가 손님 질문과 비슷한 책을 추천할 때, 책상 위에는 이미 비슷한 책들이 빼곡히 들어차 있어도 사서가 그걸 모르고 매번 새 책을 추천해주는 것과 같다. 더 정교한 추천 알고리즘을 도입해도 책상 상태가 이미 그 신호를 삼켜버린 셈이다.
논문 정보
Yash Kulkarni, Shubham Harkare, Arvind Suresh Yogesh Babu · University of Michigan · CSE 584 Course Project, University of Michigan · 2025
왜 중요한가
LLM 서비스는 호출당 비용이 발생하므로 캐시 효율이 곧 비용이다. 매치의 96%가 실제 답변을 주지 못한다면 아무리 hit rate이 높아도 비용 절감은 기대보다 훨씬 작다. 또한 임베딩 모델을 바꿀 때마다 임계값을 재보정하지 않으면 hit rate이 100%로 보고되는 등 잘못된 운영 판단을 내릴 수 있다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| LFU 대비 최고 이득 | 0.041pp | GDSF on LMSYS 20% (MiniLM) - 18개 설정 중 가장 큰 이득 |
| FIFO 최대 손실 | 8.67pp | QQP 10% 캐시(MiniLM) - LFU 대비 적중률 손실 |
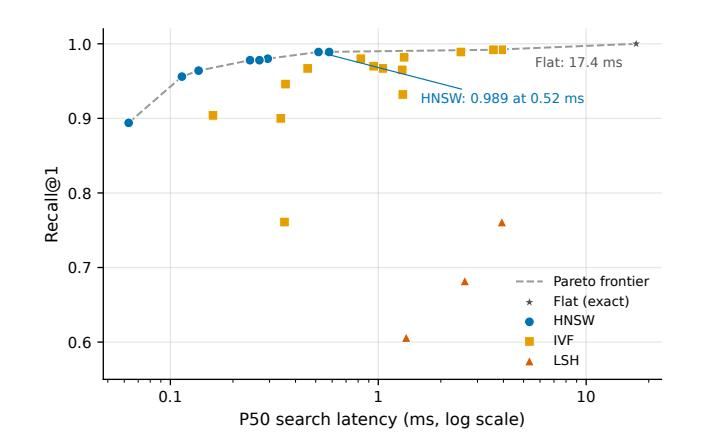
| HNSW 검색 속도 향상 | 34x | Flat(17.4ms) 대비 HNSW P50 0.52ms, 1.1pp recall 손실 |
| Adaptive router 지연 절감 | 60.33% | 5-seed 평균, θ=0.772±0.015, accepted-hit cosine 0.806, hit rate 60.43% |
어떻게 동작하나
본 논문은 CLEVER라는 통제된 비교 프레임워크를 만들어 동일 HNSW 인덱스, 동일 hit threshold, 동일 capacity-sized prefill, 동일 final-70% 측정 구간 하 7개 축출 정책(FIFO, LRU, LFU, ARC, GDSF, streaming SISO, semantic redundancy)을 실행한다. 세 개의 정렬·중복제거된 100K 쿼리 코퍼스(LMSYS-Chat-1M, QQP, MOSS), 세 캐시 크기(10/20/30%), 두 임베딩 모델(MiniLM 384-d, gte-base 768-d)로 18개 설정을 구성하고, Llama-3.1-8B-Instruct 심사위원으로 실제 답변 대체 가능성(answer substitutability)까지 측정해 raw hit rate과 quality-adjusted hit rate의 괴리를 정량화한다.
 499K 벡터에서 4개 FAISS 인덱스의 Recall@1 vs P50 지연시간(log scale) Pareto frontier.
HNSW가 Recall@1 0.989에서 0.52ms로 파레토 최적점을 점유, Flat 대비 34배 빠르다.
핵심 수식:
\text{score}(e) = \frac{r(e) + \mu}{\alpha \cdot \text{recency}(e) + \beta \cdot \text{frequency}(e) + \varepsilon} \quad (2)
r(e)는 캐시 내 반경 내 이웃 비율(redundancy), μ는 smoothing 상수(0.1), α=β=1.0은 recency·frequency 가중치, ε=1e-9는 분모 보호. r(e)가 μ(0.1)보다 훨씬 작아지면 score가 μ/utility로 축소되어 정책이 본질적으로 inverse-utility(LFU/LRU)로 떨어진다.
실험 결과
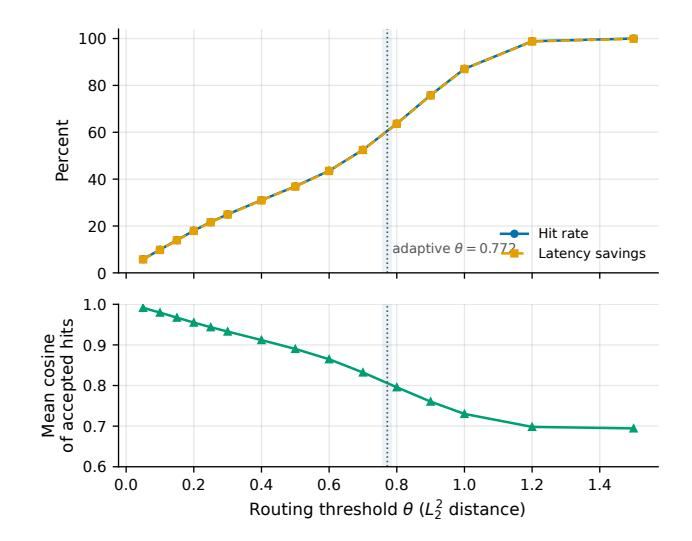 Five-seed 평균 threshold sweep. 임계값이 느슨해질수록 적중률과 지연 절감은 증가하나 accepted-hit cosine은 감소; 라우터는 θ=0.772±0.015에서 운영점을 선택.
비용 기반 라우터는 품질-지연 트레이드오프를 보여주며, 60.33%의 명목 지연 절감을 달성한다.
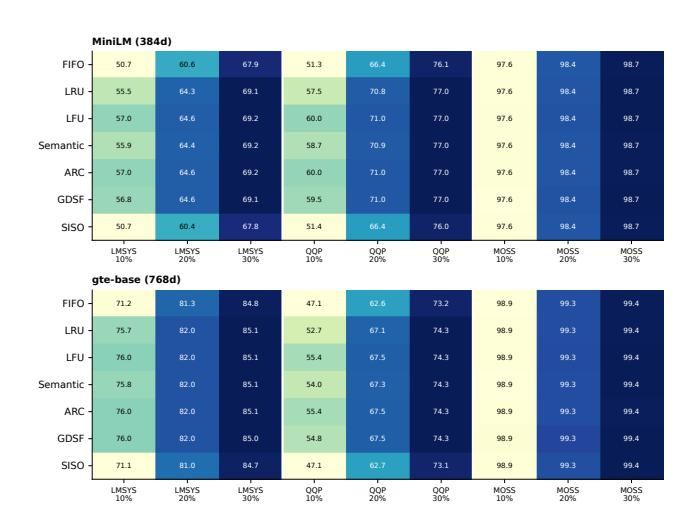 MiniLM(상)과 gte-base(하) 양쪽에서 7개 축출 정책 × 3개 데이터셋 × 3개 캐시 크기의 전체 매트릭스 히트맵. 정책 간 차이가 0.041pp 이내로 압축됨을 한눈에 보여준다.
어떤 복잡한 정책도 LFU를 0.041pp 이상 앞서지 못하며, 좁은 캐시에서 FIFO·스트리밍 SISO만 일관되게 손실이 발생한다.
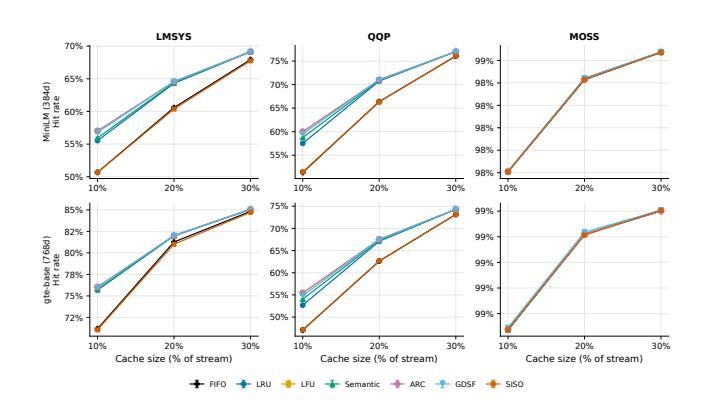 캐시 용량에 따른 ablation. 용량이 커질수록 선두 정책 간 격차가 줄어든다(MiniLM·gte-base 공통).
용량이 커질수록 LFU–LRU 등 상위 정책 간 차이가 거의 사라져, 정책 선택보다 용량 결정이 우선될 수 있음을 시사한다.
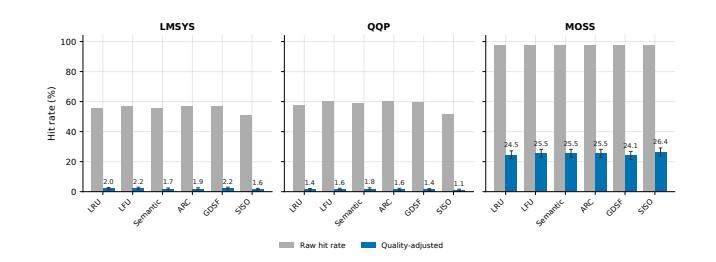 데이터셋·정책별 raw 적중률과 quality-adjusted 적중률을 나란히 비교한 막대 차트.
품질보정 시 LMSYS/QQP 적중률이 한 자릿수대로 떨어지며, 정책 간 순위가 사실상 사라진다.
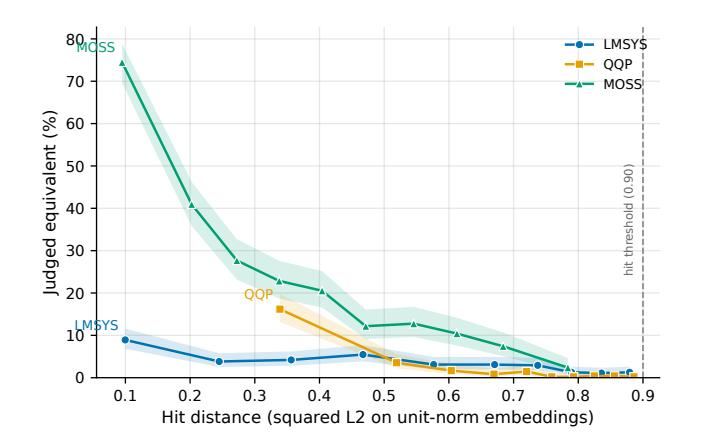 Answer-substitutability rate vs L2² hit distance(10분위 구간, Wilson 95% CI). MOSS는 가파르게 감소, QQP는 near-duplicate 영역이 없고, LMSYS는 템플릿 프롬프트 때문에 가까운 거리에서도 YES 비율이 낮다.
임베딩 거리가 가까워도 답변 대체 가능성이 낮을 수 있어, 거리 임계값만으로는 실제 답변 품질을 보장할 수 없다.
한계와 주의할 점
- 평가 입력이 정렬·중복제거된 코퍼스라 실제 운영 트레이스의 정확한 반복 패턴이 빠져 있어 적중률이 운영 환경의 하한만 본다.
- capacity-sized prefill + final-70% 측정 구간 설계는 online warmup이 아니어서, 실시간 누적 운영 시나리오와는 거리다.
- 세 개의 seed는 정책 내부 샘플링만 바꾸지 새로운 트레이스를 만들어내지 않으므로, 분산 추정이 trace 변동성이 아닌 측정 노이즈만 반영한다.
- 스트리밍 SISO는 원 논문의 오프라인 재클러스터링 구현이 아니라 본 논문의 온라인 single-pass 변형이므로, SISO 원본과 직접 비교되지 않았다.
- judge 감사는 단일 8B 모델 패밀리에 의존하며 사람 라벨 부재, 단방향(YES/NO) 판정으로 QQP/MOSS 품질은 검증되지 않았다. 또한 FIFO 실행 전에 샘플링되었으므로 6개 정책만 대상이다.
- 임베딩 모델 교체 시 임계값 미재보정: gte-base에 MiniLM용 0.90 l2² 임계값을 그대로 쓰면 모든 쌍이 hit으로 분류되어 eviction 0회·hit rate 100%의 퇴화 상태가 된다.
- 템플릿 프롬프트 위양성: 시스템 프롬프트·지시문 템플릿이 동일하고 payload만 다를 때 임베딩 거리가 0에 가까워도 judge가 답변 대체 불가로 거부한다(LMSYS nearest decile 8.9% YES).
- 시맨틱 정책의 graceful degradation: redundancy r(e)가 smoothing constant(0.1)보다 한참 작아져(평균 2.2×10⁻⁵~2.9×10⁻⁵) score가 μ/utility로 떨어지면서 복잡한 정책이 LFU로 수학적으로 환원된다.
- ANN false miss: eviction matrix HNSW(M=32, ef=128)의 정적 recall 손실 2.2pp가 정책 간 차이(≤0.041pp)를 능베해 차등 순위가 뒤바뀔 수 있다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
임베딩 모델 교체 시 quantile 매칭으로 hit threshold 자동 재보정
장기 기억 회수나 시맨틱 캐시의 벡터 검색 단계에서, 본 논문 Section 3.5/5.5의 per-encoder threshold calibration을 일반화한다. 임베딩 모델을 교체하거나 업그레이드할 때마다 100K calibration 쿼리셋에서 nearest-neighbor cosine 분포의 median을 측정하고, 그 분위에 해당하는 l2²로 hit threshold를 자동 갱신한다. 본 논문은 MiniLM용 0.90 l2²를 gte-base에 그대로 쓰면 100% hit rate·eviction 0회의 degenerate 상태가 되는 반면, quantile 재보정(0.30 l2²) 후에는 정상 비교가 복원됨을 보였다. 임계값 결정은 모델 변경 CI 게이트에 묶어 누락을 방지한다.
적용 지점 — 벡터 검색/매칭 단계의 hit threshold
기대 효과 — 모델 교체 시 발생하는 degenerate 100% hit rate 회피, gte-base 사례에서 정상 운영점 복원 확인
LLM judge로 측정한 quality-adjusted 적중률 지표 채택
RAG/시맨틱 캐시 회수 평가에서 raw hit rate만 보고하면 LMSYS/QQP 사례처럼 60%를 웃도는 적중률의 96~98%가 실제 답변을 주지 못하는 상황을 놓친다. 본 논문 Section 3.6·5.6에서 도입한 quality-adjusted hit rate(Raw × judge YES fraction)를 표준 평가 지표로 채택한다. 운영 시에도 8B 로컬 judge(Llama-3.1-8B 등)로 stratified sample(1,000/셀, distance quantile bin별)하여 answer substitutability를 주간 측정하고, raw·QA 두 지표를 모두 대시보드에 노출한다. cross-runtime Cohen’s κ=0.826 일치를 참고해 동일 모델 패밀리 내 judge 런타임 일관성을 확인한다.
적용 지점 — 캐시/RAG 회수 적중률 평가
기대 효과 — raw 60% → QA 1.6% 사례에서 보듯, 보고된 비용 절감을 실제 답변 대체 가능성 기준으로 1/30 이하로 정정
시맨틱 축출 도입 전 cache-content density probe 게이트
복잡한 기하학 기반 축출 정책(semantic redundancy, streaming SISO 등)을 도입하기 전, 본 논문 Section 6.3의 density probe를 게이트로 둔다. 운영 캐시의 LRU 스냅샷에서 적정 redundancy 반경(임계값과 동일하게 잡음) 내 이웃 비율의 평균을 측정하고, 그 값이 정책의 smoothing constant μ(0.1) 대비 충분히 큰지 확인한다. 본 논문은 모든 semantic run에서 redundancy가 2.2×10⁻⁵ ~ 2.9×10⁻⁵로 μ 대비 무시할 수준이었음을 보였고, 이 경우 score가 μ/utility로 수학적으로 축소되어 LFU와 동일해진다. density가 낮으면 복잡한 정책의 5~8배 컴퓨트 오버헤드를 들일 이유가 없으므로 LFU로 자동 폴백한다.
적용 지점 — 캐시 축출 정책 선택 단계
기대 효과 — 복잡한 정책의 5.83~8.24배 오버헤드를 사전에 회피, LFU의 단순함과 동등한 적중률 확보
템플릿 프롬프트 prefilter로 위양성 hit 차단
장기 기억/시맨틱 캐시에서 ‘You are the text completion model…’ 같은 시스템 프롬프트 템플릿이 동일하면 MiniLM이 거의 0 거리를 부여하지만, judge는 payload 차이로 답변 대체 불가 판정을 내린다(본 논문 Section 5.6: LMSYS nearest decile YES 8.9%). embedding 직전에 (1) 자주 등장하는 템플릿 prefix를 정규식으로 strip하거나, (2) 템플릿 fingerprint로 동일 템플릿·다른 payload 케이스를 별도 표시해 hit 후보에서 제외한다. gte-base의 anisotropic한 high random-pair similarity 문제(평균 cosine 0.69~0.76)도 보정 과정에서 함께 다뤄진다.
적용 지점 — 쿼리 임베딩 전처리 단계
기대 효과 — LMSYS nearest distance decile의 91% 위양성 hit을 사전에 차단, QA 비율 향상
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 (1~2개월) | 단순한 LFU 기본선 + 임베딩 모델별 임계값 보정 | 현재 사용 임베딩 모델의 100K calibration set에서 nearest-neighbor cosine median을 측정해 hit threshold를 quantile 매칭으로 결정. 모든 시맨틱 캐시 노드에서 LFU를 기본 축출 정책으로 강제, ARC/GDSF는 옵션. 임베딩 모델 변경 시 threshold 재보정 프로세스를 CI 게이트로 등록. | 교체 시 발생하는 degenerate 100% hit rate 회피, 동일 운영점 복원으로 비용 보고 신뢰성 확보. |
| Phase 2 (2~3개월) | 품질보정 적중률 지표와 템플릿 prefilter 도입 | Llama-3.1-8B 같은 로컬 judge로 운영 캐시 hit 샘플에 대해 answer-substitutable 비율을 주간 측정. raw 적중률과 함께 quality-adjusted 적중률을 대시보드에 노출. 시스템 프롬프트 템플릿이 많은 워크로드에는 template detector를 embedding 직전에 추가. QA 비율이 5% 미만인 워크로드는 캐시 효과 재검토. | 보고된 60% 적중률이 실제로는 2% 미만의 답변 대체 가능성이라는 괴리를 사전에 식별, 비용/품질 의사결정의 근거 마련. |
| Phase 3 (3~6개월) | 캐시 용량·정책 오버헤드 모니터링 + 정밀 임계값 운영 | Section 6.3의 cache-content density probe를 운영 메트릭으로 추가해, 적정 반경 이웃 밀도가 smoothing constant 대비 충분히 큰지 주기적 감사. density가 낮으면 자동으로 LFU로 폴백. HNSW efSearch 튜닝과 비용 기반 어댑티브 라우터(60.33% 지연 절감 사례)를 결합해 latency-budget 기반 운영. | 복잡한 정책의 5~8배 컴퓨트 오버헤드 없이 LFU의 단순함과 HNSW/HNSW+router의 Pareto 효율을 동시에 확보. |
원문 PDF: 2026-08-24-which-eviction-policy-should-an-llm-cache-use-a-systematic-study-across.pdf