AI가 모르는 이름을 봤을 때 엉뚱한 세부 정보를 꾸며내지 않고, 아는 범위 안에서 더 넓게 말할 수 있는지 확인한 논문
무엇이 문제였나 — AI는 낯선 사람·회사·제품 이름을 만나도 자신 있게 구체적인 답을 만들 때가 많다. 어떻게 풀었나 — 이 논문은 모델 내부에 ‘이 이름은 낯설다’는 신호와 ‘지금 구체적으로 답하려 한다’는 신호가 있는지 살펴봤다. 그래서 뭐가 좋아졌나 — 결과적으로 두 신호는 있었지만, 실제 답변을 만들 때는 그 신호를 잘 활용하지 못해 틀린 구체 답변을 계속 선호했다.
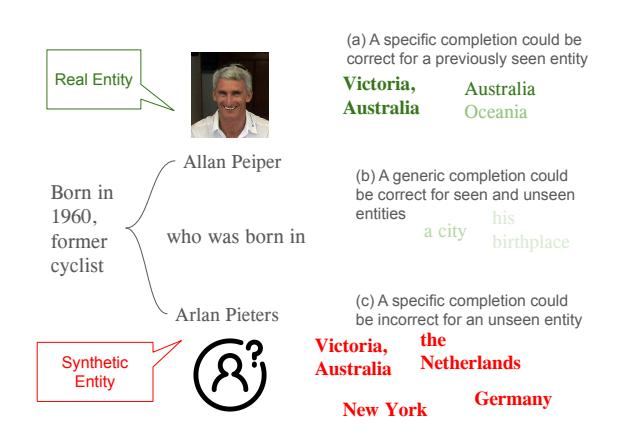
모르는 사람의 출생지를 묻는 질문을 받았을 때 아무 도시나 말하는 대신 ‘어느 지역 출신’ 또는 ‘어떤 나라의 인물’처럼 더 넓게 말하면 틀릴 위험이 줄어든다. 이 논문이 말하는 Gricean 후퇴는 바로 그런 식의 안전한 말하기다.
논문 정보
Dananjay Srinivas, Saksham Khatwani, Maria Pacheco · University of Colorado, Boulder · arXiv preprint · 2025
왜 중요한가
환각을 줄이는 한 방법은 답변을 만든 뒤 검사하는 것이 아니라, 답변을 만들기 전에 모델이 스스로 구체성을 낮추게 하는 것이다. 이 논문은 그런 조절에 필요한 내부 단서가 이미 모델 안에 있을 수 있음을 보여준다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| 지식 경계 탐지 AUROC | >90%% | 2B보다 큰 Pythia 모델에서 known/synthetic entity를 구분하는 probe가 90% 초과 AUROC를 달성했다고 보고됨 |
| LLM-judge × 사람 일치율 | 90.8%% | Deepseek-R1:32b judge가 사람 주석자와 entailment 94.1%, specificity 87.4%, overall 90.8% 일치 |
| 합성 개체 Pile 등장 중앙값 | 0–2회 | The Pile train split에서 real entity 중앙값은 관계별 112–1989회, synthetic entity 중앙값은 0–2회로 보고됨 |
| Specificity bias | 큰 모델에서 관찰 | Surprisal 분석에서 작은 모델은 generic completion을 선호하지만, 큰 모델은 real/synthetic 시나리오 모두에서 specific completion을 선호한다고 보고됨 |
어떻게 동작하나
저자들은 LAMA의 T-REx partition에서 46개 Wikidata 관계 중 many-to-one 성격의 8개 관계를 골라 4개 도메인(people, corporations, products, skills) 벤치마크를 만들었다. 각 fact는 subject, relation, object triplet으로 표현되며, minimal context, short context, long context 세 수준의 prompt를 만든다. Gemma 4 31B를 사용해 문맥 생성, 객체 직접 단서 제거, object의 10개 generic substitution, subject의 synthetic substitution을 생성한다. Synthetic entity가 Pythia의 학습 말뭉치인 The Pile에 거의 등장하지 않는지 infini-gram API로 표본 검증한다. 이후 Pythia 70M부터 12B까지의 모델에서 subject의 마지막 subword token activation과 completion 직전 token activation을 추출하고, 5-fold cross validation logistic regression probe로 AUROC를 측정한다. 마지막으로 Deepseek-R1:32b judge와 사람 검증을 통해 completion의 entailment와 specificity를 라벨링하고, argmax 및 multinomial decoding, 그리고 generic/specific candidate surprisal을 비교한다.
 Gricean Retreat 개념도. Known entity에는 specific completion이 맞을 가능성이 높지만, unknown entity에는 specific completion이 틀릴 수 있으므로 less informative but truthful completion으로 후퇴하는 설정을 보여준다.
논문의 핵심 문제는 답변 거부가 아니라, 정보량과 진실성 사이에서 적절히 덜 구체적인 답을 고르는 정책이다.
핵심 수식:
h_sub = hidden state at the last subword token of the subject
h_obj = hidden state immediately before the completion
p(boundary | h_sub) = sigmoid(w_b^T h_sub + b_b)
p(specific | h_obj) = sigmoid(w_s^T h_obj + b_s)
ΔS = surprisal(specific completion | x) - surprisal(generic completion | x)
Gricean retreat target for unknown x: ΔS > 0, meaning the generic completion is preferred
논문은 새로운 닫힌형 수식을 제안하기보다 logistic regression probe와 surprisal 비교로 현상을 측정한다. h_sub는 real/synthetic subject, 즉 지식 경계 상태를 예측하는 표현이고, h_obj는 다음 completion이 specific인지 generic인지 예측하는 표현이다. Surprisal은 낮을수록 모델이 더 선호하는 답변이므로 ΔS가 음수이면 specific completion 선호, 양수이면 generic completion 선호를 뜻한다.
실험 결과
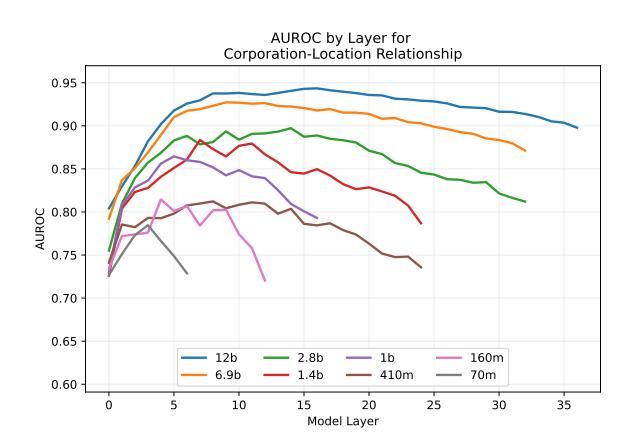 Corporation-Location 관계에서 모델 크기와 layer에 따라 knowledge boundary probe AUROC가 어떻게 변하는지 보여주는 appendix 그림이다.
본문 결과와 같이 중간 이전 layer 부근에서 entity가 학습 데이터 안에 있었는지를 구분하는 신호가 강하게 나타난다.
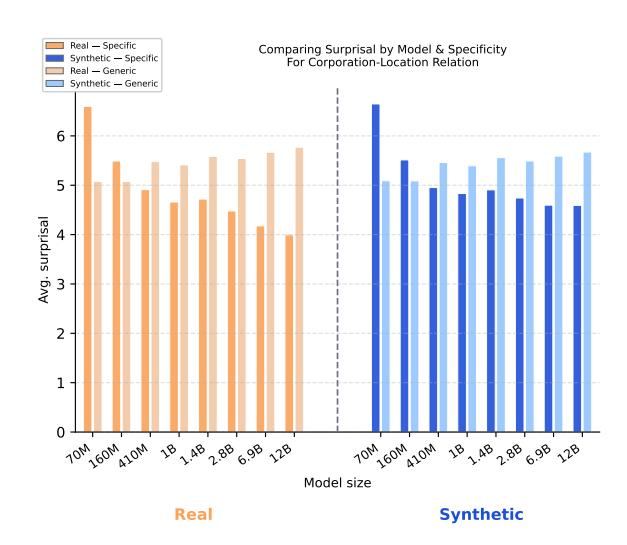 Corporation-Location 관계에서 모델 크기별 real/synthetic 및 generic/specific completion의 평균 surprisal을 비교한 그림이다.
모델이 correct generic option을 볼 수 있는 조건에서도 큰 모델은 specific completion을 더 낮은 surprisal로 선호하는 경향을 보인다.
한계와 주의할 점
- Synthetic entity가 The Pile에 거의 없는지는 표본 1,000개씩으로 검증했으며, 모든 생성 개체를 전수 검사하지는 못했다.
- 데이터 생성과 정제에 Gemma 4 31B를 사용했기 때문에 LLM 기반 생성의 품질 편향이나 오염 가능성이 남는다.
- 실험은 T-REx의 8개 관계와 Pythia 모델군에 한정되어 Llama, Mistral, Gemma 등 다른 모델 패밀리 일반화는 검증되지 않았다.
- LLM-as-a-judge 기반 completion 평가는 비용 문제로 Pythia-1.4B-deduped와 Pythia-12B-deduped 두 모델에 제한되었다.
- Surprisal 분석은 설계된 generic candidate 집합에 의존하므로 가능한 모든 안전한 일반 답변을 포괄하지 못한다.
- 모델은 synthetic unknown entity에서도 specific completion을 선호해 틀릴 가능성이 높은 답을 생성한다.
- 내부 activation에는 knowledge boundary와 specificity 신호가 모두 있지만, 실제 decoding policy는 두 신호를 결합하지 않는다.
- Context가 길어질수록 specificity bias가 커지는 경향이 보고되어, 더 많은 배경 정보가 오히려 과잉 확신처럼 작동할 수 있다.
- 작은 모델은 surprisal 실험에서 generic completion을 선호하는 반면 큰 모델은 specific completion을 선호해, scaling에 따라 생성 선호가 달라진다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
RAG 재순위에 지식 경계 probe 점수 결합
Subject representation에서 boundary score를 계산하고 retrieval score와 함께 사용한다. Boundary score가 낮으면 검색 문서 근거가 충분한지 더 엄격히 요구하고, 근거가 약하면 named entity 단정을 피한 generic answer로 유도한다. 논문 Section 4.1의 subject representation probe를 응용하는 방식이다.
적용 지점 — RAG 파이프라인의 재순위(reranking) 단계
기대 효과 — 논문에서 2B 초과 Pythia 모델의 boundary probe가 >90% AUROC를 보인 만큼, 잘 검증된 도메인에서는 unknown entity 감지 보조 신호로 활용할 수 있다.
Specificity-aware decoding guard
Object representation probe가 specific completion 가능성을 높게 예측하고 boundary probe가 unknown을 가리킬 때, generic candidate의 logit을 올리거나 specific named entity 후보를 낮추는 decoding guard를 둔다. 논문 Section 5.2의 surprisal 실험이 보여준 specific bias를 직접 겨냥한다.
적용 지점 — 생성 단계의 token selection 또는 reranking
기대 효과 — 틀릴 가능성이 높은 named completion 생성을 줄이고, 근거 없는 장황한 답변을 짧고 안전한 일반 답변으로 바꿀 가능성이 있다.
에이전트 자기검증 게이트에 boundary probe 삽입
Self-check 단계 전에 subject representation probe를 호출한다. Boundary score가 낮은 entity가 포함된 claim은 검색, 근거 요청, 또는 generic answer로 분기한다. 논문의 Section 4.1과 Section 5 결과를 결합한 적용이다.
적용 지점 — 에이전트 하네스의 self-check / verification 단계
기대 효과 — 모델이 이미 위험한 specific claim을 만들고 난 뒤 검증하는 비용을 일부 줄이고, unknown entity 관련 환각을 사전에 줄일 수 있다.
Gricean steering vector 실험
Object representation probe의 선형 방향을 steering candidate로 사용하고, boundary probe가 unknown을 가리킬 때만 residual stream에 작은 조정을 가한다. 논문은 이 조작을 직접 수행하지 않았지만, specificity signal이 activation에 존재한다는 Section 4.2 결과가 실험 근거가 된다.
적용 지점 — 생성 단계의 activation steering 또는 patching
기대 효과 — 재학습 없이도 unknown entity에서 generic completion 확률을 올릴 수 있는지 탐색할 수 있다.
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 지식 경계 probe 재현 | T-REx 또는 도메인별 triplet 데이터에서 real/synthetic subject를 구성하고, infini-gram 또는 사용 모델의 pretraining corpus 인덱스로 synthetic 노출을 표본 검증한다. Subject 마지막 subword activation에 logistic regression probe를 학습하고 AUROC를 측정한다. | 모델 내부 표현만으로 known/unknown entity를 어느 정도 구분할 수 있는지 확인한다. |
| Phase 2 | Specificity probe와 생성 정책 연결 | Completion 직전 activation으로 specific/generic completion을 예측하는 probe를 학습한다. Boundary score가 낮고 specificity score가 높을 때 generic candidate reranking, logit steering, decoding constraint 중 하나를 적용해 실제 Gricean retreat가 늘어나는지 평가한다. | 논문에서 발견한 내부 신호를 실제 생성 행동 변화로 연결한다. |
| Phase 3 | 도메인별 운영 평가 | QA, RAG, 요약 워크플로에서 probe 기반 분기를 A/B 테스트하고 hallucination rate, abstention/retreat rate, answer usefulness를 함께 측정한다. 모델 업데이트마다 probe 재학습과 drift 점검을 수행한다. | 사후 검증만이 아니라 생성 전 구체성 조절을 통해 위험한 단정 답변을 줄일 수 있는지 검증한다. |
원문 PDF: 2026-08-15-toward-a-gricean-retreat-probing-llms-for-knowledge-boundaries-and-refer.pdf