핵심 요약
- Thinking Machines가 TML-Interaction-Small을 research preview로 공개했다. “AI와의 상호작용” 자체를 모델이 네이티브로 처리하는 새 패러다임이다.
- 현재 frontier 모델은 사용자를 자율 워크플로 밖으로 밀어내며 협업 대역폭을 좁히는 흐름이었다 — 인터랙션 모델은 이 추세를 반대 방향으로 잡는다.
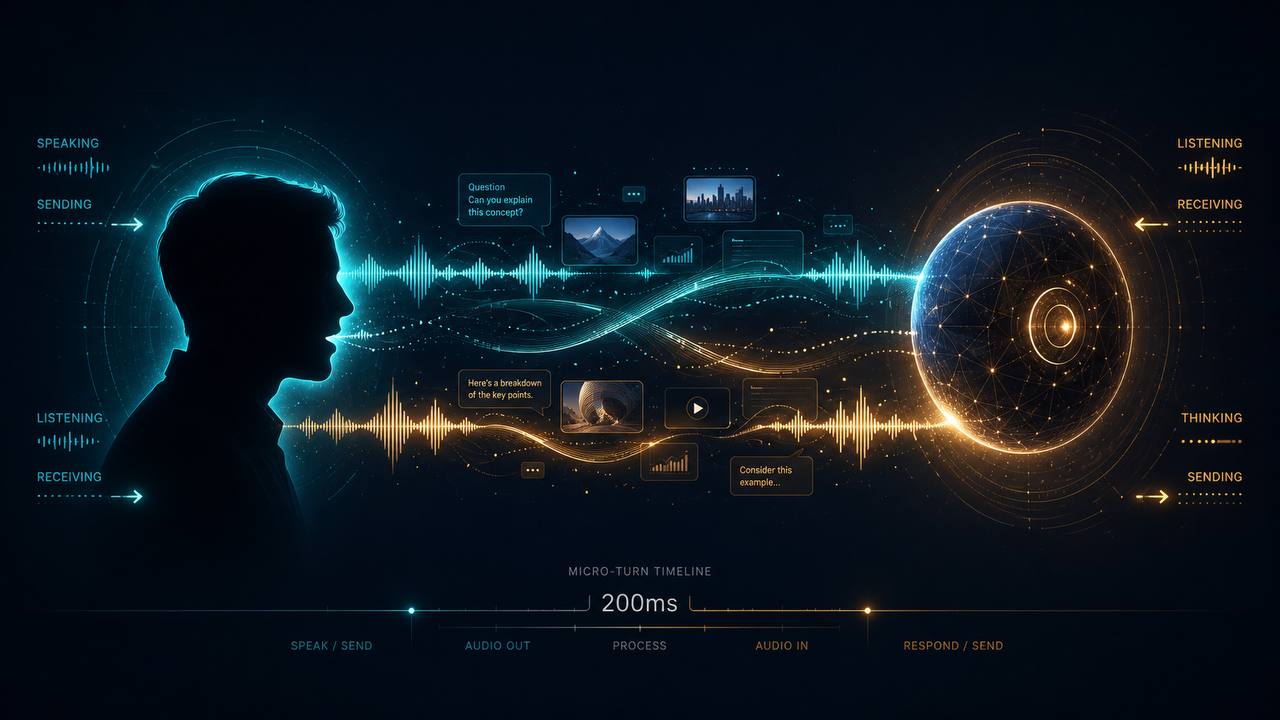
- 핵심 설계는 time-aligned micro-turn (200ms) — 입력과 출력을 200ms 단위로 인터리브해 audio·video·text가 동시 흐른다.
- 인터랙션 모델 + 백그라운드 모델 이원 구조 — 실시간 응답성과 reasoning 깊이를 동시에 확보.
- 벤치마크: 턴테이킹 지연 0.40초(GPT-realtime-2.0 minimal 1.18초의 1/3), FD-bench v1.5 평균 77.8 (다음 후보 54.3), Audio MultiChallenge 43.4%(instant 모델 중 1위).
협업 병목 — 자율성 경쟁이 가린 사용자
AI 연구의 주류 서사는 모델이 사람 없이 얼마나 멀리 갈 수 있는가에 맞춰져 왔다. METR의 “long-task” 측정처럼 자율 능력이 핵심 지표로 자리 잡으며, 인터페이스는 사람이 빠진 자율 실행을 전제로 진화했다. Anthropic이 자사 model card에서 직접 짚었듯, 일부 모델은 hands-on-keyboard 패턴에서 너무 느리게 느껴져 가치가 작아 보이고, 장시간 자율 agent harness가 더 잘 작동한다는 평가가 자리 잡고 있다.
문제는 현실의 일이다. 대부분의 작업에서 사용자는 모든 요구사항을 미리 명세하고 떠날 수 없다. 좋은 결과는 사람이 루프 안에 머물면서 조정하고 피드백을 주는 협업 과정에서 나온다. 그런데 현재 모델은 인터랙션을 단일 thread로 처리한다. 사용자가 입력을 마칠 때까지 모델은 사용자가 무엇을 하는지 보지 못하고, 모델이 응답을 마칠 때까지 사용자는 모델을 끊을 마땅한 통로가 없다.
Thinking Machines의 진단은 단순하다. 인터랙티비티가 지능과 함께 스케일하지 못하면, 사람의 지식·의도·판단이 모델에 도달할 통로가 좁아진다.
외부 하네스를 모델 안으로
대부분 실시간 AI 시스템은 하네스로 인터랙티비티를 봉합한다. 음성 활동 감지(VAD)로 turn boundary를 추정하고, 별도 모듈로 multimodality·동시성을 흉내 낸다. 하지만 Bitter Lesson 원칙에 따르면 손으로 만든 시스템은 결국 일반 능력의 발전 앞에 추월당한다. 인터랙티비티도 모델의 일부가 되어야 모델이 똑똑해질 때 협업도 함께 좋아진다.
Thinking Machines는 인터랙션 모델을 처음부터 새로 학습시켰다. 결과로 얻은 능력은 다음과 같다.
- 암묵적 대화 관리 — 화자가 생각 중인지, 양보 중인지, 자기 교정 중인지를 모델이 직접 판단. 별도 dialog 컴포넌트 없음.
- 언어·시각 끼어들기 — 사용자가 말을 끝낼 때만 응답하는 게 아니라, 맥락이 되면 능동적으로 끼어든다.
- 동시 발화 — 사용자와 모델이 같이 말하는 시나리오(예: 실시간 통역) 지원.
- 시간 인식 — 경과 시간을 모델이 직접 감지.
- 동시 도구 호출·생성형 UI — 말하면서 검색·웹 브라우징·UI 생성을 동시 수행, 결과는 자연스럽게 대화에 엮어 넣는다.
핵심 설계 — 200ms time-aligned micro-turn
가장 결정적인 기술 선택은 micro-turn이다. 인터랙션 모델은 200ms 단위로 입력을 받아들이고 동시에 200ms 단위로 출력을 생성한다. 입력 토큰과 출력 토큰이 모두 stream으로 처리되며 turn boundary라는 인공 경계가 없다. 이 설계가 동시 입출력과 다중 모달리티를 모델 안에서 자연스럽게 한다.
추가 기술 선택:
- Encoder-free early fusion — 오디오는 dMel + 경량 임베딩, 이미지는 40×40 패치 + hMLP. Whisper류 외부 인코더나 TTS 디코더 없이 트랜스포머와 함께 from-scratch 공동 학습.
- 추론 최적화 — 200ms chunk는 작은 prefill/decode가 빈번해 일반 LLM 추론 라이브러리에 부적합. Streaming sessions를 구현해 클라이언트가 chunk를 별도 요청으로 보내고 서버는 GPU 메모리의 persistent sequence에 append한다. SGLang에 upstream됐다.
- Trainer-sampler bitwise alignment — 학습과 추론 사이 bitwise 일치를 위한 batch-invariant kernel을 도입. e2e 오버헤드는 5% 미만.
인터랙션 + 백그라운드 모델 — 응답성과 reasoning을 분리
깊은 reasoning은 즉시 산출되기 어렵다. Thinking Machines는 시스템을 두 축으로 나눴다.
- 인터랙션 모델 — 사용자와 실시간 양방향 교환을 유지.
- 백그라운드 모델 — 비동기로 reasoning·tool use·장기 워크플로를 처리.
인터랙션 모델이 사용자와 대화를 이어가는 동안 백그라운드 모델이 결과를 stream으로 돌려주면, 인터랙션 모델이 그 결과를 사용자가 지금 무엇을 하고 있는지에 맞춰 자연스럽게 대화에 엮어 넣는다. 응답 지연은 non-thinking 모델 수준, 능력은 reasoning 모델 수준이라는 구조다.
벤치마크 — 인터랙티비티에서 압도, 인텔리전스에서도 instant 모델 1위
핵심 수치는 다음과 같다.
| 항목 | TML-Interaction-Small | GPT-realtime-2.0 (minimal) | Gemini-3.1-flash-live (minimal) |
|---|---|---|---|
| FD-bench v1 턴테이킹 지연 (초) | 0.40 | 1.18 | 0.57 |
| FD-bench v1.5 평균 | 77.8 | 46.8 | 54.3 |
| FD-bench v3 응답 품질 / Pass@1 | 82.8 / 68.0 (background 포함) | 80.0 / 52.0 | 68.5 / 48.0 |
| Audio MultiChallenge APR | 43.4 | 37.6 | 26.8 |
| IFEval (VoiceBench) | 82.1 | 81.7 | 67.6 |
특히 인터랙션 품질 지표(FD-bench v1.5)에서 다음 후보를 20점 이상 격차로 앞섰다. 동시에 인텔리전스 지표(Audio MultiChallenge)에서도 instant 모델 중 1위라, “빠르고 가벼운 모델은 멍청하다"는 가정을 정면으로 깬다.
실무자가 볼 핵심 포인트
| 구분 | 시사점 |
|---|---|
| 자율 vs 협업 균형 | 자율 agent 위주 설계 흐름에 “협업 대역폭"을 다시 경쟁선으로 되살리는 방향성 |
| 하네스 의존도 | VAD·turn detector·external encoder를 모델 안으로 흡수 — 시스템 복잡도와 latency 동시 감소 |
| 응답성 + reasoning | 인터랙션/백그라운드 이원 구조가 latency-quality trade-off를 분리하는 실용 패턴 |
| 추론 인프라 변화 | 200ms chunk streaming sessions가 일반 LLM 추론 라이브러리에 영향 — SGLang 업스트림 완료 |
| 벤치마크 재정의 | FD-bench v1.5의 1위(77.8)와 turn-taking 0.40초가 “실시간 협업” 평가축의 새 baseline |
| 로드맵 신호 | research preview 단계 — 후속으로 더 큰 모델·다국어·video understanding 확장 예상 |
자율성 라인이 모델 크기·context 길이·tool 호출 깊이로 경쟁해온 동안, 인터랙션 모델은 사람과 모델 사이의 대역폭 자체를 새 경쟁축으로 끌어냈다. AI 인터페이스가 사람을 자신에게 맞추라고 강요하는 대신, 사람이 일하는 방식에 모델이 맞추는 방향이다.
원문 출처
원문: Interaction Models: A Scalable Approach to Human-AI Collaboration — Thinking Machines, 2026.05.11