여러 AI가 팀으로 일할 때, 서로의 완성된 답을 너무 일찍 공유하면 오히려 다 같아져서 결과가 나빠진다는 것을 보여준 연구
무엇이 문제였나 — 여러 AI 모델이 팀으로 일하면 더 좋아진다는 보고와, 오히려 비용만 늘고 품질은 그대로라는 보고가 계속 충돌했다 어떻게 풀었나 — 이유는 ‘다 같은 팀이 아니다’였다. 서로 다른 성격의 AI들이 각자 다른 답을 만드는데, 서로의 완성된 답을 한 번만 봐도 모두 비슷한 답으로 수렴해버린다 그래서 뭐가 좋아졌나 — 답을 서로 보여주지 않고 각자 만든 다음 점수만 비교해 가장 좋은 답을 고르는 방식(MoA)만이 다양성을 지킨다는 것을 증명했다
한 요리 대회에서 요리사들이 서로의 완성된 요리를 먼저 맛보면 모두 비슷한 맛으로 바꿔버리는 것과 같다. 각자 다른 레시피로 요리한 뒤 점수만 공개하고 가장 높은 점수의 요리를 고르면, 처음부터 끝까지 서로 다른 결과가 나온다.
논문 정보
Summer Eunhyung Ann, Haokun Liu, Chenhao Tan · University of Chicago, Department of Computer Science · ICML (PMLR 306) · 2026
왜 중요한가
대부분의 다중 AI 시스템이 ‘서로 토론하면 더 똑똑해진다’는 가정 위에 만들어져 있다. 이 연구는 그 가정의 함정을 수치로 보여주며, 더 적은 비용으로 더 좋은 결과를 내는 설계로 바꿀 수 있는 근거를 제공한다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| 다양성 계수 (2×2 분산분석, N=120) | +0.188ΔQ | 서로 다른 모델 집단이 같은 모델 집단 대비 가져다주는 성능 차이 (95% CI [+0.073, +0.299], p<0.001) |
| Diverse Debate MIG | -0.078ΔQ | 서로 다른 모델 토론의 상호작용 이득 (같은 모델은 +0.012, P(same>div)=88%) |
| 다양한 MoA 솔루션 간 거리 | 0.315 → 0.229평균 쌍별 거리 | MoA(합성 없음) 0.315에서 MoA(다양한 모델 + 합성) 0.229로 수렴 (합성으로 인한 다양성 붕괴 직접 증거) |
| Knapsack-50 다양한 Debate 실행 가능률 | 10/10건 | 위반 규칙을 쉽게 찾을 수 있을 때 다양한 모델 + 토론이 같은 모델(2/10)을 압도 |
어떻게 동작하나
11개의 결정론적 검증기가 점수를 매기는 최적화 과제(Circle Packing, TSP, Erdős, MolQED, Knapsack 등)에 대해 Claude Sonnet 4, GPT-4o, Gemini 2.5 Flash 세 모델 패밀리로 10개 구성(Single-Shot, Best-of-N, Self-Refine, VGS, Homo-Chain, Cross-Chain, MAgICoRe, Debate, HPE, MoA)을 동일 예산(T=200K 토큰, W=600s, C=30s, K=25) 하에 비교한다. 핵심 측정값은 단일 에이전트 대비 개선도(MEG)와 독립 생성 대비 상호작용 개선도(MIG)이며, 2×2 분산분석으로 ‘모델 다양성’과 ‘합성 방식’의 효과를 분리해 다양성 계수 +0.188(95% CI [+0.073, +0.299], p<0.001)을 얻는다. 같은 모델 집단에서는 상호작용이 긍정적 MIG를 보이지만 다양한 모델 집단에서는 Chain -0.024, MAgICoRe -0.035, Debate -0.078로 반전하며, MoA만 +0.016을 유지한다. 다양성 붕괴는 풀-솔루션 교환 직후 1라운드 안에 발생하며, MoA 합성 시 평균 쌍별 거리가 0.315에서 0.229로 떨어지는 것으로 확인된다.
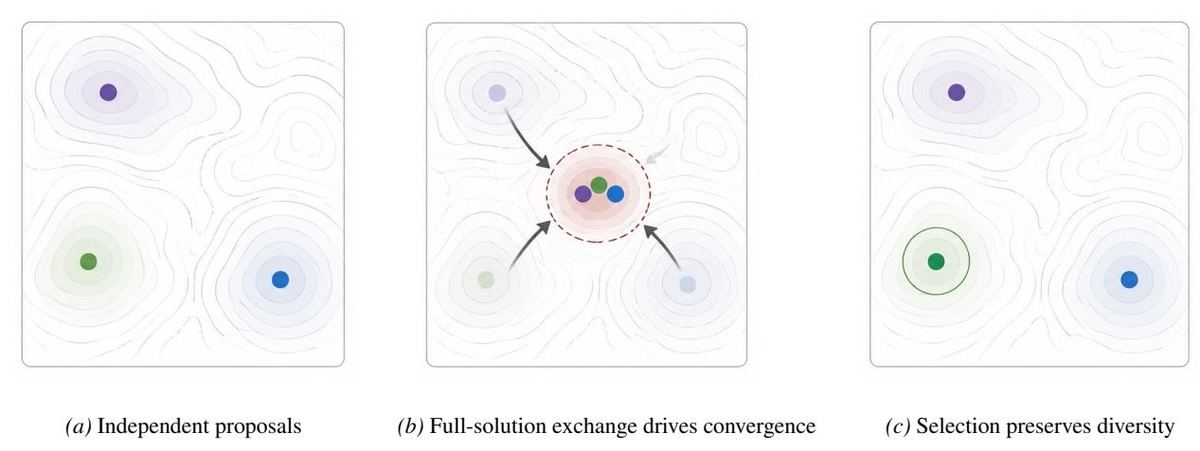
 상호작용 세금의 메커니즘: 서로 다른 모델 패밀리가 구조적으로 다른 해를 찾지만, 풀-솔루션 교환 후 한 라운드 만에 수렴해 다양성이 사라짐을 시각화
독립 생성 + 최고점 선택(우측)이 풀-솔루션 교환(좌측)보다 다양한 해를 보존한다
핵심 수식:
\text{MIG}(p, t) = Q_{\text{hidden}}(p, t) - Q_{\text{hidden}}(\text{parallel}(A), t)
Q_hidden은 숨은 평가자의 점수, p는 측정 대상 구성(예: Debate), parallel(A)는 같은 모델들을 서로 보지 않고 독립 실행한 결과. MEG(p,t)=Q_hidden(p,t)-max_{c∈C}Q_hidden(c,t)는 구성 p가 최고 단일 에이전트 기준선 C={Self-Refine,Best-of-N,VGS}보다 얼마나 나은지 측정한다. MIG가 양수면 상호작용이 독립 생성보다 좋다는 뜻.
한계와 주의할 점
- 다양성 우위 발견이 과제에 의존적임: Erdős를 제외하면 다양성 계수가 +0.188에서 +0.014로 떨어지며 신뢰구간이 0을 가로지름
- 메인 벤치마크는 조건당 시드 5개, 2×2 분산분석은 Erdős/DiffBases/MolQED 3개 과제만 사용
- 명시적 실행 가능성 분석은 Knapsack-50과 3AP-Free-100 두 과제에만 국한
- 모든 과제가 결정론적 검증기로 점수가 매겨지는 최적화 문제로, 개방형 글쓰기·계획·대화 환경에는 그대로 적용되지 않을 수 있음
- 논문은 풀-솔루션 교환이 약한 디폴트라고 말하지만, 어떤 낮은 대역폭(low-bandwidth) 정보 채널이 최적인지는 직접 검증하지 않음
- 풀-솔루션 교환 1라운드 만에 다양성 붕괴: MoA 합성에서 평균 쌍별 거리 0.315 → 0.229, MAgICoRe/Debate/Chain 모두 diverse MIG 음수
- 합성기가 5/7 과제에서 최고 제안안을 80% 이상 그대로 복사하여 재결합하지 않음 (Erdős·TSP-100·Flat Poly는 100% 복사)
- 최적화 과제에서 첫 라운드 비평이 17/30(57%)을 퇴화시킴 (MAgICoRe 첫 라운드 일반 지침은 구체적 수리안을 제공하지 못함)
- 한 백본이 고정 출력을 반복하면 다양성 기여가 0으로 줄어듦: GPT-4o는 Erdős 과제에서 trivial constant를 100% 시드에서 출력
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
에이전트 경계에서 풀-솔루션 교환을 기본값에서 제거
지금까지의 다중 LLM 파이프라인은 Chain, MAgICoRe, Debate가 모두 다음 라운드 에이전트 입력으로 직전 에이전트의 완전 출력을 넣는다. 본 논문은 이 패턴이 같은 모델에선 +0.044~+0.051의 MIG를 주지만 다양한 모델에선 −0.024~−0.078로 반전함을 보였다. 따라서 에이전트 계약(contract)에 ‘풀-솔루션 페이로드 금지’를 명시하고, 교환 채널을 검증기 점수·메서드 설명·실패 원인의 좁은 페이로드로 다운사이즈한다. 적용 지점은 모든 multi-agent 라우터의 후속 에이전트 입력 직전. 논문 메인 결론(Section 1, 4) 기반.
적용 지점 — 다중 에이전트 오케스트레이터의 에이전트 간 메시지 패스
기대 효과 — 다양성 계수 +0.188 (95% CI [+0.073, +0.299], p<0.001) 만큼 다양한 모델의 커버리지 이점을 보존. 같은 풀-솔루션 교환을 유지하면 Chain/MAgICoRe/Debate 모두 diverse MIG 음수.
MoA 패턴을 기본 다중 에이전트 오케스트레이션으로 채택
본 논문에서 MoA는 5개 다중 에이전트 구성 중 유일하게 diverse MIG +0.016을 유지했다(나머지 4개는 모두 음수). 핵심 차이는 제안자 3명이 서로의 출력을 한 번도 보지 않는다는 점이다. 일반화 가능한 다중 에이전트 파이프라인의 디폴트를 ‘독립 제안자 N명 + 점수 기반 선택·합성’으로 정하고, 풀-솔루션 기반 토론/체인/MAgICoRe는 검증기 점수가 단조로운 과제에서만 옵트인으로 두는 것이 안전하다. 본 논문의 유일한 양수 diverse MIG 사례(Section 4, Table 2) 기반.
적용 지점 — 다중 모델 앙상블의 오케스트레이션 토폴로지 선택
기대 효과 — 다양한 모델 집단의 MIG를 +0.016으로 유지(다른 구성은 −0.024~−0.145). 5/7 과제에서 검증기 점수가 단조로운 환경이라면 합성 단계 없이 ‘최고 점수 선택’만으로 충분(합성 계수 −0.010, 95% CI [−0.111, +0.094]).
비평 라운드를 위반 규칙 점검 가능성으로 게이팅
본 논문 표 3은 같은 메커니즘(비평-수정)이 과제 성격에 따라 정반대 결과를 낸다는 것을 보였다. Knapsack-50처럼 무게 초과가 산술 한 줄로 확인 가능한 과제에서는 다양한 모델 + Debate가 10/10 실행 가능률을 달성(같은 모델 2/10). 반면 3AP-Free-100처럼 산술 진행 3-항을 추론으로 찾아야 하는 과제에서는 같은 모델 6/10, 다양한 모델 0/10으로 정반대. 따라서 에이전트 하네스의 ‘비평 활성화’ 플래그를 ‘이 과제가 단순 결정론적 위반 점검을 제공하는가’로 게이팅한다. 적용 지점은 비평-수정 루프 진입 직전의 사전 조건 체크.
적용 지점 — 에이전트 self-critique / review-revise 루프의 트리거 조건
기대 효과 — Knapsack 류 과제에서 실행 가능률 013% → 4773%(Self-Refine 13%, VGS 27%, MAgICoRe 47% in 표 8). 3AP-Free 류 과제에서는 다양한 모델 + 비평의 0/10 실행 가능률을 회피.
장기 기억 회수 단계에서 ‘요약 점수’만 재순위에 사용
본 논문의 다양성 붕괴 메커니즘은 풀-솔루션 교환이 후보 간 거리(평균 0.315 → 0.229)를 1라운드 만에 무너뜨리는 것이다. 장기 기억을 쓰는 에이전트라면 후속 호출 에이전트에 ‘문서 본문’ 대신 ‘검색 점수 + 헤더/키워드 + 추출된 실패 원인’만 패스로 넘기면, 후속 에이전트가 이전 에이전트 답변을 흉내 내며 수렴하는 현상을 막을 수 있다. 본 논문 결론(Section 5)의 ’lower-bandwidth signals may preserve independent exploration while still supporting coordination’ 권고와 직접 매핑. 적용 지점은 RAG 파이프라인의 리랭커 출력 직후, 후속 생성 에이전트의 컨텍스트 주입 직전.
적용 지점 — 장기 기억 회수 / RAG 재순위 단계의 후속 에이전트 컨텍스트
기대 효과 — 풀-솔루션 전달 대비 다양성 거리 0.315를 보존(현재 0.229로 붕괴). 본문 전체 대신 점수·요약만 전달하면 토큰 비용도 추가 절감.
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 현재 다중 에이전트 파이프라인에서 풀-솔루션 교환 지점 진단 | 에이전트 간 컨텍스트 공유 로그를 스캔하여 ‘다른 에이전트의 완전 출력을 다음 라운드 입력으로 받는’ 위치를 식별. 11개 검증기 과제 중 1~2개로 인터랙션 단계의 평균 쌍별 거리(논문 표 12)를 측정해 다양성 붕괴 여부 확인. | 기존 시스템이 interaction tax에 노출되었는지 정량 진단. 노출 구간만 골라 MoA 패턴으로 교체 가능. |
| Phase 2 | 독립 제안자 + 점수 기반 합성(MoA) 패턴을 기본으로 채택 | 2~3개 서로 다른 모델 패밀리에서 동시에 독립 생성 → 검증기 점수로 랭킹 → 최고 점수 또는 명시적 합성 단계로 결합. 합성 단계는 5/7 과제에서 80%+ 복사만 하므로 ‘단순 최고 선택’이 합성과 비슷한 결과를 내는 점을 활용(논문 합성 계수 −0.010, 95% CI [−0.111, +0.094]). | 다양성 계수 +0.188 만큼의 커버리지 이점을 보존. 풀-솔루션 교환 대비 토큰 비용 대폭 절감. |
| Phase 3 | 제약 점검 가능성에 따라 비평 루프를 조건부로 활성화 + 낮은 대역폭 채널 실험 | Knapsack처럼 위반 규칙이 단순 산술 점검 가능한 과제에서만 비평-수정 라운드 실행(다양한 Debate가 10/10 실행 가능). 3AP-Free처럼 검증에 추론이 필요한 과제에서는 비평 비활성. 향후 점수·메서드 설명·실패 원인 등 낮은 대역폭 공유 채널 비교 실험으로 확장. | 비평이 도움이 되는 과제에서만 실행 가능률 0 |
원문 PDF: 2026-08-26-the-interaction-tax-when-communication-erases-diversity-in-multi-agent-t.pdf