벵골어는 세계적으로 많이 쓰이는 언어지만, 현재 AI 인프라는 벵골어 사용자에게 불리하게 만들어져 있다는 점을 보여주는 논문이다.
무엇이 문제였나 — 벵골어 사용자는 많지만 벵골어 웹 콘텐츠는 전 세계 웹의 0.5% 미만이고, AI 학습 데이터도 영어보다 훨씬 적다. 어떻게 풀었나 — 웹 콘텐츠, 학습 토큰, 글자 쪼개기 방식, 인터넷 접근성이라는 네 층위에서 불평등이 어떻게 누적되는지 정리했다. 그래서 뭐가 좋아졌나 — 그래서 왜 중요한가: AI 교육 도구가 클라우드와 영어를 기본값으로 삼으면, 농촌 벵골어 학습자는 설명을 이해하기도 어렵고 도구에 접속하기도 어렵다.
큰 도서관이 있는데 대부분의 책이 영어이고, 벵골어 책은 아주 조금뿐이며, 벵골어 책을 찾으려면 더 많은 절차를 거쳐야 하고, 시골 학생은 도서관 문 앞까지 가기도 어렵다고 생각하면 된다. 문제는 학생의 능력이 아니라 도서관의 구조다.
논문 정보
Avijit Roy, Proma Roy · John Jay College of Criminal Justice, CUNY / The City College of New York, CUNY · 69th Annual Conference of the International Linguistic Association (ILA) · 2026
왜 중요한가
AI가 교육 격차를 줄인다고 말하려면, 실제 학습자가 쓰는 언어와 인터넷 환경에서 작동해야 한다. 이 논문은 벵골어 사례를 통해 ‘AI가 누구에게는 처음부터 덜 쓸모 있게 설계되어 있는가’를 묻는다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| 벵골어 웹 콘텐츠 점유율 | <0.5% | 벵골어 사용자는 전 세계 인구의 거의 4%이지만, 벵골어는 전 세계 웹 콘텐츠의 0.5% 미만으로 제시된다. |
| 훈련 토큰 비율 (영어 : 벵골어) | 67 : 1 | Sangraha의 벵골어 약 30B 토큰과 Common Corpus의 영어 약 2T 토큰을 비교한 질서 규모의 격차다. |
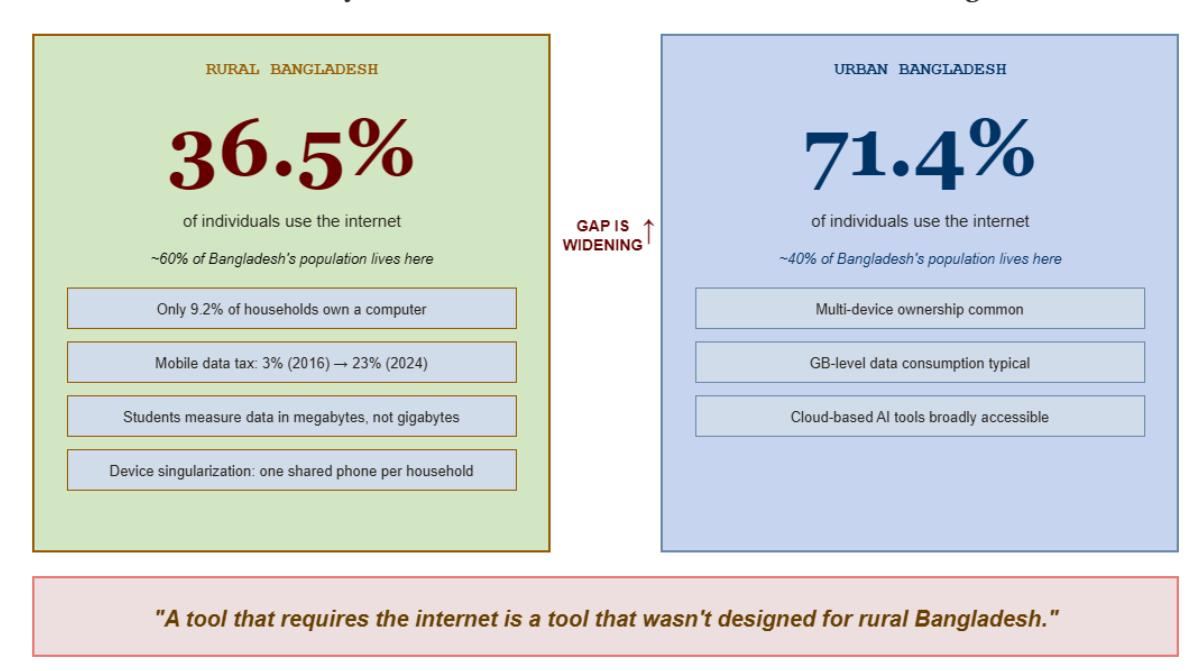
| 농촌 개인 인터넷 이용률 | 36.5% | 방글라데시 농촌 개인 인터넷 이용률은 도시 71.4%의 약 절반 수준이다. |
| 모바일 데이터 보조관세 | 23% | 방글라데시 모바일 데이터 supplementary duty는 FY2016 3%에서 2024년 23%로 상승했다고 인용된다. |
어떻게 동작하나
이 논문은 새로운 모델, 벤치마크, 사용자 실험을 제안하는 논문이 아니라 사례 연구와 분석적 종합이다. 저자들은 웹 콘텐츠 통계, 다국어 말뭉치 문헌, 벵골어 토크나이저 연구, 방글라데시 ICT 이용 조사, 인지 부하 이론 및 프로그래밍 교육 연구를 연결해 벵골어 AI 인프라의 네 가지 구조적 실패를 설명한다. 핵심 기여는 ‘구조적 침묵’이라는 개념을 통해 데이터 부족, 토큰화 불리함, 클라우드 의존 배포가 어떻게 서로를 강화하며 벵골어 학습자를 배제하는지 명확히 정리한 데 있다.
 방글라데시 농촌과 도시의 연결성 격차를 보여주는 그림
농촌 개인 인터넷 이용률 36.5%와 도시 71.4%의 차이는 클라우드 기반 AI 교육 도구가 농촌 학습자에게 실질적으로 접근 불가능할 수 있음을 보여준다.
핵심 수식:
원문은 핵심 수식을 제시하지 않는다.
초안의 P(L) ∝ Tokens(L) / Fertility(L) 수식은 원문에 없는 해석식이므로 제거했다. 원문은 벵골어 모델 성능이 학습 토큰 부족과 높은 토큰 출산율 때문에 불리해진다고 정성적으로 설명하지만, 모델 성능을 특정 수식으로 정의하거나 영어 1.0, 벵골어 2.6 같은 고정 fertility 값을 제시하지 않는다.
실험 결과
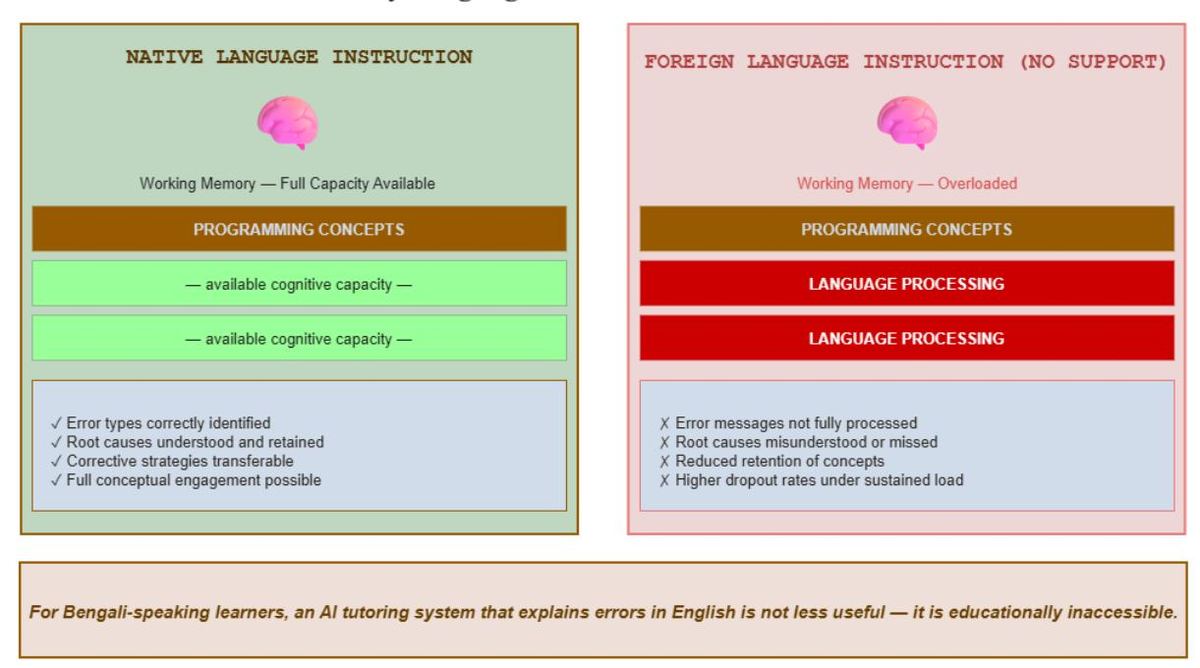 기술 내용을 외국어로 배울 때 생기는 이중 인지 부담을 설명하는 그림
프로그래밍 개념 이해와 영어 해석이 동시에 작업기억을 차지하면 학습자가 설명을 받아도 실제로 이해하기 어려워진다는 논지를 시각화한다.
한계와 주의할 점
- 새로운 벤치마크, 시스템 구현, 학습자 실험이 없어 제안된 방향의 효과를 직접 검증하지는 않는다.
- 67:1 토큰 비율은 Sangraha의 벵골어 토큰과 Common Corpus의 영어 토큰을 비교한 것으로, 동일 코퍼스 안의 엄밀한 통제 비교가 아니라 질서 규모의 예시다.
- 토큰화 페널티는 원문 Figure 3에서 ’list index out of range’ 예시로 5 대 13 토큰을 보여주지만, 정확한 fertility 비율은 토크나이저와 코퍼스에 따라 달라진다고 원문이 명시한다.
- 인터넷 접근성 논의는 개인 이용률, 가구 연결률, 컴퓨터 보유율을 함께 사용하므로 각 통계의 단위 차이를 분리해서 읽어야 한다.
- 벵골어는 사용자 수, 문학 전통, 공식 지위, 연구 커뮤니티가 있는 큰 언어이므로 더 작은 저자원 언어에는 문제가 더 심각할 수 있지만 같은 방식으로 단순 일반화하기는 어렵다
- 웹 콘텐츠가 적은 언어는 웹 크롤 기반 학습 데이터도 적어지고, 성능이 낮아지며, 다시 사용자와 연구 투자가 줄어드는 자기강화 사이클에 빠질 수 있다.
- 벵골어처럼 사용자 수가 많은 언어도 AI 인프라에서 밀려난다면, 사용자 수가 훨씬 적은 언어는 데이터·평가·배포 모든 층위에서 더 큰 배제를 겪을 수 있다.
- 양자화와 LoRA/QLoRA가 로컬 추론 가능성을 열었지만, 원문은 벵골어 로컬 튜터의 실제 품질이나 비용을 실험으로 검증하지 않았다.
- 오프라인 우선 설계가 단순한 저성능 대체재로 취급되면, 논문이 주장하는 교육 접근성 전략이라는 의미가 약화될 수 있다.
- 저자원 언어 데이터셋 구축이 계속 ‘모델 개발 전 준비 작업’으로만 취급되면, 인프라 연구에 대한 학술적 보상과 자금 지원이 부족한 상태가 반복된다
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
벵골어 문자 구조를 고려한 토크나이저 평가
원문 Figure 3은 영어 ’list index out of range’가 5개 토큰, 벵골어 대응 문장이 13개 토큰으로 쪼개지는 예시를 제시한다. 이를 단일 예시로 끝내지 않고, 프로그래밍 오류 메시지와 교육 설명 문장 전반에서 토큰 fragmentation을 측정하면 벵골어 AI 도구의 병목을 더 정확히 볼 수 있다.
적용 지점 — 토크나이저 평가·임베딩 전처리·RAG 청크 설계
기대 효과 — 정량 개선값은 원문에 없으므로 별도 실험이 필요하지만, 벵골어 문장 처리의 비효율을 체계적으로 드러낼 수 있다.
오프라인 우선 벵골어 튜터 실험
원문은 농촌 개인 인터넷 이용률 36.5%, 도시 71.4%, 모바일 데이터 보조관세 23%를 근거로 클라우드 의존 AI 도구의 한계를 지적한다. 양자화와 LoRA/QLoRA는 로컬 실행 가능성을 여는 배경 기술로 인용되지만, 실제 교육 효과는 별도 파일럿으로 측정해야 한다.
적용 지점 — 로컬 추론 하네스·교육용 AI 배포·저연결 환경 테스트
기대 효과 — 클라우드 연결을 전제하지 않는 접근 경로를 제공할 수 있으나, 품질과 비용 효과는 실험으로 확인해야 한다.
모델 카드의 언어 인프라 항목
원문은 단순히 ‘다국어 모델’이라고 표시하는 것만으로는 실제 언어별 성능과 접근성을 알 수 없다고 본다. 모델 카드에 벵골어 같은 언어의 데이터 규모와 토큰화 문제를 명시하면 구매자, 연구자, 교육기관이 모델의 한계를 더 빠르게 판단할 수 있다.
적용 지점 — 모델 평가·모델 카드·조달 기준·거버넌스 리포팅
기대 효과 — 67:1 같은 자원 격차와 토큰화 불리함을 숨기지 않고 의사결정 단계에서 드러낼 수 있다.
모국어 출력 우선 에이전트 정책
원문 Section 4는 외국어 설명이 기술 개념 이해와 언어 해석 부담을 동시에 만든다고 설명한다. Roussel et al.(2017)은 294명의 고등교육 학생을 대상으로 외국어 학술 콘텐츠가 학습 성과를 낮춘다는 결과를 제시했고, Soosai Raj et al.(2018)은 프로그래밍 교육에서 모국어 지원의 중요성을 보였다.
적용 지점 — 에이전트 출력 정책·언어 라우팅·교육용 챗봇
기대 효과 — 정확한 향상 수치는 원문에 없지만, 이중 인지 부하를 줄이는 설계 원칙으로 정당화된다.
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 근거 정리 — 벵골어 AI 인프라 현황 감사 | 벵골어 웹 콘텐츠 비중, Sangraha 등 말뭉치의 토큰 규모, 기존 벵골어 벤치마크, 토크나이저별 fragmentation 사례, 방글라데시 개인·가구·기기 접근성 통계를 같은 보고서 안에 분리해 정리한다. | 데이터 부족을 막연한 인상으로 말하지 않고, 원문이 제시한 네 층위의 구조적 실패를 검토 가능한 지표 묶음으로 만든다. |
| Phase 2 | 프로토타입 — 벵골어 교육 AI의 접근성 실증 | 벵골어 설명을 제공하는 프로그래밍 학습 도구를 만들고, 온라인 전용 방식과 오프라인 가능 방식을 비교한다. 응답 품질뿐 아니라 접속 가능성, 데이터 비용, 기기 접근성, 학습자의 이해 부담을 함께 측정한다. | 원문의 주장을 실제 교육 환경에서 검증할 수 있는 실험 설계로 전환한다. |
| Phase 3 | 제도화 — 인프라 연구를 학술 기여로 인정 | 벵골어 데이터셋, 평가 프로토콜, 토크나이저 분석, 오프라인 배포 기준을 독립 연구 산출물로 발표하고, 저자원 언어 인프라 구축을 모델 성능 개선의 부속 작업이 아니라 1차 기여로 다루는 트랙을 제안한다. | 논문이 말하는 구조적 침묵을 일회성 진단이 아니라 반복 가능한 연구·평가·지원 체계로 바꾼다. |
원문 PDF: 2026-08-14-structural-silence-when-ai-infrastructure-fails-speakers-of-underreprese.pdf