출처: Mem0
문서유형: 번역·해설
#Mem0 #AgentMemory #AIAgent #LLMOps #OpenMemory
핵심 요약
Mem0의 State of AI Agent Memory 2026은 한 가지를 분명히 말합니다. 에이전트 메모리는 더 이상 “대화 기록을 컨텍스트에 넣는 꼼수”가 아닙니다. 벤치마크, 전용 인프라, graph memory, MCP 기반 로컬 메모리까지 갖춘 독립 아키텍처가 됐습니다.

메모리는 컨텍스트 창이 아니다
초기 에이전트들은 지난 대화를 길게 붙여 넣는 방식으로 기억을 흉내 냈습니다. 하지만 이 방식은 비싸고 느립니다. LOCOMO 벤치마크 기준 full-context 방식은 정확도 72.9%로 가장 높지만, 중간 latency가 9.87초이고 대화당 약 26,000토큰을 씁니다. 실서비스에 그대로 넣기에는 무겁습니다.
Mem0는 선택적 메모리 파이프라인으로 정확도 66.9%를 내면서 latency를 0.71초, 토큰을 약 1,800개 수준으로 낮췄습니다. graph-enhanced 버전인 Mem0g는 68.4%까지 올라갑니다. 핵심은 “전부 기억하기”가 아니라, 지금 답변에 필요한 기억만 잘 꺼내는 것입니다.
벡터 메모리 다음은 그래프 메모리다
벡터 메모리는 비슷한 의미의 사실을 잘 찾습니다. 반면 graph memory는 관계를 봅니다. “사용자가 Python을 언급했다”가 아니라 “사용자는 Python으로 데이터 파이프라인을 만들고, pandas와 dbt를 쓰며, Spark에서 이전 중이다”처럼 연결된 맥락을 다룹니다.
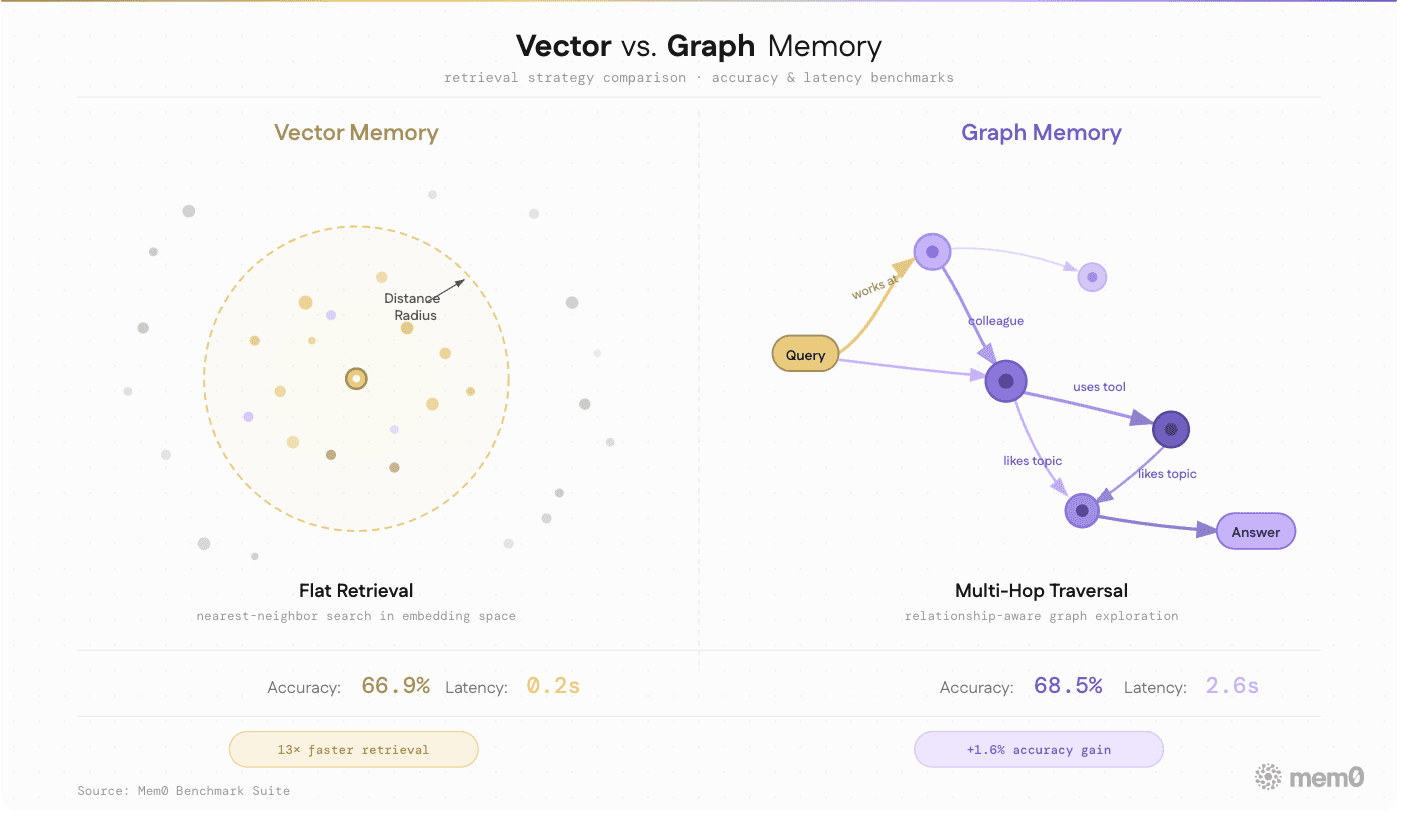
이 차이는 복잡한 질문에서 커집니다. 의료 기록, 기업 계정 구조, 기술 시스템 의존성처럼 관계가 중요한 도메인에서는 단순 유사도 검색만으로 부족합니다. 다만 graph memory는 더 느립니다. 그래서 모든 서비스에 기본값으로 켜기보다, 관계 추론이 중요한 경우에 선택하는 편이 맞습니다.
생태계는 이미 넓어졌다
Mem0 문서 기준 공식 통합은 21개입니다. LangChain, LangGraph, LlamaIndex, CrewAI, AutoGen, Google ADK, OpenAI Agents SDK, Mastra 같은 에이전트 프레임워크가 포함됩니다. ElevenLabs, LiveKit, Pipecat 같은 voice agent 통합도 눈에 띕니다.
특히 음성 에이전트에서 메모리는 더 중요합니다. 사용자는 이전 대화를 스크롤해 다시 보여줄 수 없습니다. 에이전트가 기억하지 못하면 대화가 바로 끊깁니다.
벡터 저장소도 19개까지 넓어졌습니다. Qdrant, Chroma, Weaviate, Milvus, PGVector, Redis, Elasticsearch, Pinecone, Azure AI Search, Neptune Analytics, MongoDB 등이 포함됩니다. 이건 시장이 하나의 벡터 DB로 수렴하지 않았다는 뜻이기도 합니다.
실무자가 볼 포인트
에이전트 메모리를 설계할 때 가장 먼저 정해야 할 것은 memory scope입니다. Mem0는 user_id, agent_id, session_id, app_id/org_id 같은 범위를 나눠 기억을 저장합니다. 개인 선호, 특정 에이전트의 작업 맥락, 한 번의 실행에서만 유효한 임시 정보, 조직 공통 지식이 뒤섞이면 나중에 디버깅하기 어렵습니다.
또 하나는 procedural memory입니다. “무엇을 안다”가 아니라 “어떻게 한다”를 저장하는 기억입니다. 예를 들어 팀의 PR 작성 방식, 테스트 순서, 배포 전 확인 절차는 단순 사실이 아니라 반복해야 할 작업 방식입니다. 이런 기억은 에이전트가 매번 같은 실수를 줄이고, 팀의 작업 방식을 더 일관되게 따르게 만드는 데 유용합니다.
정리
2026년의 에이전트 메모리는 RAG의 부가 기능이 아닙니다. 정확도, latency, 토큰 비용, privacy, scope, graph 관계까지 함께 설계해야 하는 독립 계층입니다. 좋은 에이전트는 똑똑한 모델만으로 만들어지지 않습니다. 무엇을 기억하고, 언제 잊고, 어떤 범위에서 꺼낼지 정하는 메모리 아키텍처가 필요합니다.