핵심 요약
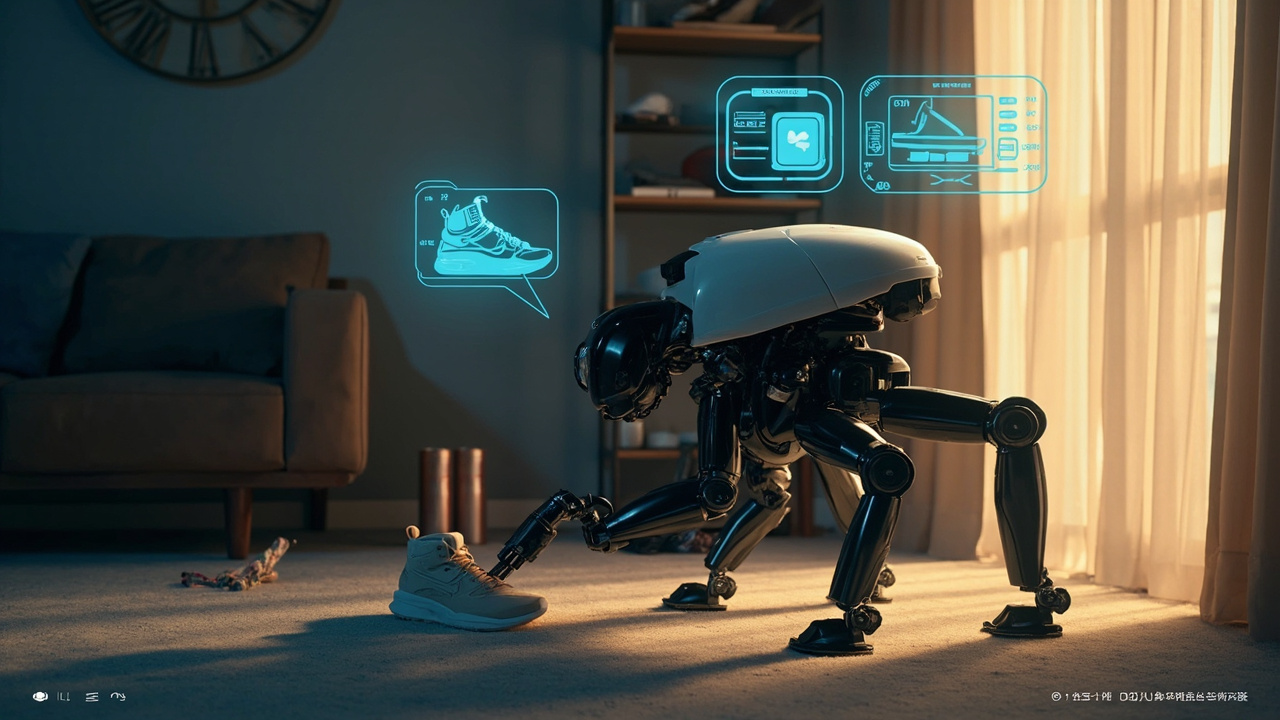
- Boston Dynamics가 산업용 4족 로봇 Spot을 거실에 풀어 신발과 음료 캔을 정리하는 데모를 공개했다. 구동 모델은 Google의 비전-언어 모델 Gemini Robotics-ER 1.5다.
- 핵심 아키텍처는 Spot SDK 위에 얇은 layer를 올리고, Gemini Robotics에는 한정된 Tool 집합(navigate, take picture, identify, grasp, place)만 노출한 구조. 자연어 한 줄로 Tool 시퀀스를 즉석 구성한다.
- 작성된 명령은 “Make sure all of the shoes at the front door are on the shoe rack.” 단 한 줄. Gemini가 카메라 이미지를 평가해 객체를 식별하고, Spot의 navigation·manipulation 시스템이 실제 동작을 처리한다.
- “Operator + Tablet 역할을 LLM이 대신” 한다는 비유가 정확하다. 사람은 to-do 리스트만 던지는 팀장 위치로 올라간다.
- Tool 응답(“I picked up the object”, “I can’t pick up something while my hand is full”)으로 Gemini가 즉시 적응. 하지만 “새 능력 발명 금지” 가드레일로 API 외 제어는 차단된다 — 예측 가능성 + 적응성의 균형.
- Boston Dynamics는 이미 AIVI-Learning을 Gemini Robotics ER 1.6로 업그레이드해 Spot/Orbit의 시각 검사 도구에 적용 중. 모델 개선이 같은 하드웨어에 자동으로 흘러 들어온다.
산업용 로봇이 거실에서 신발을 정리한다
Boston Dynamics의 Spot은 공장과 발전소의 거친 환경을 위해 설계된 산업용 로봇이다. 그런 로봇이 거실에서 신발과 음료 캔을 줍는 데모는 어떤 의미일까. 핵심은 로봇이 새 환경을 학습한 게 아니라, 자연어 인터페이스가 환경 적응을 풀어냈다는 점이다.
이 데모는 2025년 Boston Dynamics 사내 해커톤에서 시작됐다. 사전에 LLM으로 Spot이 채팅하는 프로젝트, Visual Foundation Model로 환경 컨텍스트를 이해하는 프로젝트가 있었고, 이번엔 한 발 더 나갔다. state machine으로 단계별 코드를 짜는 대신, Gemini Robotics와 자연어로 대화하고 Gemini가 Spot에 명령을 전달한다.
자연어와 Tool — Spot SDK 위에 올린 얇은 layer
엔지니어 팀이 Spot SDK 위에 추가한 것은 한 겹의 layer뿐이다. 이 layer가 Gemini Robotics와 Spot의 API를 잇는다. Gemini에게 노출된 능력은 다음과 같이 한정된 집합이다.
- 위치 간 이동 (navigate)
- 사진 촬영 (take picture)
- 객체 식별 (identify)
- 잡기 (grasp)
- 놓기 (place)
각 항목은 “Tool” — 가벼운 스크립트로 구현되어 있다. Tool은 Gemini의 입력을 받아 내부 로직을 거쳐 실제 API call로 변환한다. Spot SDK 자체가 워낙 잘 갖춰져 있어서 더 많은 능력을 추가하는 것도 최소 개발로 가능하다고 명시한다.
이 구조의 의미는 두 가지다. 첫째, Gemini는 Spot을 직접 다루지 않는다 — Tool을 호출할 뿐이다. 둘째, Tool 집합 자체가 사람이 정의한 안전 경계다. 새 능력은 Tool 추가로만 들어온다.
Tool 설계의 시행착오 — TakePicture 사례
엔지니어 팀이 가장 솔직하게 인정한 부분은 baseline prompt 작성의 학습 곡선이다. “객체를 내려놓아라”, “사진을 찍어라” 같은 단순 지시는 기대한 동작을 만들지 못했다. 컨텍스트를 추가하며 각 Tool의 설명을 다듬었다.
블로그 본문이 공개한 TakePicture Tool의 prompt 일부를 옮기면 다음과 같다.
이 명령은 로봇이 지정한 카메라로 사진을 촬영하게 한다. 카메라 선택에 미묘한 차이가 있다. GoTo로 위치에 도착하면 항상 gripper 카메라로 먼저 촬영해야 한다 — 가장 정보량이 많기 때문이다.
로봇이 위치에 도착했고 이미 객체를 들고 있다면, 다음 둘 중 하나를 한다.
- 즉시 PutDown을 호출한다.
- front 카메라로 영역을 검색한다. 단, front 카메라는 지면에 가까워서 높은 표면 위 객체를 촬영하기엔 부적절하다.
여기서 주목할 점은 로봇 섀시나 팔의 상세 사양을 Gemini에게 설명하지 않는다는 사실이다. 단지 “front 카메라가 너무 낮다"는 운영 제약만 자연어로 알려준다. 작은 wording 변경으로도 결과가 눈에 띄게 좋아졌고, 빠른 iteration이 가능했다고 한다.
이 패턴은 일반화된다. Tool 설명에 운영 제약과 사용 우선순위를 자연어로 박아두면, LLM이 그 안에서 자율적으로 시퀀스를 짠다. API 시그니처만으로는 부족하다.
Operator + Tablet 역할을 LLM이 대신한다
데모의 진행 방식은 단순하다. 사람이 화이트보드에 손글씨로 지시를 적는다. 예를 들어 “현관의 신발이 모두 신발장 위에 있게 만들어라(Make sure all of the shoes at the front door are on the shoe rack).” Gemini Robotics는 Spot의 카메라 이미지를 평가해 지시와 매칭되는 객체를 식별한다. 식별된 객체는 Spot의 navigation과 manipulation 시스템에 reference point가 된다.
본문이 든 비유가 정확하다.
많은 면에서 Gemini Robotics는 사람이 tablet으로 Spot을 직접 운전하는 것과 동일했다. 객체를 잡으려면, operator가 Spot을 객체 근처에 위치시키고 grasp wizard로 타깃을 식별한다. operator는 high-level 방향만 주고, Spot이 세부를 처리한다. 이번 데모에서 Gemini Robotics는 operator와 tablet 두 역할을 동시에 맡았다.
사람은 한 단계 위로 올라가 to-do 리스트를 던지는 팀장 위치가 된다. Spot의 기존 software stack(보행, 내비게이션, 매니퓰레이션)은 그대로 작동한다. AI는 그 위의 의사결정 layer를 자연어로 처리한다.
Call and Response — 흐르는 자연어 시퀀스
Tool이 Gemini의 호출을 받으면 결과와 컨텍스트를 함께 반환한다. “객체를 집었습니다”, “손이 비어있지 않아 다른 걸 집을 수 없습니다” 같은 응답이다. Gemini는 이 피드백으로 즉석 조정한다.
신발을 줍는 흐름은 이렇게 흘러간다.
- Gemini가 이미지를 요청한다.
- 이미지에서 신발을 식별한다.
- “pickup” 명령을 호출한다.
각 Tool이 의미적으로 자연스럽게 연결되도록 설계되었기에, Gemini는 거실 청소처럼 멀티 스텝 task의 시퀀스를 직접 관리한다. Spot의 기존 stack은 보행과 매니퓰레이션을 처리하는 하부 레이어로 남는다.
발명 금지 가드레일 — Strict Boundaries
블로그가 가장 분명히 못 박은 한 줄은 안전 가드레일이다.
Gemini Robotics는 이 시나리오에서 엄격한 경계 안에 있다. 새 능력을 발명할 수도, API에 노출되지 않은 방식으로 Spot을 제어할 수도 없다. 이렇게 Spot의 행동은 예측 가능하게 유지되면서도 Gemini Robotics가 다른 상황에 적응할 수 있다.
이 한 줄이 산업 현장에서 LLM 기반 로봇 통합의 가장 중요한 설계 원칙이다. Tool 화이트리스트로 능력 경계를 잠그고, 그 안에서 LLM의 적응력을 활용한다. 새 능력 도입은 사람의 Tool 추가 결정으로만 일어난다. 이 모델은 prompt injection이나 hallucinated capability call 같은 LLM 고유 위험을 구조적으로 차단한다.
Force Multiplier로서 AI — 기존 SDK 자산을 증폭한다
Boston Dynamics 입장에서 이 접근의 진짜 가치는 기존 Spot SDK 자산이 그대로 살아난다는 점이다. 검사·연구·산업 데이터 분석 등 Spot이 이미 쓰이는 응용에, 광범위한 task logic을 새로 작성하지 않고도 새 자연어 인터페이스를 얹을 수 있다.
본문 결론은 단순하다.
AI 모델은 기존 능력을 재발명하지 않고 새 환경과 응용으로 확장하는 새로운 방법을 제공한다.
LLM이 Spot의 ML 모델을 대체하는 게 아니라, 이미 검증된 보행·매니퓰레이션 위에 자연어 의사결정 layer를 추가하는 식이다. 이게 Force Multiplier의 의미다.
AIVI-Learning + 향후 방향 — 모델 업그레이드가 자동으로 흘러든다
블로그 끝에 깔린 두 가지 단서가 중요하다.
첫째, Boston Dynamics는 Google DeepMind와 공식 AI 파트너십을 맺었다. 이번 거실 청소 데모는 그 파트너십의 초기 결과다.
둘째, 이미 실전에 적용된 사례가 있다 — AIVI-Learning이 Google Gemini Robotics ER 1.6 기반으로 업그레이드됐다. Spot과 Orbit의 AI Visual Inspection 도구가 이 모델을 쓰고, 시각 지능과 컨텍스트 이해 깊이가 한 단계 올라갔다. 모델 개선은 사용자 작업 없이 자동으로 흘러 들어온다 — 같은 소프트웨어와 하드웨어에 능력만 추가된다.
미래 방향은 명확하다. 엔지니어의 역할은 목표와 목적 설정으로 전환되고, 멀티모달 로봇 foundation 모델이 지시를 해석해 복잡하고 적응적인 계획을 수립하면, Spot이 실행한다. 코드는 Tool 정의와 운영 제약 명세로 줄어든다.
실무자가 볼 핵심 포인트
- 자연어 인터페이스의 게이트키퍼는 SDK가 아니라 “Tool 집합"이다. 사내 로봇·자동화 시스템에 LLM을 얹을 때 가장 먼저 결정해야 할 건 어떤 능력을 Tool로 노출할지다. SDK 전체를 노출하면 통제 불가, 너무 좁히면 적응력 손상이라는 균형 문제다.
- Tool 설명에 “운영 제약 + 사용 우선순위"를 자연어로 박는다. API 시그니처만으로는 LLM이 좋은 시퀀스를 못 만든다. TakePicture가 “front 카메라는 너무 낮음"을 명시한 것처럼, 사람이 평소 알고 있는 비공식 운영 지식을 prompt로 변환해야 한다.
- “발명 금지” 가드레일은 prompt가 아니라 구조적 제약이어야 한다. Tool 화이트리스트, API 외 제어 차단이 prompt 없이도 작동하도록 layer 단에서 잠근다. 이게 prompt injection·hallucinated tool call의 구조적 방어다.
- Foundation 모델 업그레이드의 leverage가 크다. AIVI-Learning이 ER 1.5 → 1.6로 자동 업그레이드된 사례처럼, Tool 인터페이스가 안정되면 모델 교체가 코드 변경 없이 흘러 들어온다. 사내 시스템에서도 prompt + Tool 인터페이스의 안정성을 우선 설계해야 한다.
- 로봇·자동화 도입 시 “operator + tablet” 비유로 사람의 역할 재정의. UI/UX는 사람이 자연어 to-do를 던지는 인터페이스로 단순화되고, 운영 권한은 Tool 정의로 옮겨간다. 사내 도입 검토 시 누가 Tool을 정의·승인하는지가 거버넌스의 중심이 된다.
- 거실 청소는 비유다. 진짜 가치는 발전소·공장·창고에서 자연어 to-do 지시 하나로 검사·이송·정리 시퀀스를 즉석 구성하는 시나리오다. Spot이 이미 들어가 있는 산업 환경이 1차 적용지다.
원문 출처
원문: Tools for Your To Do List with Spot and Gemini Robotics — Issac Ross, Nikhil Devraj (Boston Dynamics Spot 팀), Boston Dynamics Blog. 관련 자료: Boston Dynamics × Google DeepMind 파트너십, AIVI-Learning Now Powered by Google Gemini Robotics.