개요
거대 언어모델이 AI의 가능성을 보여줬다면, **Small Language Model(SLM)**은 그 가능성을 실제 제품과 기기 안으로 가져오는 역할을 한다. 모든 작업에 수천억 파라미터 모델이 필요한 것은 아니기 때문이다.
원문 이미지: Hugging Face 커뮤니티 글
핵심 요약
- SLM은 보통 수백만~100억 파라미터 규모의 경량 언어모델을 뜻한다.
- 스마트폰, 노트북, 임베디드 기기처럼 자원이 제한된 환경에서도 실행 가능하다.
- 장점은 낮은 비용, 빠른 응답, 낮은 전력 사용, 오프라인 실행, 프라이버시 보호다.
- 단점은 범용 추론 능력과 복잡한 문맥 이해에서 대형 LLM보다 약할 수 있다는 점이다.
- 앞으로는 “무조건 큰 모델”보다 “업무에 맞는 작은 모델”을 고르는 능력이 더 중요해진다.
SLM은 LLM의 축소판이 아니라 다른 전략이다
SLM은 단순히 LLM을 작게 만든 버전으로만 보면 안 된다. 핵심은 필요한 작업에 맞게 모델 크기와 실행 환경을 최적화하는 것이다.
예를 들어 이메일 초안 작성, 간단한 요약, 번역, 고객 응대, 기기 내부 명령 처리 같은 작업은 매번 거대한 클라우드 모델을 호출하지 않아도 된다. 1B~4B급 모델만으로도 충분한 경우가 많다. 원문은 Llama 3.2 1B, Qwen2.5 1.5B, SmolLM2 1.7B, Phi-3.5 Mini, Gemma 3 4B 같은 사례를 소개한다.
이 모델들은 “작아서 약하다”기보다, 범위를 좁혀서 실용성을 높인 모델에 가깝다. 거대한 모델 하나가 모든 질문을 처리하는 방식은 연구 데모나 범용 챗봇에는 좋지만, 실제 서비스에서는 과한 선택일 때가 많다. 사용자가 원하는 기능이 일정하고 입력 패턴이 반복된다면, 작은 모델을 잘 튜닝하는 편이 비용과 품질의 균형을 더 잘 맞춘다. 한마디로 SLM은 AI를 더 작게 만드는 기술이 아니라, AI를 더 가까운 곳에서 쓰게 만드는 기술이다.
작게 만드는 방식도 다양하다. 큰 모델의 지식을 작은 모델로 옮기는 지식 증류, 불필요한 파라미터를 제거하는 프루닝, 계산 정밀도를 낮춰 가볍게 만드는 양자화가 대표적이다.
왜 지금 SLM이 다시 중요해졌나
첫 번째 이유는 비용이다. AI 기능을 제품에 붙일 때 가장 큰 부담은 추론 비용이다. 사용자가 많아질수록 API 비용과 서버 비용이 누적된다. SLM은 같은 기능을 훨씬 저렴하게 제공할 수 있다. 특히 스타트업이나 내부 자동화 팀처럼 예산이 제한된 조직에서는 이 차이가 제품 지속 가능성을 좌우한다.
두 번째는 속도다. 작은 모델은 응답 지연이 짧다. 실시간 번역, 모바일 챗봇, 코드 자동완성처럼 즉각적인 반응이 중요한 기능에서는 이 차이가 크게 느껴진다. 사용자는 모델 크기를 보지 않는다. 버튼을 눌렀을 때 바로 답이 나오는지, 앱이 끊기지 않는지를 본다.
세 번째는 프라이버시다. 온디바이스에서 모델이 실행되면 사용자의 데이터가 외부 서버로 나가지 않는다. 의료, 법률, 사내 문서, 개인 메모처럼 민감한 데이터를 다루는 환경에서는 이것이 강력한 장점이 된다. 기업 입장에서도 데이터 반출 리스크를 줄이면서 AI 기능을 제공할 수 있다.
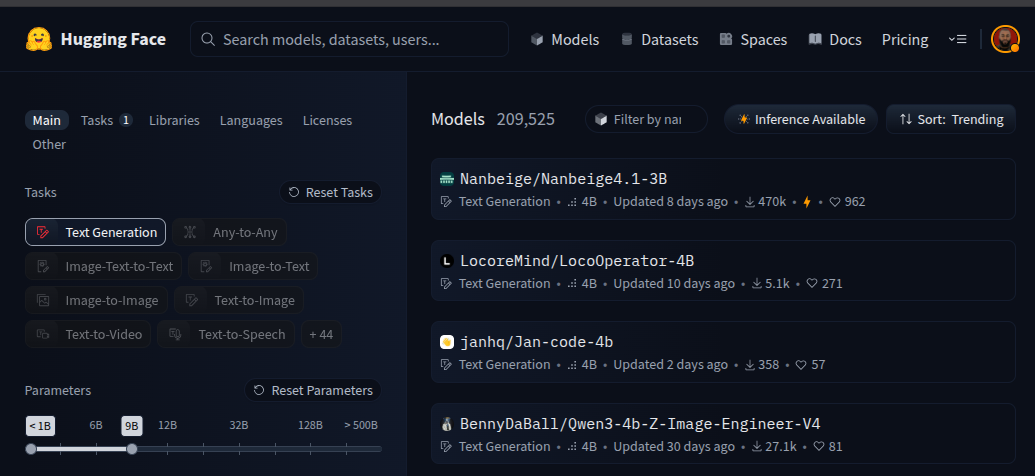
원문 이미지: 모바일 기기에서 SLM을 실행하는 예시
한계도 분명하다
SLM은 만능이 아니다. 학습 범위를 벗어난 주제에서는 답변 품질이 급격히 떨어질 수 있고, 복잡한 추론이나 긴 문맥 처리에서는 대형 모델보다 불리하다. 작은 데이터셋으로 학습한 경우 편향이 더 강하게 드러날 수도 있다.
그래서 SLM의 핵심은 “대형 모델을 대체한다”가 아니라 역할 분담이다. 민감하고 반복적인 작업은 로컬 SLM이 처리하고, 고난도 분석이나 장문 추론은 클라우드 LLM이 맡는 하이브리드 구조가 현실적이다.
실무자가 볼 핵심 포인트
제품을 만드는 입장에서는 SLM을 먼저 검토할 만하다. 특히 오프라인 동작, 빠른 응답, 낮은 비용, 개인정보 보호가 중요한 기능이라면 대형 모델보다 SLM이 더 좋은 선택일 수 있다.
개발자는 Ollama 같은 도구로 로컬 PC에서 SLM을 쉽게 테스트할 수 있다. 모바일에서는 PocketPal 같은 앱을 통해 Phi, Gemma, Qwen 계열 모델을 직접 실행해볼 수 있다. 특정 도메인에 맞추려면 LoRA 같은 경량 파인튜닝 방식도 현실적인 선택지다.
실무적으로는 세 가지 질문을 먼저 던지면 된다. 첫째, 이 기능이 꼭 범용 지식을 많이 필요로 하는가? 둘째, 사용자의 데이터가 외부로 나가도 괜찮은가? 셋째, 응답 속도와 운영 비용이 중요한가? 이 질문에 “아니다, 민감하다, 중요하다”가 많이 나온다면 SLM을 검토할 가치가 크다.
결국 앞으로의 AI 경쟁력은 “가장 큰 모델을 쓰는가”가 아니라 업무에 맞는 크기의 모델을 정확히 고르는가에서 갈릴 가능성이 크다. SLM은 그 전환을 보여주는 가장 실용적인 흐름이다.