개요
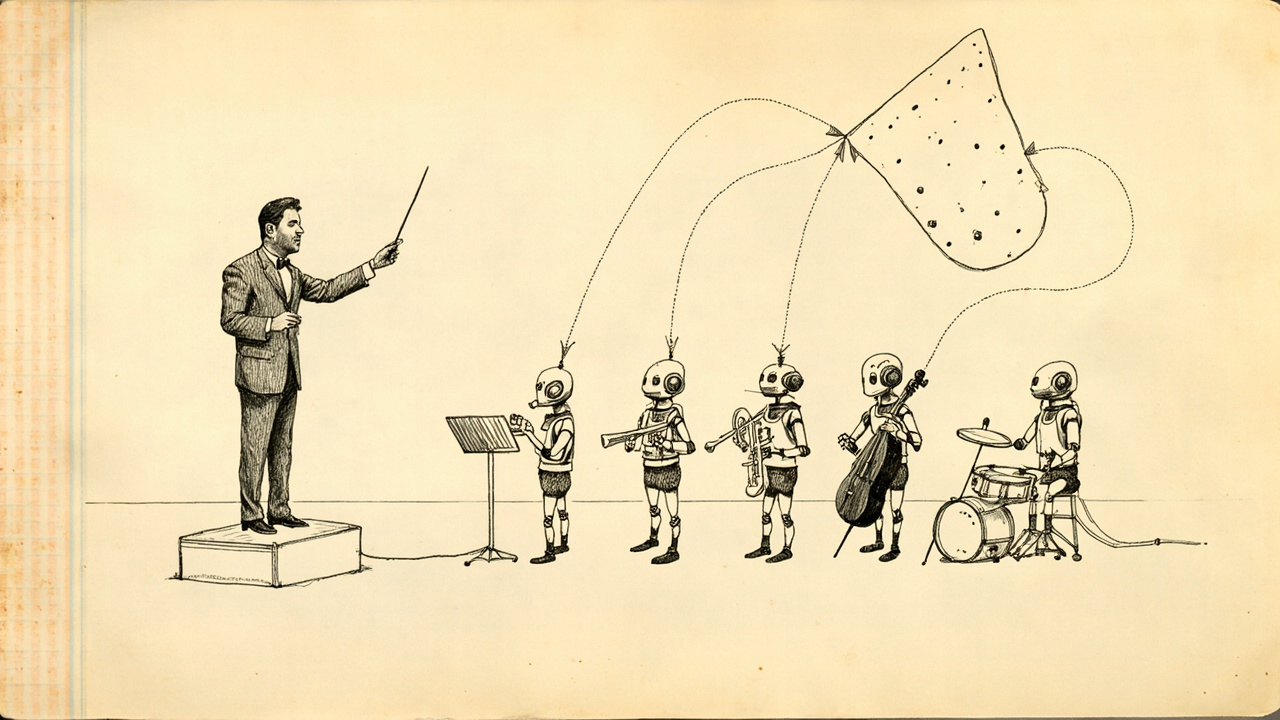
Sakana AI가 6월 22일 Sakana Fugu라는 새 모델을 공개했습니다. 부르는 이름은 “모델"이지만 내부는 멀티 에이전트 시스템입니다. 사용자가 요청 하나를 던지면 Fugu가 알아서 판단해, 쉬운 일은 혼자 풀고 어려운 일은 다른 프런티어 LLM들을 불러 팀을 짜서 처리합니다. 외부에서 보면 그냥 단일 모델 API 하나일 뿐이라, 클라이언트 코드는 멀티 에이전트라는 사실조차 알 필요가 없습니다.
핵심 요약
- Fugu는 다른 LLM들을 도구로 호출하도록 학습된 언어 모델입니다. 자기 자신을 재귀적으로 부르는 것도 가능합니다.
- 모델 선택, 위임, 검증, 답안 합성을 미리 짠 워크플로 없이 학습된 정책으로 결정합니다.
- 변형은 두 가지입니다. 빠르고 저렴한 Fugu, 그리고 어려운 다단계 문제에 더 깊은 에이전트 풀을 쓰는 Fugu Ultra(
fugu-ultra-20260615). - ICLR 2026 논문 두 편 — Trinity(가벼운 코디네이터 + Thinker/Worker/Verifier 역할 분담)와 Conductor(자연어 협업 전략을 RL로 학습) — 가 기반입니다.
- 11개 벤치마크 중 10개에서 1등을 차지했고, SWE Bench Pro 73.7, TerminalBench 2.1 82.1, LiveCodeBench 93.2 같은 수치를 공개했습니다.
- API는 OpenAI 호환이라 SDK 교체 없이 엔드포인트만 바꾸면 됩니다.
“단일 벤더 종속"에서 빠져나오기 위한 설계
Sakana가 출시 발표에서 가장 먼저 꺼낸 메시지는 단순합니다. 한 회사의 모델에 발이 묶이면 위험하다는 것입니다. 발표문은 최근 Anthropic의 Fable과 Mythos 모델에 걸린 수출 통제를 직접 사례로 들면서, 어느 한 공급자가 막혀도 Fugu가 풀에 남은 다른 모델로 우회해 작업을 이어간다고 설명합니다. 새로운 프런티어 모델이 나오면 에이전트 풀에 추가하기만 하면 됩니다.
기존 멀티 에이전트 프레임워크와 다른 점은 워크플로를 사람이 짜지 않는다는 부분입니다. Fugu는 “이 문제는 코딩이니까 A 모델, 검증은 B 모델” 같은 규칙을 손으로 적어 두지 않습니다. 어떤 모델을 부를지, 그 모델에게 어떤 자연어 지시를 줄지, 답을 어떻게 합칠지를 학습된 정책으로 결정합니다.
여기서 흥미로운 부분이 하나 더 있습니다. Fugu는 자기 자신을 풀 안의 도구로 재귀적으로 호출할 수 있습니다. 어려운 하위 문제를 만나면 또 다른 Fugu 인스턴스에 통째로 넘겨, 그쪽이 다시 모델 풀을 조립해 처리하도록 시킵니다. 외부에서는 여전히 단일 API 호출로 보입니다.
Fugu와 Fugu Ultra — 두 가지 변형
Fugu는 강한 성능과 짧은 응답 시간의 균형을 노립니다. 코딩, 코드 리뷰, 챗봇처럼 빠른 반복이 중요한 워크로드를 겨냥하고, 데이터·프라이버시·컴플라이언스 요구에 맞게 특정 에이전트를 풀에서 빼는 opt-out이 가능합니다. 예를 들어 사내 정책상 외부 미국 모델을 못 쓰는 팀이라면 그 모델만 쏙 빼고 운용할 수 있습니다.
Fugu Ultra는 정반대 방향입니다. 길고 까다로운 멀티 스텝 문제에 더 큰 에이전트 풀을 동원해 답의 품질을 끝까지 끌어올립니다. 대신 풀을 직접 조정하는 opt-out 옵션은 제공하지 않습니다. 모델 ID는 fugu-ultra-20260615로 공개돼 있습니다.
기반 연구 — Trinity와 Conductor
Fugu의 기술 베이스는 ICLR 2026에서 발표된 두 편의 논문입니다.
- Trinity는 가벼운 진화 기반 코디네이터를 여러 턴 동안 돌리면서, 매 턴마다 Thinker / Worker / Verifier 역할을 동적으로 분배합니다. 누가 생각을 정리하고, 누가 실제로 풀고, 누가 결과를 검증할지를 상황에 맞게 바꾸는 구조입니다.
- Conductor는 강화학습으로 자연어 협업 전략 자체를 학습합니다. 다양한 LLM 풀을 두고, 어떤 어조와 형식의 지시가 가장 좋은 답을 끌어내는지 모델이 직접 찾아냅니다.
이 두 가닥을 합친 결과가 “에이전트 구성과 라우팅을 사람 손이 아니라 학습으로 끝낸다"는 Fugu의 그림입니다.
벤치마크와 베타 시연
성능 표는 공격적입니다. Fugu Ultra가 4개 코딩 벤치마크, CharXiv Reasoning, Humanity’s Last Exam에서 선두였고, 기본 Fugu는 SciCode, τ³ Banking, Long Context Reasoning에서 1등을 차지했습니다. 굳이 자랑할 만한 숫자만 추리면 다음과 같습니다.
| 벤치마크 | Fugu Ultra | 가장 가까운 경쟁 모델 |
|---|---|---|
| SWE Bench Pro | 73.7 | Opus 4.8 — 69.2 |
| TerminalBench 2.1 | 82.1 | GPT 5.5 — 78.2 |
| LiveCodeBench | 93.2 | Gemini 3.1 Pro — 88.5 |
단일 모델 한 곳에서 이 정도 수치가 동시에 나오는 사례는 흔치 않습니다. 베타에는 약 500명이 참여했고, Sakana는 단발성 점수보다 장기 작업 사례를 강조했습니다.
- AutoResearch: 작은 GPT의 학습 레시피를 14시간 동안 H100 한 장으로 123회 실험해 평균 검증 BPB 0.9774까지 끌어내림.
- 루빅스 큐브: 테스트 큐브 300개를 전부 풀고 평균 19.72수.
- 고전 일본어 가나 판독: 1,610자 입력에서 정규화 편집 거리 0.80, 차순위 베이스라인은 0.24.
- 블라인드 체스: 프런티어 모델 3종과 Elo 2100짜리 Stockfish를 모두 꺾음.
- 온라인 트레이딩 50주 시뮬레이션: 5회 평균 +19.43%(다른 프런티어 모델은 +15% 미만). 과거 성과는 미래 수익을 보장하지 않습니다.
커뮤니티 반응 — “결국 라우터 아니냐”
출시 당일 공개 게시물 12건을 살펴보면 분위기가 마냥 우호적이지는 않습니다. 지지 3, 회의 6, 비판 3으로 회의 쪽이 절반이었습니다. 핵심 질문은 거의 하나로 모입니다. “내부적으로 다른 모델을 부르는 거라면, 이건 모델이라기보다 라우터 혹은 래퍼 아닌가?” 지지하는 글의 상당수가 Sakana 관계자나 그 주변 인물이라는 점도 회의론을 키웠습니다.
결국 Trinity·Conductor 논문이 “라우팅 정책 자체를 학습한다"는 주장을 어디까지 실증하느냐에 평가가 달려 있습니다. 라우팅이라도 “잘 학습된 라우팅"이라면 그 자체로 가치가 있다는 시각과, 결국 다른 회사 모델 위에 얹은 추가 레이어라는 시각이 맞붙어 있습니다.
실무자가 볼 핵심 포인트
- 도입 비용은 낮습니다. OpenAI 호환 API라 클라이언트 코드 변경 없이 엔드포인트만 교체해 보고 비교할 수 있습니다.
- opt-out이 필요한 환경은 반드시 일반 Fugu로 시작하세요. Ultra는 모델 풀 구성을 사용자에게 노출하지 않아, 데이터·국가별 규제가 엄격한 팀에는 부적합할 수 있습니다.
- 비용 가시성을 일찍 확보하세요. 요청별 토큰·비용이 콘솔에 표시되므로, 같은 작업을 단일 모델로 돌릴 때와 비교하는 A/B를 처음부터 설계해 두는 편이 안전합니다.
- 장기 작업 위주로 시험하세요. Fugu의 강점은 단발 채팅이 아니라 14시간 자율 실험, 다단계 코딩, 검증 루프가 필요한 워크플로에서 드러납니다.
- 벤더 락인 회피의 실효성은 직접 검증해야 합니다. 특정 모델이 풀에서 빠졌을 때 성능이 어떻게 떨어지는지를 자체 케이스로 측정해 두면, 실제 도입을 결정할 때 근거가 됩니다.