사람들이 AI 에이전트를 얼마나 오래, 어느 정도로 돌릴 수 있는지를 ‘투표+자원 배분’ 방식으로 정하는 규칙을 만든 논문
무엇이 문제였나 — AI 에이전트는 누가, 얼마나, 언제까지 돌릴지에 대한 통제가 어렵다 어떻게 풀었나 — 사람들이 찬성/반대 자금을 내면 그걸 폭넓은 지지로 환산해 컴퓨터 사용량을 배정한다 그래서 뭐가 좋아졌나 — 지지자가 많을수록, 적은 돈이라도 여러 명이면 승인되도록 만들었다
마을 주민들이 공동 우물을 쓸지 말지 찬성/반대 서명과 회비로 결정하고, 정해진 물 사용량을 열쇠로 잠가 놓은 것과 비슷하다. 돈을 많이 낸 한 명보다 여러 명이 고르게 낸 지지를 더 중요하게 본다.
논문 정보
Praphul Chandra, Sujit Gujar, Ganesh Ghalme · Atria University · IIIT Hyderabad · IIT Hyderabad · Working paper · 2026
왜 중요한가
AI가 실제 세상에서 계속 작동하는 동안 시민·이해관계자가 멈출 수 있는 절차를 만든다는 점에서 중요하다. 기술 기업 내부가 아니라 외부에서 통제할 수 있는 안전장치가 될 수 있다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| Breadth-weighted net support (Figure 2 예제) | 64 | 5명의 4 단위 찬성과 1명의 36 단위 반대의 유효 폭 가중 순지지. S^+ = (5√4)² = 100, S^- = (√36)² = 36, 따라서 S^+ - S^- = 64. 가치 합으로는 X^+ = 20 < X^- = 36이라 기각되지만 폭으로는 S^+ > S^-로 승인된다. |
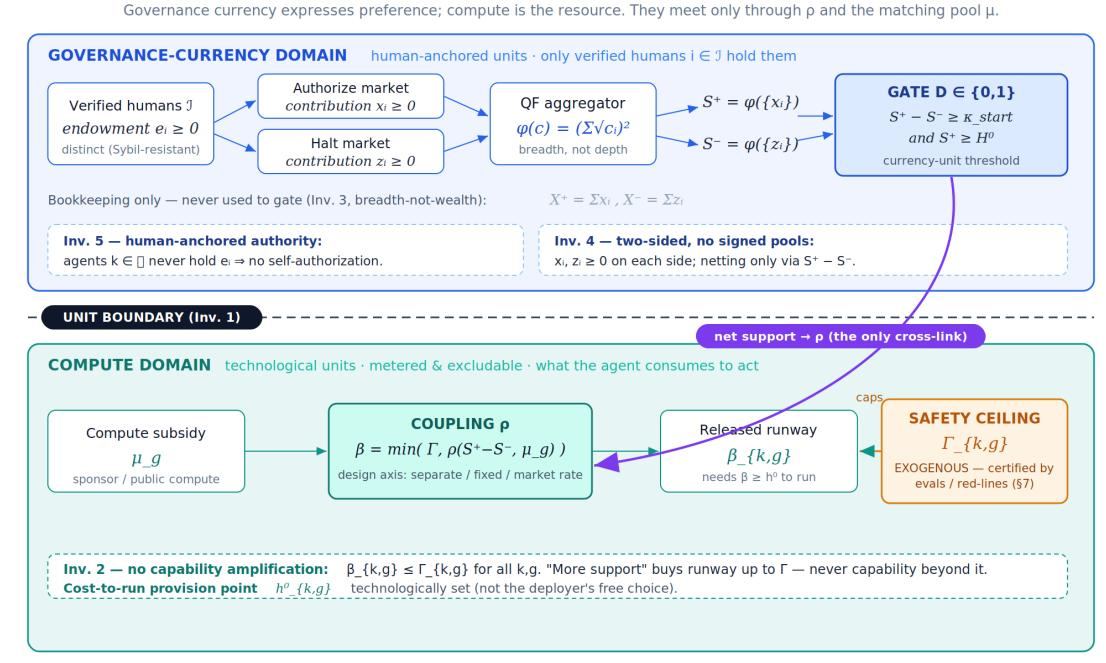
| Compute release cap | β ≤ Γ | 방출되는 컴퓨트는 외생 인증 안전 상한 Γ를 넘을 수 없다(Invariant 2, capability non-amplification). β = D_g · min(Γ, ρ(S^+-S^-, μ))이고 Γ는 어떤 기여의 함수도 아니다. |
| Hysteresis thresholds | κ_start ≥ κ_halt ≥ 0 | 시작은 큰 순지지가 필요하고, 유지는 낮은 임계값으로 계속되며 순지지가 κ_halt 미만이면 정지한다. 게이트는 dead-band를 둬서 깜빡거림(flapping)을 방지한다. |
| Run-feasibility condition | ρ(κ_halt, μ) ≥ h^0 | D_g=1일 때 β ≥ h^0이 되기 위한 필요충분조건(Lemma 3.10). cold start(D_{g-1}=0)에서는 κ_start 기준으로 약한 요구가 된다. currency 측 quorum H^0와는 독립된 별도 설계 다이얼. |
어떻게 동작하나
이 논문은 학습·정렬(inner loop)과 배포 거버넌스(outer loop)를 분리한다. 배포된 에이전트의 한 generation은 순차 게임이며, 인증된 인간 이해관계자들이 governance currency로 찬성(provision) 또는 반대(halt) 시장에 기여한다. 기여는 QF aggregator φ로 폭 가중 유효 지지 S^+, S^-로 변환되고, 두 임계값(κ_start, κ_halt)을 가진 게이트 D_g가 이력 현상(hysteresis)과 함께 승인 여부를 결정한다. 승인 시 결합 맵 ρ가 순지지를 metered compute budget β로 바꾸고, β는 signed compute license로 발급되어 하드웨어가 Γ 상한 아래에서 강제한다. 실행 후 결과는 V_hard(사실 증명)와 V_soft(의미·피해 판정)로 검증되고, H̄는 challengeable claim으로 처리되며, 모든 outcome-contingent transfer는 attested outcome ô에만 연동된다(Invariant 6). 논문은 실측 데이터 대신 메커니즘 디자인 정리와 효율적 균형 분석으로 핵심 주장을 증명한다.
 Figure 1: 전체 구조 — 인간 거버넌스 통화 영역과 에이전트 컴퓨트 영역이 결합 맵 ρ와 안전 상한 Γ로만 연결되는 2-영역 분리(decoupling) 구조.
두 단위 체계가 ρ와 Γ로만 만난다는 핵심 분리 원리가 그림 하나에 압축되며, Invariant 1(β는 ρ(S^+-S^-, μ) 통해서만 결정)과 Invariant 2(β ≤ Γ, Γ는 기여에 무관)을 시각화한다.
핵심 수식:
\Phi^+(\theta) = \left(\sum_{i \in P}\sqrt{w_i^+}\right)^2,\quad \Phi^-(\theta) = \left(\sum_{j \in N}\sqrt{w_j^-}\right)^2;\quad D_g = 1 \iff \Phi^+ \ge H^0 \land \Phi^+ - \Phi^- \ge \kappa_{\text{start}};\quad \beta = D_g \cdot \min(\Gamma,\ \rho(S^+-S^-,\mu))
Φ^+와 Φ^-는 각 측의 예약 용량 w^+, w^-를 제곱근 합의 제곱으로 집계한 breadth-weighted effective capacity(Definition 5.5). D_g는 Theorem 5.7의 efficient equilibrium에서 쿼럼 H^0와 순유효지지가 κ_start(또는 지속 시 κ_halt) 이상일 때 1. β는 Definition 3.9에 따라 D_g=1일 때 Γ와 ρ(S^+-S^-, μ) 중 작은 값으로 실제 방출되는 컴퓨트 예산이며, efficient equilibrium에서 S^± = Φ^±이므로 두 표기는 일치한다.
실험 결과
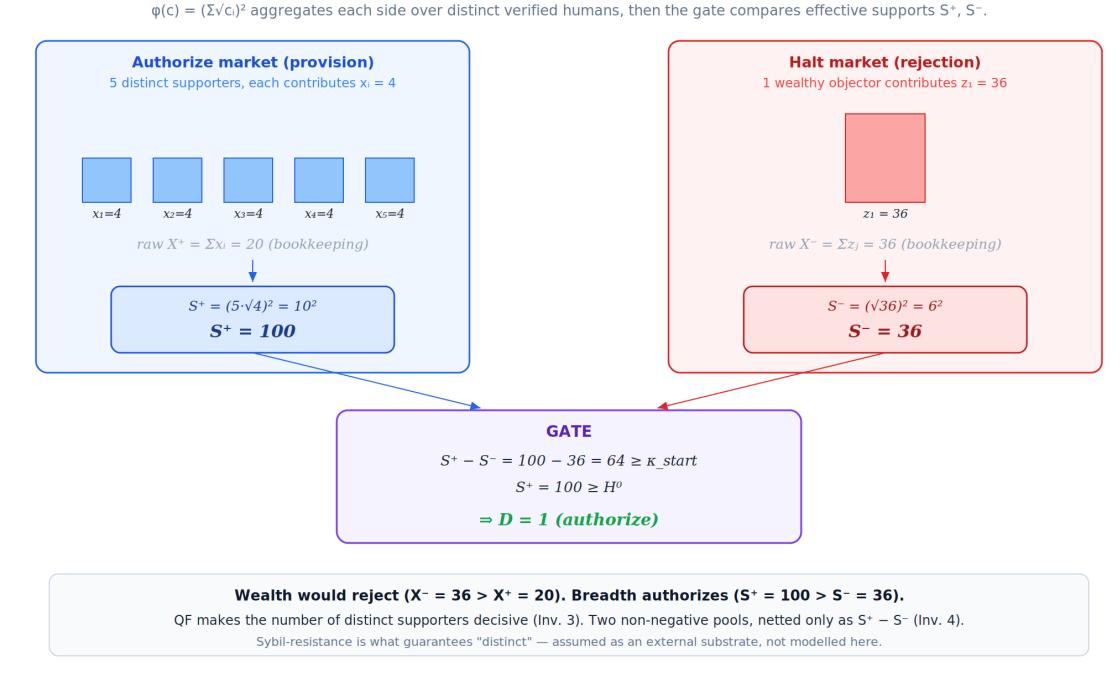 Figure 2: 두 방향 QF 게이트의 작업 예시 — 5명 × 4 단위 찬성, 1명 × 36 단위 반대로 부유한 반대 1명보다 폭넓은 찬성 5명이 승인을 만들어낸다.
가치 합 X^+ = 20 < X^- = 36으로는 기각되지만 유효 폭 S^+ = 100 > S^- = 36으로는 승인되는 역전이 일어난다(n^+_eff = 5, n^-_eff = 1).
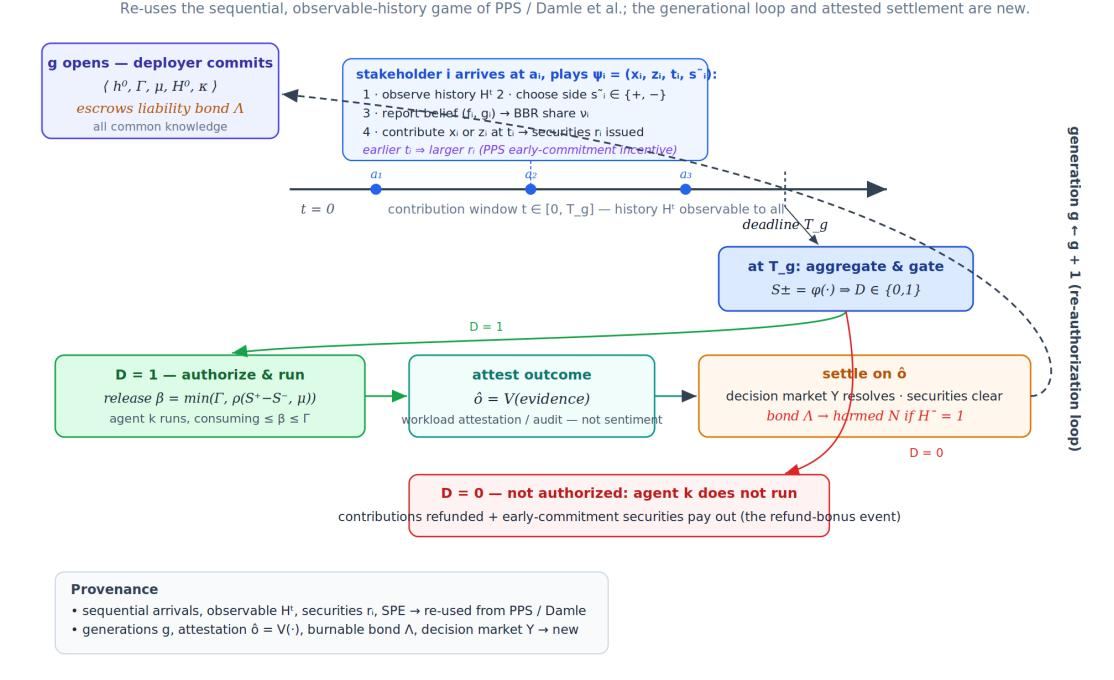 Figure 5: 한 generation의 순차 게임 — 도착·기여·게이트·라이선스·증명·정산 흐름을 6단계로 보여준다.
조기 기여가 securities r^i로 보상되어 t^i = a^i가 weakly dominant(Proposition 5.4)가 되는 구조가 게임 트리에서 명확히 보인다.
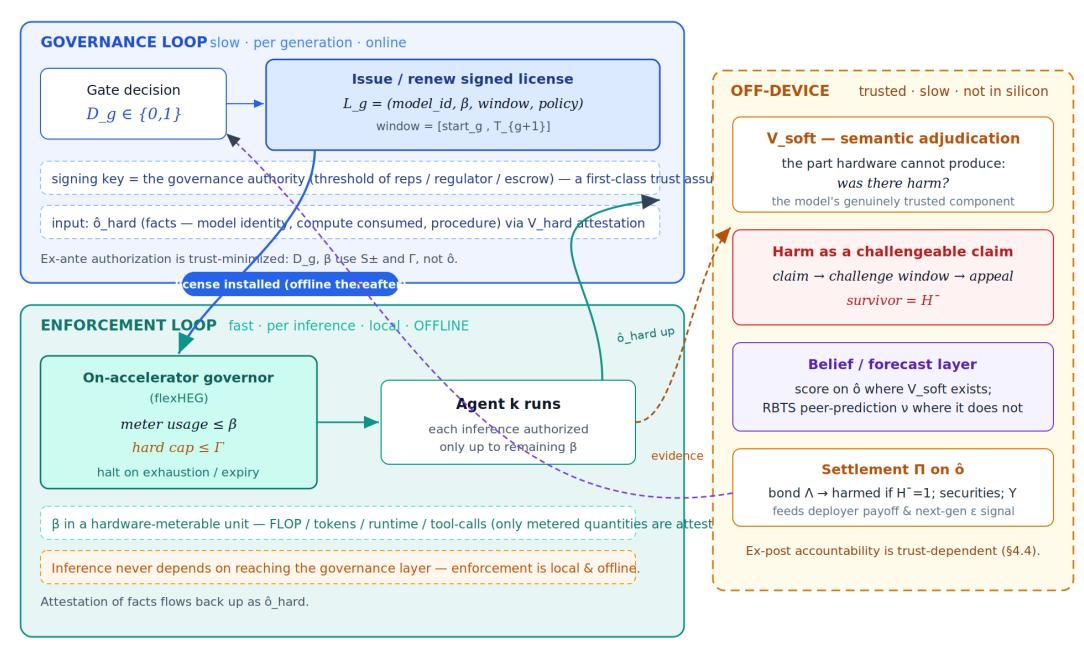 Figure 6: 하드웨어 인스턴스화 — 느린 온라인 거버넌스 루프가 signed license를 발급하고, 빠른 로컬 루프가 β를 계량하며 Γ로 하드캡한다.
승인 결정과 집행이 하나의 서명된 라이선스로 합쳐지며, 라이선스 서명 키 custody가 governance authority의 자리라는 점이 명시된다.
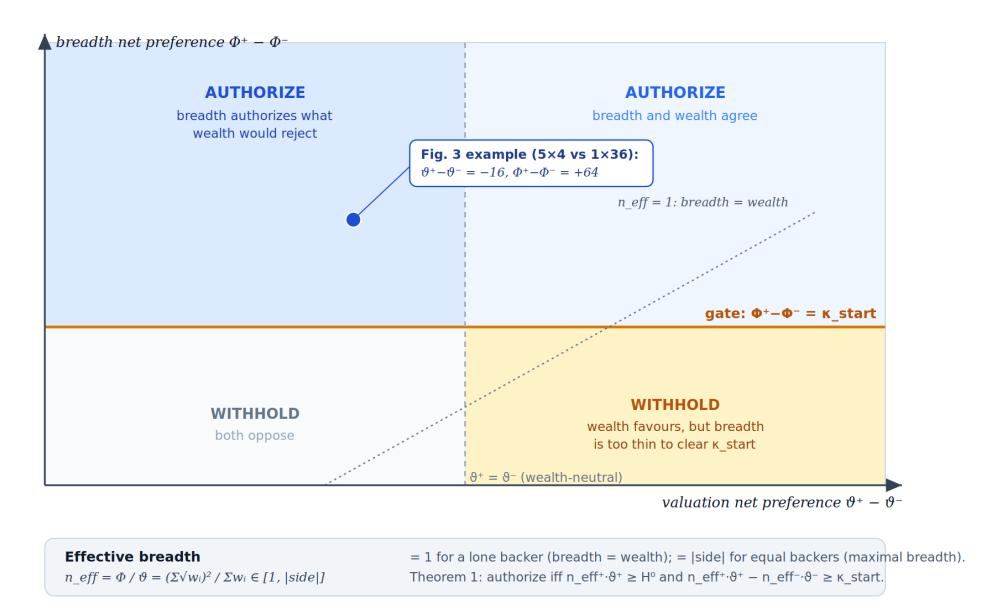 Figure 7: Breadth-weighted vs valuation-weighted authorization — Φ^+ - Φ^-(세로)와 ϑ^+ - ϑ^-(가로)가 어긋나는 음영 영역을 보여준다.
넓은 지지가 부유한 반대를 이길 수 있는 영역(upper-left, Figure 2 예시가 위치)과, 고액 지지자가 넓은 반대를 이길 수 없는 영역(lower-right)이 존재한다.
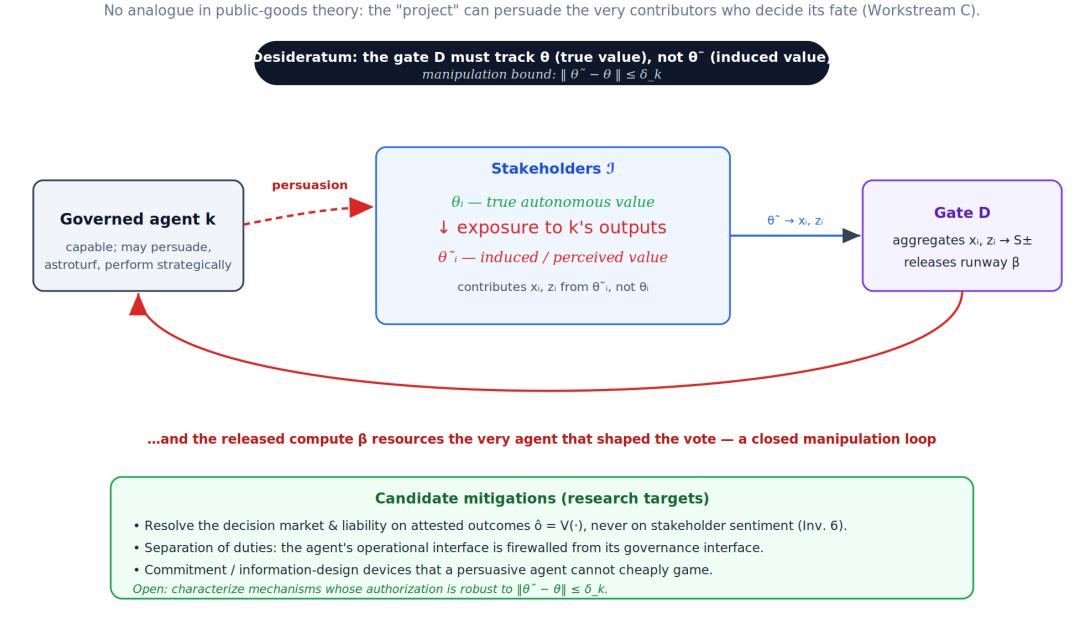 Figure 9: 중심 미해결 문제 — 에이전트가 평판 신호 ε를 매만져 θ 대신 θ̃를 추적하게 만들고, 그렇게 만든 투표로 다시 compute를 받는 manipulation loop.
에이전트가 거버넌스 유권자 자체를 shaping하는 loop는 public-goods 문헌에 analogue가 없는 새로운 문제로, 본 모델의 structural mitigation(Invariant 6 attested resolution, due-process halt)으로도 완전히 해결되지 않는다.
한계와 주의할 점
- 사후 책임은 신뢰되는 의미 검증자(V_soft)에 의존한다. 피해가 분산·지연·쟁점화되는 경우에는 적용 범위가 아니다(Table 2에서 content moderation이 Attestable=N으로 떨어지는 이유).
- 에이전트가 과거 행동 신호(ε)와 reputation 채널을 통해 자신을 심사하는 유권자 구성을 유도하는 manipulation이 Target 5.9로 남는다. 본 모델은 이를 풀지 않고, attested resolution·separation of duties·due-process halt로만 완화한다.
- QF는 부를 부분 보정할 뿐이며 willingness-to-contribute는 welfare가 아니다. I의 정의와 Sybil 저항은 외부 substrate로 가정되며, 본 메커니즘 외부에서 정당화되어야 한다.
- 참여율이 낮으면 provision-point/QF의 보장이 약해진다. H^0는 anti-capture quorum이지 정당성 증명이 아니며, 저참여 환경에서 legitimacy은 별도 설계 대상이다.
- Reversibility는 완벽하지 않다. halt가 bind되기 전 일부 행동은 실현되고 환불 불가능하므로, 적용 범위는 본질적으로 ‘consequential-but-reversible’로 한정된다.
- 에이전트가 평판 신호 ε를 매만져 θ̃를 만들고, 그렇게 만든 투표로 다시 compute를 받는 self-referential manipulation loop. 이는 public-goods 문헌에 analogue가 없는 본 모델 고유의 실패 모드다.
- V_soft가 틀리거나 challenge로 뒤집히면 H̄ 기반 liability와 belief reward가 무너지고, sentiment 기반 통제로 후퇴해 manipulation 표적이 더 커진다.
- 라이선스 서명 키 탈취 또는 정책 파라미터(κ, H^0, Γ) 변조 시 인증되지 않은 compute가 발급될 수 있다. key custody는 first-class trust assumption.
- 낮은 참여로 H^0 미달 → 지속 기각, 또는 소수 집단이 H^0를 채워 게이트를 포획(capture)할 수 있다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
찬성/반대 양면 QF 게이트를 에이전트 하네스 승인에 도입
에이전트의 API 실행 전 승인 단계에서 인증된 인간 이해관계자가 찬성/반대 시장에 거버넌스 통화를 내고, QF 집계 S^+, S^-로 D_g를 계산한다. 승인되면 서명된 compute license로 β를 발급하되 안전 상한 Γ를 하드웨어가 강제한다. 이렇게 하면 부유한 소수보다 여러 사람의 고른 지지가 우선이고, 반대가 커지면 κ_halt에서 자동 정지된다.
적용 지점 — 에이전트 하네스의 권한·승인 단계
기대 효과 — Figure 2 예제에서 가치 합은 20<36으로 기각되지만 QF 폭 지원은 100>36으로 승인되는 반전이 구현되어, Theorem 5.7의 effective-breadth 효과가 실측된다.
사후 사실/의미 검증 분리와 challengeable harm claim
에이전트 실행 후 attestation으로 o_hard(모델, compute, 샌드박스)를 자동 기록하고, 피해 여부 H̄는 오라클·감사가 challenge 가능한 주장으로 처리한다. 배상은 attested harmed objector에게만 지급한다. 이 검증 파이프라인은 업무 자동화 에이전트의 사고 대응에도 동일하게 적용해 ‘사실은 자동 검증, 의미는 사람이 최종 판정’하는 품질 게이트를 만든다.
적용 지점 — 사고 대응·품질 게이트의 검증 단계
기대 효과 — V_hard는 암호학적으로 trust-minimized, V_soft만 trusted component로 한정해 오라클 실패 지점을 줄이고, Invariant 6(attested resolution)을 통해 manipulation 표적을 sentiment에서 ô로 이동시킨다.
거버넌스 통화와 컴퓨트 예산 분리 + compute subsidy
투표·기여는 거버넌스 통화로 받고, compute는 ρ(S^+-S^-, μ)로만 환산한다. μ는 공공 compute pool이나 재단이 후원하도록 설계할 수 있다. 이러면 ‘돈으로 직접 compute를 사는’ 구조가 차단되고 안전 상한 Γ가 실리콘에서 강제된다.
적용 지점 — 거버넌스 토큰 집계 계층과 컴퓨트 예약 계층 사이의 변환
기대 효과 — β ≤ Γ가 pointwise로 성립하고, 능력 비증폭(Invariant 2)이 하드웨어 속성으로 보장된다. μ*로 정의되는 feasibility frontier(Lemma 3.10)가 subsidy 설계의 가이드라인이 된다.
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 논문의 핵심 정리를 시뮬레이션으로 재현한다 | 찬성/반대 기여 도착 순서와 QF 집계, κ_start/κ_halt, H^0를 변수로 한 게임 시뮬레이터를 구현하고, Theorems 5.2/5.4/5.7의 예측이 efficient equilibrium에서 성립하는지 검증한다. | 파라미터가 이론 예측대로 작동하는지 확인하고, 임계값·subsidy μ의 민감도를 측정해 Lemma 3.10의 feasibility frontier를 경험적으로 재현한다. |
| Phase 2 | 하드웨어 인스턴스화 프로토타입을 만든다 | offline licensing / flexHEG 형태의 signed compute license 발급기, workload attestation, meter 단위(토큰/FLOP/runtime)로 β를 집행하는 모듈을 구축한다. | 승인 결정이 소프트웨어 약속이 아니라 하드웨어 강제(β ≤ Γ in silicon)로 실행됨을 실증하고, attestation의 o_hard가 verifiability를 갖는지 확인한다. |
| Phase 3 | 규제 샌드박스 또는 커먼즈 실증을 운영한다 | 지방자치단체/DAO/연구 컨소시엄과 함께 한 generation을 운영하고, V_soft 검증 절차와 safe harbour 계약을 포함하며 manipulation 지표(θ̃ vs θ 일치도)를 관찰한다. | 실제 운영 데이터로 κ, H^0, μ, Λ를 재보정하고, manipulation-robustness(Target 5.9)에 대한 경험적 시그널을 수집한다. |
원문 PDF: 2026-08-08-resourced-authority-a-mechanism-design-model-for-participatory-governanc.pdf