요리 레시피처럼 ‘순서가 있는 작업 절차’ 데이터를 표로 억지로 펴지 않고, 원래 생긴 모양(단계 안에 여러 항목, 단계들이 순서대로) 그대로 읽어서 다음 단계를 훨씬 잘 맞히는 AI를 만든 연구다.
무엇이 문제였나 — 지금까지의 표 데이터 AI는 모든 줄의 칸 개수가 똑같아야 해서, 단계 수도 다르고 빈칸도 많은 ‘절차 데이터’를 억지로 한 줄로 펴서 넣어야 했고 그 과정에서 순서와 묶음 정보가 사라졌다. 어떻게 풀었나 — 그래서 ‘한 단계 안의 항목들끼리 먼저 읽는 AI’와 ‘단계들의 순서를 읽는 AI’를 위아래로 두 겹 쌓고, 빈칸은 아예 넣지 않고 적혀 있는 항목만 읽게 했다. 그래서 뭐가 좋아졌나 — 3개 실제 재료 합성 데이터에서 기존 방법보다 항상 더 정확했고(빠진 단계 맞히기는 거의 만점 수준), 학습에 걸리는 시간도 비슷한 계열 방법 중 가장 짧았다.
요리책 레시피를 한 줄로 이어 붙여 ‘25도, 5분, 20g, 80도, 20분…’ 이라고만 적어두면, 어느 숫자가 어느 단계 것인지, 무엇이 먼저인지 알 수 없다. RecipeNet은 대신 단계별 카드를 만들어 한 장 안에서 ‘온도·시간·재료’를 함께 읽고, 그다음 카드들을 순서대로 넘겨 보며 전체 흐름을 이해한다. 빈칸이 있는 항목은 카드에 아예 적지 않아 읽을 것도 줄어든다.
논문 정보
Pin-Yen Huang, Sachin Chhabra, Prasanth Sai Gouripeddi, Abhinav Kumar, Baoxin Li · Arizona State University · Applied Materials · University of Illinois Chicago · CIKM ‘26 (35th ACM International Conference on Information and Knowledge Managem · 2026
왜 중요한가
공장 공정, 신약 제형, 반도체 레시피처럼 ‘무엇을 어떤 순서로 얼마나’ 하는 기록은 어디에나 있지만, 대부분 엑셀 한 줄로 눌러 담은 채 분석된다. 이 연구는 그 기록을 원래 순서와 묶음 그대로 읽는 방법을 보여줘서, 다음에 할 공정을 예측하거나 기록이 빠진 자리를 찾아내는 일이 훨씬 정확해진다. 게다가 빈칸을 계산하지 않아 더 빨라지기까지 한다.
핵심 지표
| 지표 | 값 | 설명 |
|---|---|---|
| Sol-gel Next-step | 0.406 | Sol-gel 전구체 합성 다음 단계 예측 balanced accuracy, 최고 베이스라인 TabNet 0.363 대비 +0.043 |
| Sol-gel Masked-step | 0.999 | 가려진 단계 복원 balanced accuracy, 최고 베이스라인 CatBoost 0.981 대비 +0.018 (거의 포화) |
| 학습 시간 절감 | 18% | Solid-state Reactions 데이터셋에서 Transformer 계열 최속 베이스라인 대비 총 학습 시간 감소 |
| 전 조건 1위 | 6 / 6 | 3개 데이터셋 × 2개 과제 = 6개 조건 전부에서 8개 베이스라인 대비 최고 성능 |
어떻게 동작하나
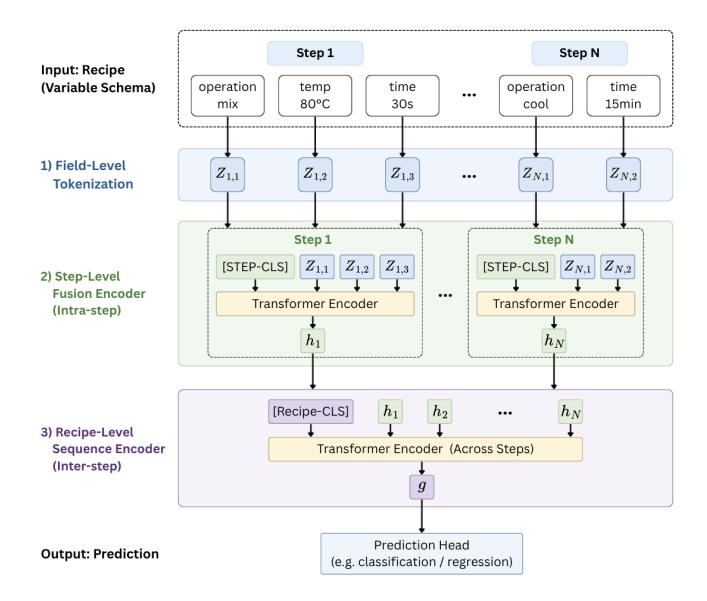
RecipeNet은 레시피를 순서 있는 단계 집합 R = {S_1, …, S_N}으로 두고, 각 단계가 서로 다른 개수의 관측 필드를 갖는 구조를 그대로 유지한다. 먼저 field-level tokenization 단계에서 수치 필드는 학습된 선형 사영(e^{(num)} = W_num x + b_num)으로, 범주 필드는 필드별 embedding table(Embedding_f(c))로 공통 잠재 공간(차원 d)에 매핑하고, 여기에 학습된 step-position embedding과 field-identity embedding을 더해 최종 토큰 z_{r,j} = e_r^{(step)} + e_{r,j}^{(field)} + e_{r,j}^{(value)}를 만든다. 이때 관측된 필드만 토큰으로 만들기 때문에 결측 칸을 위한 padding 자체가 사라지고, 이것이 가변 스키마 수용과 연산 절감의 근거가 된다. 이어 Step Fusion Encoder가 각 단계 내부 필드 토큰들에 [STEP-CLS]를 붙인 뒤 Transformer encoder를 적용해 온도–압력 같은 필드 간 상호작용을 담은 단계 표현 h_n을 뽑는다. 마지막으로 Recipe-Level Sequence Encoder가 [RECIPE-CLS]와 단계 표현 시퀀스를 두 번째 Transformer encoder에 통과시켜 장거리 절차 의존성을 반영한 레시피 표현 g를 만들고, 선형 prediction head ŷ = Wg + b가 다운스트림 분류·회귀를 수행한다. 실험은 Text-Mined Synthesis Project의 solid-state reaction·sol-gel precursor synthesis 데이터셋과 solution synthesis 데이터셋에서, 동일 하이퍼파라미터(lr 1e-4, batch 32, 51,200 iterations, cosine scheduler, AdamW, cross-entropy)와 seed 0/1/2 반복으로 balanced accuracy 평균±표준편차를 보고한다.
 RecipeNet 전체 구조: field-level tokenization → Step Fusion Encoder([STEP-CLS]) → Recipe-Level Sequence Encoder([RECIPE-CLS]) → prediction head의 3단 계층 파이프라인.
Transformer가 두 층위로 분리되어 있다는 점이 핵심 — 아래층은 단계 내 필드 상호작용, 위층은 단계 간 절차 의존성을 각각 전담한다.
핵심 수식:
z_{r,j} = e_r^{(step)} + e_{r,j}^{(field)} + e_{r,j}^{(value)} \ h_n = \text{Transformer}_{step}([\text{STEP-CLS}], z_{n,1}, \dots, z_{n,m_n})_{[0]} \ g = \text{Transformer}_{recipe}([\text{RECIPE-CLS}], h_1, \dots, h_N)_{[0]}, \quad \hat{y} = Wg + b
e^{(value)}는 수치(W_num x + b_num) 또는 범주(Embedding_f(c)) 값 임베딩, e^{(step)}은 몇 번째 단계인지, e^{(field)}는 어떤 필드인지를 담는 학습 임베딩이며, h_n은 단계 n의 [STEP-CLS] 출력, g는 전체 레시피 표현, m_n은 단계 n의 관측 필드 수(고정 스키마 위치에 의존하지 않음)다.
실험 결과
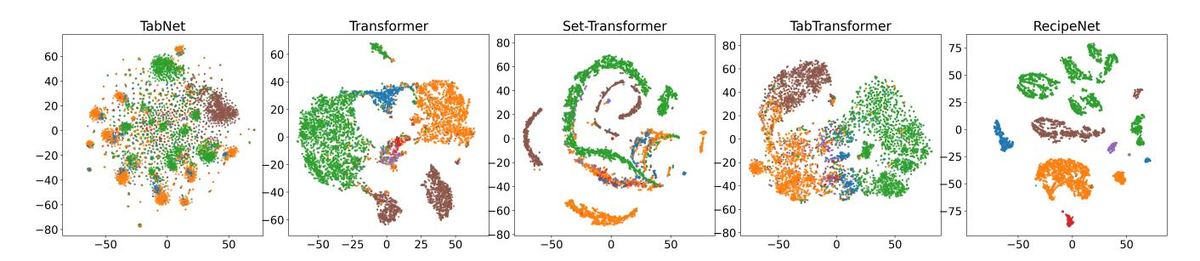 Sol-gel precursor synthesis 데이터셋에서 학습된 레시피 표현의 t-SNE 시각화(색 = 목표 클래스), 베이스라인과 나란히 비교.
RecipeNet 쪽이 클래스별로 더 조밀하고 분리된 군집을 만들며, 베이스라인은 클래스 간 혼합·분산이 크다 — 표현 자체가 더 판별적임을 정성적으로 뒷받침한다.
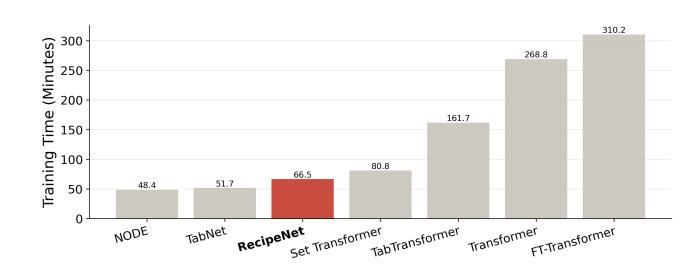 Solid-state Reactions 데이터셋에서 신경망 기반 tabular 모델들과의 총 학습 시간 비교.
RecipeNet은 Transformer 계열 중 가장 빠르며 최속 경쟁 모델 대비 약 18% 단축 — 성능 향상이 연산량 증가의 대가가 아니라는 근거다(단, NODE·TabNet 등 비-Transformer 모델은 더 빠르다).
한계와 주의할 점
- 평가가 무기물 합성 도메인 3개 데이터셋(solid-state, sol-gel, solution)과 2개 자기지도성 과제(next-step, masked-step)에 국한되어, 초록·서론에서 언급된 반도체 공정·제약 제형·요리 등 다른 레시피 도메인이나 수율·품질 같은 실제 회귀 타깃에 대한 검증이 없다.
- masked-step prediction은 RecipeNet 0.994~0.999에 더해 CatBoost 0.981, Set Transformer 0.986 등 베이스라인도 이미 포화 구간이라, 이 과제만으로는 계층 구조의 우위를 판별하기 어렵다. 실질적 격차는 next-step(0.406 vs 0.363, 0.453 vs 0.439, 0.585 vs 0.573 등)에 몰려 있다.
- seed 3개(0,1,2) 평균±표준편차만 보고할 뿐 유의성 검정(p-value, 신뢰구간)이 없다. 특히 Solid-state next-step은 RecipeNet 0.453±0.001 vs Transformer 0.439±0.010으로 격차가 표준편차 수준에 가깝다.
- 모든 신경망 기법에 동일 하이퍼파라미터(lr 1e-4, batch 32, 51,200 iters)를 적용했고 고전 기법은 scikit-learn 기본값을 썼다. 베이스라인별 튜닝이 없으므로, NODE가 전 조건 0.167±0.000(사실상 다수 클래스 붕괴)로 고정된 것처럼 일부 비교는 기법 자체보다 설정 미스매치를 반영할 소지가 있다.
- 잠재 차원 d, 레이어 수, 헤드 수 등 아키텍처 규모와 파라미터 수가 명시되지 않아 학습 시간 18% 절감이 구조적 이득인지 모델 용량 차이인지 분리되지 않는다. 또한 추론 지연(latency)이 아닌 총 학습 시간만 측정되었다.
- 단계 수 N이 매우 긴 레시피에서는 recipe-level encoder의 self-attention이 O(N²)로 늘어나, 관측 필드만 토큰화해 얻은 연산 이득이 상쇄될 수 있다.
- ‘결측’이 무작위가 아니라 의미를 갖는 경우(예: 압력 미기재 = 상압) 관측 필드만 토큰화하는 설계가 그 정보를 통째로 버려, 결측 패턴 자체를 신호로 쓰는 XGBoost/CatBoost보다 불리해질 수 있다.
- 학습 시 보지 못한 신규 필드나 신규 범주값이 들어오면 field-identity embedding·embedding table에 대응 항목이 없어 표현이 무너진다 — 스키마가 계속 확장되는 실운영 환경의 주요 위험이다.
- next-step prediction 절대 성능이 0.406~0.585 수준에 머물러, 다음 공정 단계를 단독 자동 결정에 쓰기에는 오답률이 높다. 특히 클래스 불균형이 심한 도메인에서는 NODE가 보인 0.167 붕괴 같은 다수 클래스 예측 고정이 재현될 수 있다.
시스템 적용 아이디어
논문의 기법을 비슷한 구조를 가진 시스템에 옮길 때의 적용 지점이다.
결측 칸을 아예 토큰화하지 않는 ‘관측 필드 전용’ 구조 인코더
RecipeNet의 field-level tokenization은 관측된 필드만 토큰으로 만들고, 위치 대신 학습된 field-identity embedding으로 ‘어떤 필드인지’를 식별한다(z_{r,j} = e^{(step)} + e^{(field)} + e^{(value)}). 구조화된 이벤트·설정·로그를 임베딩해 다루는 파이프라인에서는 보통 전체 스키마를 고정 폭으로 펴고 빈 칸을 null/0으로 채워 넣는데, 이 자리에 동일한 방식을 적용하면 결측 칸에 대한 어텐션 연산이 통째로 사라진다. 논문은 이 설계로 Transformer 계열 최속 베이스라인 대비 총 학습 시간을 약 18% 줄이면서 성능은 오히려 높였다고 보고한다. 단, 결측 자체가 의미를 갖는 필드(미기재 = 기본값)는 명시적 플래그 필드로 승격해야 정보 손실을 피한다.
적용 지점 — 가변 스키마 구조화 데이터의 임베딩·인코딩 단계
기대 효과 — 논문 기준 Transformer 계열 최속 베이스라인 대비 총 학습 시간 약 18% 감소, 동시에 6개 평가 조건 전부에서 성능 우위
실행 이력을 ‘단계 요약 → 세션 요약’ 2단 CLS로 압축하는 에피소드 인코더
RecipeNet은 [STEP-CLS]를 붙인 Step Fusion Encoder로 한 단계 안의 이질적 필드를 벡터 h_n으로 접고, 그 h_n 시퀀스만 [RECIPE-CLS]가 붙은 Recipe-Level Encoder에 넣어 최종 표현 g를 얻는다. 장기 기억을 쓰는 에이전트의 에피소드 저장 단계에 이 2단 구조를 그대로 옮기면, 툴 호출 한 건(도구명·인자·결과 상태·소요)이 단계 하나가 되고 세션 전체는 단계 벡터열이 되어, 원문 전체를 평평하게 임베딩할 때보다 순서 정보를 보존한 채 시퀀스 길이가 단계 수만큼으로 줄어든다. 회수 시에는 g를 세션 수준 키로, h_n을 단계 수준 키로 두어 ‘비슷한 작업 전체’ 검색과 ‘비슷한 단계’ 검색을 분리할 수 있다. 논문의 ablation에서 recipe-level encoder를 제거하면 next-step이 0.406→0.351로 떨어져, 상위 시퀀스 인코더가 실제로 절차 맥락을 담당함이 확인된다.
적용 지점 — 에이전트 장기 기억의 에피소드 압축 및 회수 인덱싱
기대 효과 — 논문 ablation 기준 상위 시퀀스 인코더 유무가 next-step 0.351 → 0.406 차이를 만듦 — 순서 의존 회수 품질 개선의 직접 근거
masked-step 복원기를 절차 누락 탐지 게이트로 재사용
논문의 masked-step prediction은 나머지 단계 맥락만 보고 가려진 단계를 복원하는 과제로, RecipeNet은 세 데이터셋에서 0.994~0.999 balanced accuracy를 보였다. 절차형 작업을 수행하는 에이전트나 워크플로 엔진의 종료 조건에 이 헤드를 자기검증기로 붙이면, ‘이 맥락이면 여기에 있었어야 할 단계’를 모델이 제시하고 실제 이력에 그 단계가 없을 때 미완료로 판정할 수 있다. 규칙 기반 체크리스트와 달리 스키마가 고정되지 않아도 되고, 학습 데이터가 곧 정상 절차의 분포 역할을 한다. 이 과제는 CatBoost 0.981 등 베이스라인도 이미 높은 포화 구간이므로, 게이트로 쓸 때는 절대 성능이 아니라 불일치 지점의 정밀도를 별도로 측정해야 한다.
적용 지점 — 다단계 작업의 종료 조건 판정 및 자기검증 단계
기대 효과 — masked-step 복원 balanced accuracy 0.994~0.999 (Solid-state 0.995 / Sol-gel 0.999 / Solution 0.994)
위치 인덱스 대신 ‘필드 정체성 + 단계 순번’ 임베딩을 쓰는 스키마-프리 입력 규약
RecipeNet은 토큰의 의미를 위치가 아니라 e^{(field)}(어떤 필드인가)와 e^{(step)}(몇 번째 단계인가)의 합으로 부여한다. 필드 순서나 개수가 바뀌어도 임베딩 항목만 추가하면 되므로, 스키마 변경 때마다 열을 재정렬하고 전체 테이블을 다시 만드는 작업이 사라진다. 구조화된 요청·설정·이벤트를 모델 입력으로 넘기는 어떤 파이프라인에도 동일 규약을 적용할 수 있고, 신규 필드에 대비해 OOV 전용 field-identity 토큰을 예약해 두면 미학습 필드 유입 시 표현 붕괴도 완화된다. 논문 ablation에서 field embedding 제거 시 0.406→0.391, step embedding 제거 시 0.406→0.369로 두 임베딩 모두 독립적으로 기여함이 확인된다.
적용 지점 — 가변 스키마 구조화 입력의 토큰화 규약 설계
기대 효과 — 논문 ablation 기준 step embedding 기여 +0.037, field embedding 기여 +0.015 (Sol-gel next-step balanced accuracy)
표현 군집도(t-SNE 분리도)를 인코더 교체 시 통과 기준으로 삼는 품질 게이트
논문은 Sol-gel 데이터에서 학습된 recipe representation을 t-SNE로 투영해, RecipeNet이 베이스라인보다 조밀하고 겹침이 적은 클래스 군집을 만든다는 점을 보인다. masked-step처럼 여러 기법이 0.98~0.99대에 몰려 정확도만으로는 우열이 안 갈리는 상황에서, 표현 공간의 분리도는 추가 판별 신호가 된다. 임베딩 모델이나 인코더를 교체하는 만들기→검토 루프에 이 지표(군집 응집도·클래스 간 중첩)를 자동 산출해 붙이면, 정확도가 동률일 때 어느 쪽이 더 판별적인 표현을 만들었는지로 승격 여부를 가를 수 있다. 시각화가 아니라 수치화된 형태로 CI에 고정해야 회귀 검출에 쓸모가 있다.
적용 지점 — 임베딩·인코더 교체 시의 품질 게이트 및 회귀 테스트
기대 효과 — 정확도 포화 구간(masked-step 0.98~0.99대에 다수 기법 밀집)에서 표현 품질 차이를 추가로 판별 — 논문은 동일 상황에서 t-SNE 분리도로 우위를 입증
단계별 도입 로드맵
| 단계 | 목표 | 액션 | 기대 효과 |
|---|---|---|---|
| Phase 1 | 자사 절차 데이터의 계층 스키마 정의와 재현 검증 | 보유 공정/배합 로그를 R = {S_1..S_N}, 각 단계의 관측 필드 집합 형태로 정규화하는 어댑터를 만들고, 공개 저장소(github.com/pm25/recipenet) 구현으로 solid-state·sol-gel·solution 3개 데이터셋 결과(0.453/0.995, 0.406/0.999, 0.585/0.994)를 seed 0/1/2로 재현한다. 동시에 XGBoost·CatBoost를 flatten+padding 방식으로 돌려 내부 데이터 기준선을 확보한다. | 전처리 손실 없이 자사 데이터를 넣을 수 있는 경로 확보 및 논문 수치의 재현 가능성 확인, 내부 baseline 대비 격차의 초기 추정치 확보 |
| Phase 2 | 실제 비즈니스 타깃으로 파인튜닝 및 구성요소 검증 | masked-step / next-step으로 사전학습한 표현 위에 수율·불량·품질 등 실제 타깃 head를 붙여 파인튜닝하고, 논문의 ablation(w/o Step Encoder 0.334, w/o Recipe Encoder 0.351, w/o Hierarchy 0.398 vs full 0.406)을 자사 데이터에서 재실행해 어느 구성요소가 실제로 기여하는지 확인한다. 미관측 필드·신규 범주 유입에 대비한 OOV 토큰과 결측-의미(missing-as-signal) 플래그 필드를 추가 실험한다. | 도메인 특화 성능 확보와 함께, 계층 구조 중 실제로 값을 내는 부분만 남기는 경량화 근거 확보. 결측 정보 손실이라는 알려진 실패 모드 사전 차단 |
| Phase 3 | 운영 배포와 지속 학습 체계 구축 | 레시피 감사(이상·누락 탐지)는 자동 알림으로, 다음 단계 추천은 사람 검토가 붙는 상위 k 후보 제시로 분리 배포한다. 학습 시간 18% 절감 이점을 살려 신규 레시피 누적 시 주기적 재학습 파이프라인을 돌리고, 신규 필드 등장률·클래스 분포 드리프트·balanced accuracy를 모니터링 지표로 고정한다. | 기록 품질 이슈의 조기 검출과 공정 설계 리드타임 단축, 스키마 변화에 재전처리 없이 대응하는 운영 체계 확립 |
원문 PDF: 2026-08-18-recipenet-a-hierarchical-transformer-for-recipe-data.pdf