개요
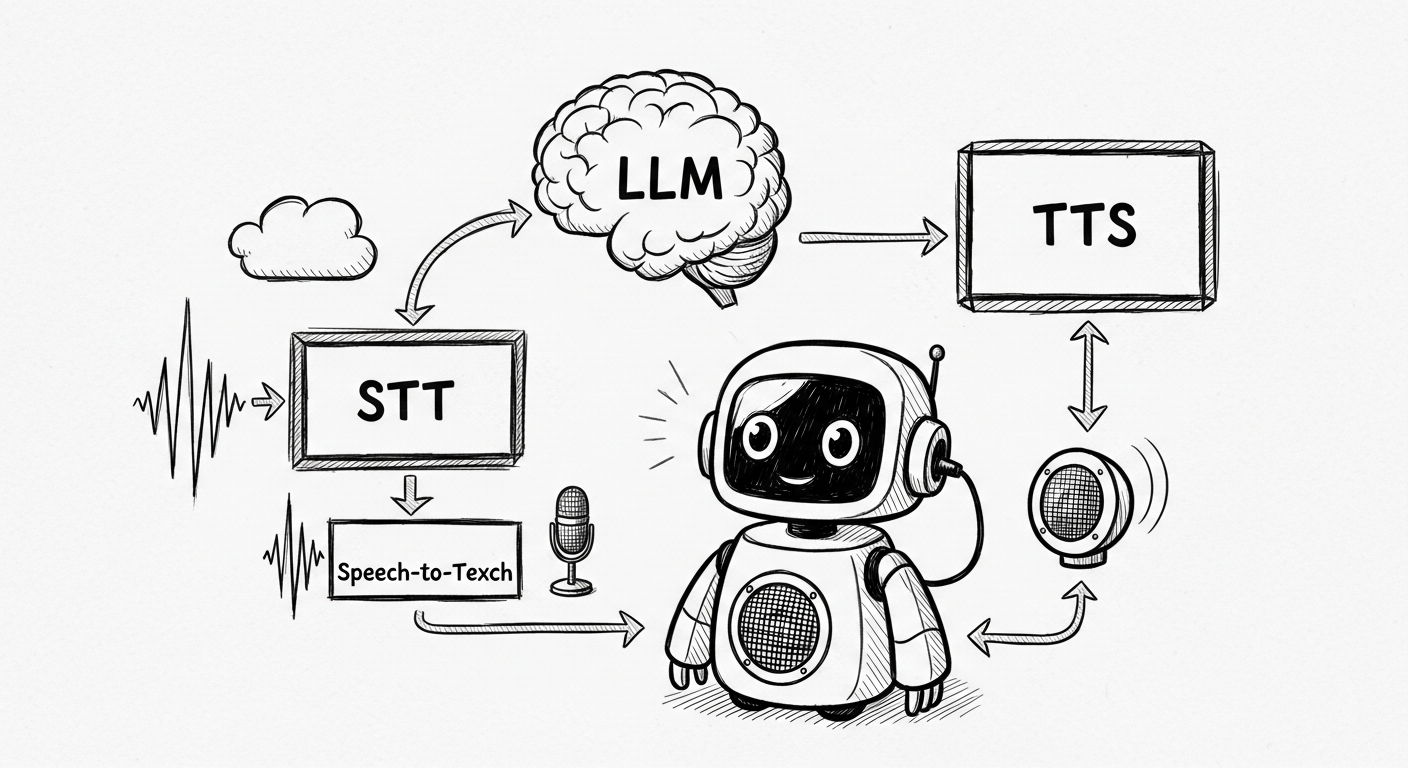
Reachy Mini 로봇의 대화 기능이 완전 로컬로 전환됐다. 기존에는 음성 데이터를 서버로 전송해야 했다. 이제 VAD, STT, LLM, TTS 전 단계가 사용자 기기에서 실행된다. HuggingFace의 speech-to-speech 라이브러리가 캐스케이드 파이프라인을 단일 CLI로 묶었다. 오디오가 네트워크 밖으로 나가지 않고, API 키도 API 비용도 없다.
핵심 요약
- 완전 로컬: 오디오·텍스트가 기기 밖으로 나가지 않음
- 스택: Silero VAD → Parakeet-TDT 0.6B v3 STT → llama.cpp(Gemma 4) → Qwen3-TTS
- 설치:
uv pip install speech-to-speech+llama-server두 명령으로 동작 - LLM 백엔드 5종: llama.cpp, vLLM, HF Inference Endpoints, HF Inference Providers, OpenAI 호환
- Apple Silicon: MLX로 Qwen3-4B-Instruct-2507 로컬 구동 지원
- 교체 가능: VAD, STT, TTS, LLM 각 단계를 독립적으로 교체 가능
본문
로컬로 전환한 이유
클라우드 기반 음성 백엔드는 편리하지만 세 가지 문제가 있다. 오디오가 외부 서버로 나가는 프라이버시 문제, 분당 혹은 토큰당 비용, 그리고 파이프라인 구성 요소를 바꿀 수 없다는 제약이다.
speech-to-speech 라이브러리는 이 세 문제를 한 번에 해결한다. WebSocket 서버를 로컬에 띄우고 Reachy Mini의 대화 앱이 그 서버에 연결한다. 프로토콜은 Realtime API와 호환된다.
추천 기본 스택
캐스케이드 파이프라인의 네 단계별 기본 선택이다.
| 단계 | 모델 | 이유 |
|---|---|---|
| VAD | Silero VAD v5 | 작고 정확하며 CPU에서 동작. 오픈소스 음성 에이전트의 사실상 표준 |
| STT | Parakeet-TDT 0.6B v3 | 스트리밍 친화적, 빠름, 영어 품질 우수 |
| LLM | Gemma 4 (llama.cpp) | 멀티링귤, 저지연, 로컬 구동 효율 |
| TTS | Qwen3-TTS | 표현력 있음, 저지연, 다국어, 커스텀 음성 지원 |
각 단계는 독립적으로 교체 가능하다. 매주 새 모델이 나오는 환경에서 캐스케이드 방식의 핵심 장점이다.
빠른 시작: 두 터미널
터미널 1 — LLM 서버 실행:
llama-server -hf ggml-org/gemma-4-E4B-it-GGUF -np 2 -c 65536 -fa on --swa-full
처음 실행 시 모델을 다운로드한다. 이후 실행은 빠르다.
주요 플래그:
-np 2: 병렬 슬롯 2개. 인터럽션 요청을 블로킹 없이 처리-c 65536: 64k 컨텍스트 윈도우-fa on: Flash Attention. 빠르고 메모리 효율적--swa-full: 슬라이딩 윈도우 어텐션 캐시 유지. Gemma에서 프롬프트 처리 속도 향상
터미널 2 — speech-to-speech 실행:
uv pip install speech-to-speech
speech-to-speech --responses_api_base_url "http://127.0.0.1:8080" --responses_api_api_key "" --mode local
처음 실행 시 Parakeet-TDT와 Qwen3-TTS를 다운로드한다. 터미널에서 바로 모델과 대화할 수 있다. --mode local 없이 실행하면 로봇에 서빙하는 모드로 전환된다.
LLM 백엔드 5가지 옵션
llama.cpp 외에도 다양한 백엔드를 지원한다.
vLLM (v0.21.0 이상 필요)
vllm serve Qwen/Qwen3-4B-Instruct-2507 \
  --enable-auto-tool-choice \
  --tool-call-parser qwen3_coder \
  --default-chat-template-kwargs '{"enable_thinking":false}'
--speculative-config로 Multi-Token Prediction을 활성화하면 엔드투엔드 레이턴시를 크게 낮출 수 있다. enable_thinking: false는 대화 자연스러움을 위해 중요하다. 추론 토큰이 사용자가 침묵으로 느끼는 지연 시간이 되기 때문이다.
Apple Silicon — MLX
speech-to-speech \
  --llm_backend mlx-lm \
  --model_name "mlx-community/Qwen3-4B-Instruct-2507-bf16"
M 시리즈 칩에서 가장 낮은 마찰로 실행된다.
HuggingFace Inference Endpoints / Providers
로컬 GPU가 없거나 관리형 인프라를 원한다면 --responses_api_base_url만 바꾸면 된다. HF Inference Endpoints, Together, Fireworks, Replicate 등 Responses API를 구현한 어떤 프로바이더든 연결 가능하다.
OpenAI 호환 프로바이더
speech-to-speech \
  --llm_backend responses-api \
  --model_name "gpt-5.4" \
  --responses_api_api_key "$OPENAI_API_KEY"
프런티어 모델을 인프라 구성 없이 테스트할 때 유용하다.
Reachy Mini 연결
speech-to-speech 서버가 실행 중이면 로봇의 대화 앱 UI에서 “edit connection” → HF backend → local mode를 선택하면 된다. 이후 로봇과 바로 대화할 수 있다.
실무자가 볼 핵심 포인트
- 프라이버시가 필요한 로봇 배포에 직접 적용 가능: 의료, 기업 내부, 교육 환경에서 오디오를 외부로 내보내면 안 되는 경우 이 스택이 실용적인 해답이다.
- vLLM + MTP 조합으로 레이턴시 최소화:
--speculative-config의 Multi-Token Prediction은 음성 파이프라인에서 체감 레이턴시에 직접적인 영향을 준다. vLLM을 쓴다면 활성화를 검토할 것. - 캐스케이드 방식의 유지보수 이점: 모노리식 end-to-end 모델과 달리 캐스케이드는 한 단계만 교체 가능하다. STT 모델이 개선되면 STT만 바꾸면 된다. 전체 파인튜닝 불필요.
- Qwen3-TTS 다국어 지원: 한국어를 포함한 다국어 TTS가 필요하다면 Qwen3-TTS가 현재 가장 실용적인 로컬 옵션 중 하나다.
- speech-to-speech 라이브러리 독립 활용: Reachy Mini 없이도 이 라이브러리로 로컬 음성 에이전트를 구축할 수 있다. WebSocket 서버를 띄우고 어떤 클라이언트든 Realtime API 프로토콜로 연결하면 된다.