Qwen 팀이 Qwen3.7-Max를 공개했다. 이번 글에서 Qwen은 이 모델을 단순한 채팅 모델이 아니라, 코딩·업무 자동화·장기 자율 실행을 수행하는 에이전트 기반 모델로 소개한다. 핵심은 벤치마크 점수 하나가 아니라, 여러 하네스와 도구 환경에서 오래 버티며 문제를 풀 수 있는가에 있다.
Qwen3.7-Max 공식 메인 이미지. Source: Qwen Team
목차
- 핵심 요약
- Qwen3.7-Max가 겨냥한 것은 채팅이 아니라 에이전트다
- 성능표에서 봐야 할 지점
- 환경 스케일링과 크로스 하네스 일반화
- 35시간 자율 커널 최적화가 말하는 것
- 실무자가 볼 핵심 포인트
- 원문 출처
핵심 요약
- Qwen3.7-Max는 Alibaba Cloud Model Studio를 통해 제공되는 Qwen의 최신 proprietary 모델이다.
- 코딩 에이전트, MCP 기반 업무 자동화, 장기 자율 실행, 여러 에이전트 프레임워크 간 일반화를 핵심 메시지로 내세운다.
- Terminal Bench 2.0-Terminus 69.7, SWE-Pro 60.6, MCP-Mark 60.8, GPQA Diamond 92.4 등 여러 영역에서 강한 수치를 제시했다.
- 특히 35시간 자율 커널 최적화에서 1,158회 도구 호출과 10.0배 기하평균 속도 향상을 기록했다는 사례가 눈에 띈다.
Qwen3.7-Max가 겨냥한 것은 채팅이 아니라 에이전트다
원문은 Qwen3.7-Max를 “agent era”를 위한 모델이라고 설명한다. 일반 챗봇처럼 답변만 잘하는 모델이 아니라, 파일을 고치고, 코드를 실행하고, 문서를 정리하고, 여러 도구를 호출하면서 긴 작업을 끝까지 밀고 가는 모델을 목표로 한다는 뜻이다.
Qwen이 강조한 사용처도 명확하다. 프론트엔드 프로토타이핑부터 복잡한 멀티파일 소프트웨어 엔지니어링까지 다루는 코딩 에이전트, MCP 연동을 통한 오피스 자동화, 여러 에이전트가 협업하는 워크플로우, 그리고 수백~수천 단계에 걸친 장기 자율 실행이다. Claude Code, OpenClaw, Qwen Code 같은 서로 다른 하네스에서도 일관된 성능을 보인다는 점도 중요한 주장이다.
성능표에서 봐야 할 지점
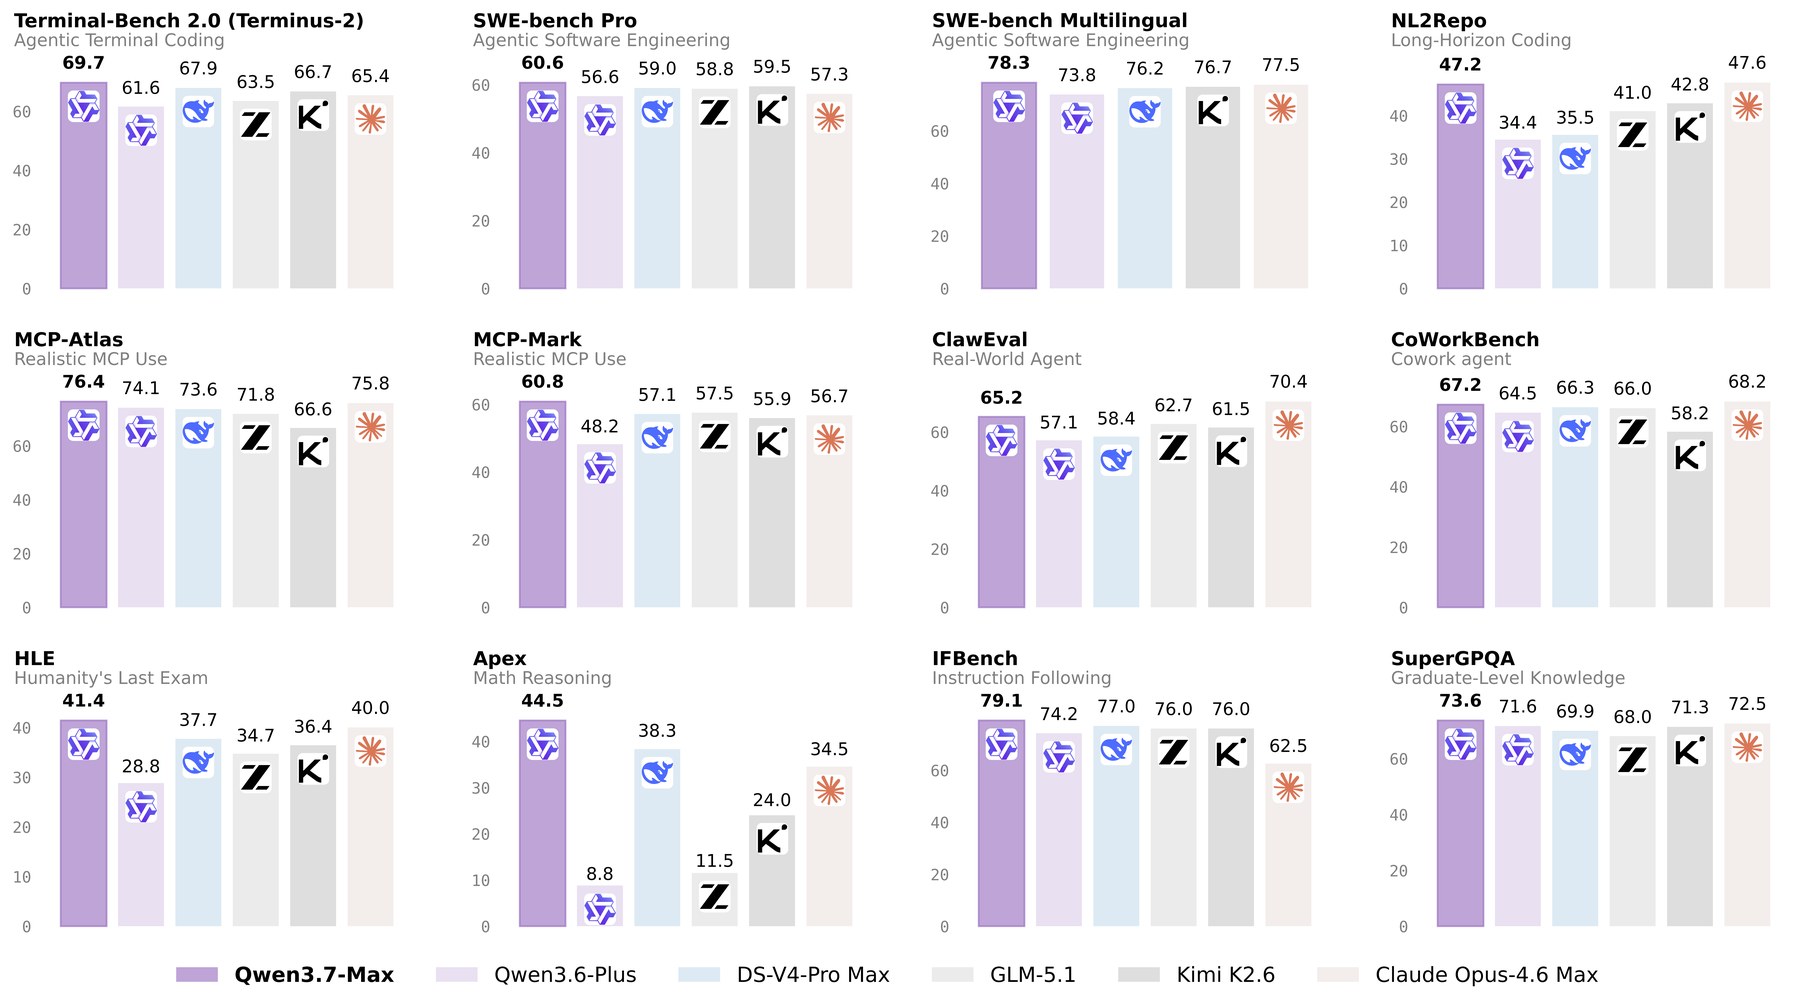
Qwen3.7-Max 성능 비교표. Source: Qwen Team
성능표는 매우 크지만, 실무자가 볼 지점은 몇 가지로 압축된다. 코딩 영역에서는 Terminal Bench 2.0-Terminus 69.7, SWE-Pro 60.6, SWE-Multilingual 78.3, SciCode 53.5를 제시했다. SWE-Verified 80.4는 Opus-4.6 Max 80.8, DS-V4-Pro Max 80.6과 비슷한 수준으로 배치됐다.
일반 에이전트 영역에서는 MCP-Mark 60.8, MCP-Atlas 76.4, Skillsbench 59.2가 강조된다. 오피스 자동화 성격의 SpreadSheetBench-v1에서는 87.0을 기록했다. 추론 영역에서는 GPQA Diamond 92.4, HLE 41.4, HMMT 2026 Feb 97.1, IMOAnswerBench 90.0, Apex 44.5가 제시됐다.
다만 이 숫자를 “모든 환경에서 최고”로 읽으면 곤란하다. 원문 자체도 다양한 벤치마크, 내부 평가, 하네스별 조건을 섞어 제시한다. 중요한 해석은 Qwen3.7-Max가 특정 한 벤치마크에만 맞춘 모델이 아니라, 코딩·도구사용·추론·다국어를 아우르는 에이전트 백본을 목표로 한다는 점이다.
환경 스케일링과 크로스 하네스 일반화
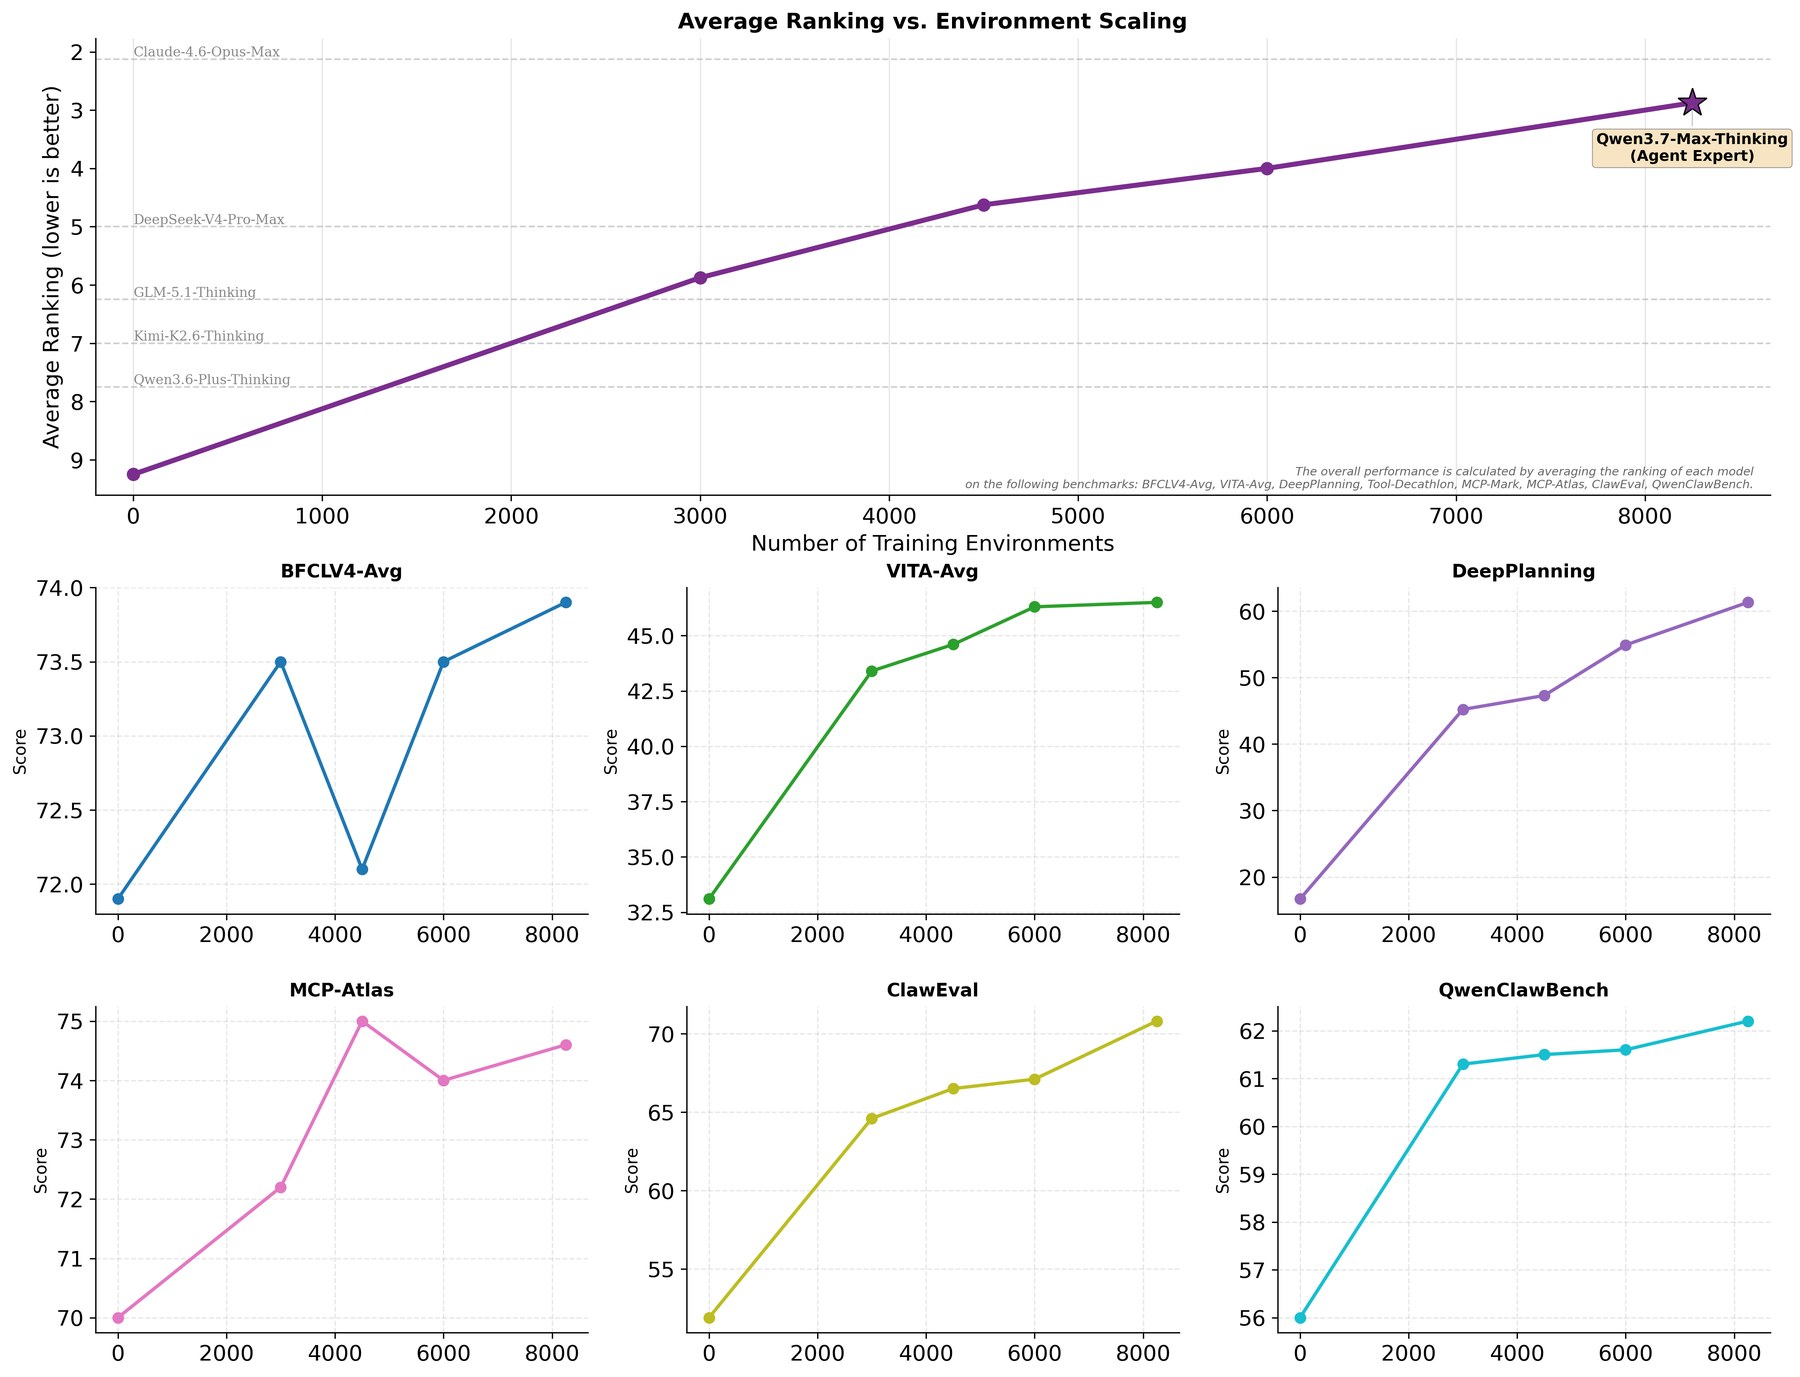
환경 스케일링 결과. Source: Qwen Team
Qwen은 Qwen3.5에서 소개한 환경 스케일링 접근을 Qwen3.7에서도 계속 확장했다고 설명한다. 사전학습 데이터가 다양할수록 언어 모델이 더 잘 일반화하듯, 에이전트도 다양한 훈련 환경을 경험할수록 더 넓은 작업에 일반화한다는 관점이다.
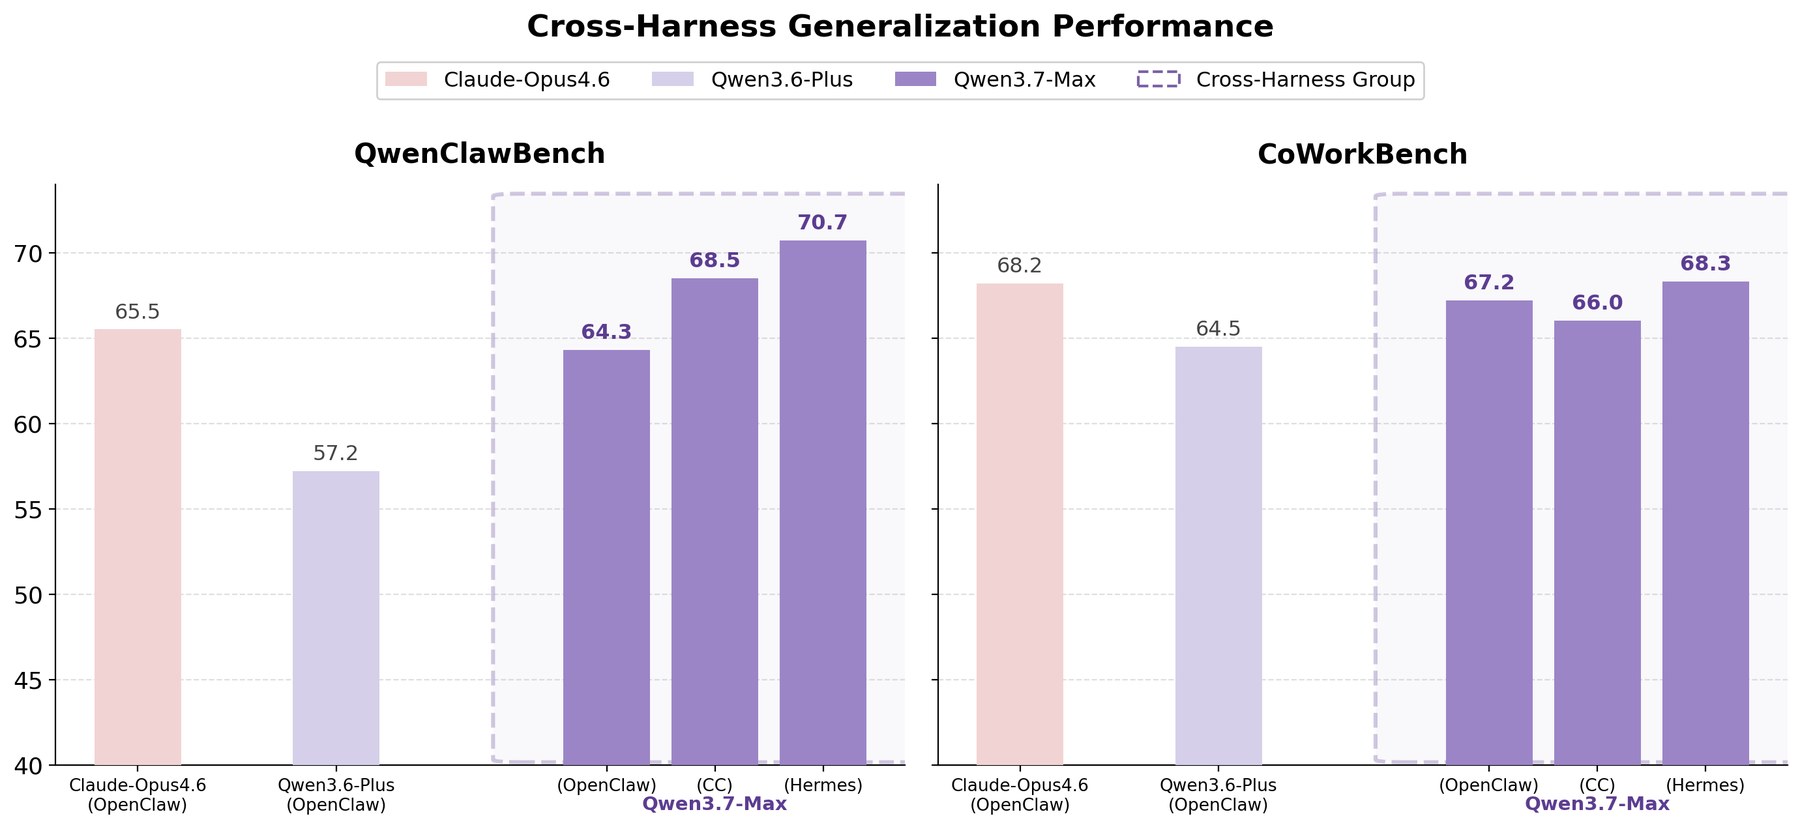
Task·Harness·Verifier 분리 기반 크로스 하네스 일반화 구조. Source: Qwen Team
특히 Rollout 환경을 Task, Harness, Verifier로 분리한 점이 흥미롭다. 같은 작업을 서로 다른 하네스와 검증기 조합으로 반복하면, 모델은 특정 도구의 빈틈을 외우기보다 문제 해결 전략 자체를 배워야 한다. Qwen은 이것이 QwenClawBench와 CoWorkBench에서 안정적인 크로스 하네스 성능으로 이어졌다고 주장한다.
35시간 자율 커널 최적화가 말하는 것

35시간 자율 커널 최적화 궤적. Source: Qwen Team
가장 인상적인 사례는 SGLang의 Extend Attention 커널 최적화다. Qwen3.7-Max는 T-Head ZW-M890 PPU 환경에서 사전 프로파일링 데이터나 하드웨어 문서 없이, 기존 구현과 평가 스크립트만 가지고 약 35시간 동안 자율 실행을 이어갔다. 그 과정에서 432회 커널 평가, 1,158회 도구 호출을 수행했고, 최종적으로 Triton reference 대비 10.0배 기하평균 속도 향상을 얻었다고 한다.
이 사례가 중요한 이유는 단순히 “커널을 잘 짰다”가 아니다. 장시간 동안 컴파일 오류를 고치고, 정합성 버그를 잡고, 런타임 프로파일링으로 병목을 찾고, 구조를 여러 번 바꿨다는 점이다. 에이전트 모델의 품질은 첫 답변보다 실패 후 복구, 긴 맥락 유지, 반복 개선 능력에서 드러난다.
실무자가 볼 핵심 포인트
Qwen3.7-Max는 “좋은 LLM”보다 “에이전트 시스템의 백본”으로 평가하는 편이 맞다. 코딩 보조, 문서 자동화, MCP 기반 업무 흐름, 장기 실행 작업을 만들고 있다면 벤치마크보다 자신의 하네스에서의 안정성을 먼저 봐야 한다.
또 하나의 포인트는 사고 내용 보존 기능이다. 원문은 agentic task에서 이전 턴의 thinking content를 보존하는 preserve_thinking 기능을 권장한다. 장기 작업에서는 모델 자체 성능만큼이나, 이전 추론과 도구 사용 맥락을 어떻게 이어갈지가 중요하다는 의미다.
물론 Qwen3.7-Max는 proprietary 모델이고, Qwen3.6-Plus 같은 이전 세대와의 비교 및 원문 수치에는 내부 벤치마크도 포함된다. 따라서 실제 도입 전에는 같은 프롬프트, 같은 도구 권한, 같은 시간 제한에서 Claude Code, OpenClaw, Qwen Code 등 자신이 쓰는 하네스별 비교가 필요하다. 그래도 이번 발표는 분명한 방향을 보여준다. LLM 경쟁의 중심은 이제 “답변 품질”에서 “긴 작업을 끝까지 수행하는 에이전트 능력”으로 이동하고 있다.