개요
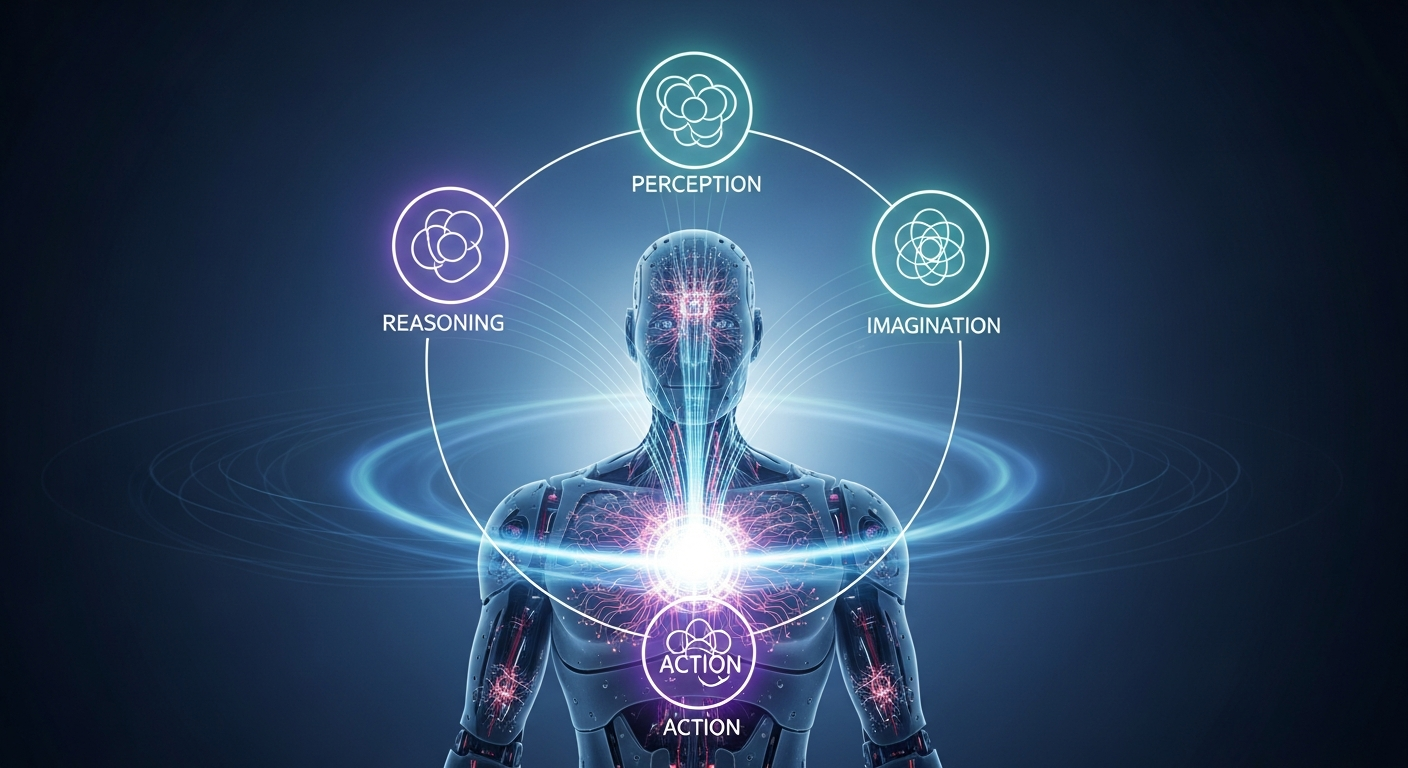
로봇 AI의 오랜 가정은 ‘전문 모듈을 조합하라’였다. 인식 모듈, 추론 엔진, 행동 생성기를 따로 만들어 파이프라인으로 연결한다. Pelican-Unified 1.0은 이 가정을 버렸다. 이해, 추론, 상상, 행동 — 네 가지 능력을 하나의 학습 루프에 묶고, 하나의 체크포인트로 서비스한다. 그리고 전문 모델에 뒤지지 않는 성능을 냈다.
핵심 요약
- 단일 통합 아키텍처: 분리된 전문가 시스템 없이 이해·추론·상상·행동 4가지를 하나의 모델로 처리
- Qwen3-VL 4B 백본: 장면·명령·행동 이력을 공유 잠재 표현(z)으로 압축하고, 체인-오브-쏘트 추론을 생성
- Unified Future Generator(UFG): 확산 트랜스포머가 미래 영상과 행동 시퀀스를 동시에 생성 — 상상이 행동을 형성하고 행동이 상상을 제약
- 실전 성능: VLM 8개 벤치마크 평균 64.7, RoboTwin 93.5%, WorldArena 1위(EWM 66.03)
- 제로샷 전이: 훈련에 없던 조합 태스크와 다른 로봇 플랫폼에서도 동작 확인
왜 분리된 모듈이 문제인가
기존 구현체 AI 파이프라인은 세 층으로 쌓인다. 시각-언어 모델이 장면을 이해하고, 별도 추론기가 계획을 짜고, 행동 생성 모듈이 실행한다. 이 구조의 약점은 경계면(interface)에서 생긴다. 이해 단계에서 압축된 정보가 추론으로 넘어가고, 추론 결과가 행동으로 변환될 때마다 정보가 손실된다. 더 근본적으로는 각 모듈이 독립적으로 최적화되어 서로를 조건으로 개선되지 못한다.
이 구조에는 또 다른 문제가 있다. 모듈 경계마다 API 계약이 생기고, 한 모듈의 실패가 다음 모듈로 전파된다. 장기적으로 시스템을 확장하려면 각 모듈을 따로 유지해야 한다. 단일 공유 표현 없이 개별 모듈을 쌓을수록 실패 지점도 늘어난다.
Pelican-Unified는 다른 원칙을 세운다. “이해, 추론, 상상, 행동은 내부 표현을 공유하고, 서로를 조건으로 삼으며, 공통 학습 과정에서 함께 진화해야 한다.”
아키텍처: 공유 잠재 표현 z가 전부를 연결한다
통합 인코더
Qwen3-VL 4B가 백본이다. 카메라 영상, 행동 이력, 언어 명령을 받아 공유 의미 공간으로 매핑한다. 여기서 태스크 지향 체인-오브-쏘트 추론이 생성된다. 인코더의 최종 히든 상태가 밀집 잠재 변수 z로 투영된다. z가 이후 상상과 행동 생성 전체를 조건으로 삼는다.
Unified Future Generator(UFG)
z를 조건으로 받는 확산 트랜스포머다. 미래 영상 토큰과 행동 토큰을 같은 노이즈 제거 과정에서 동시에 생성한다. 두 모달리티는 노이즈 제거 중에 서로 상호작용하면서 z로부터 크로스-어텐션을 받는다. 영상과 행동이 별개로 생성되는 게 아니라, 하나의 공동 확산 과정에서 나온다.
학습 목적함수도 세 가지 손실이 z를 공유한다. 언어 추론 손실(자기회귀), 영상 예측 손실(플로우 매칭), 행동 예측 손실(SmoothL1)이 모두 z를 통해 역전파한다.
실험 결과
VLM 이해 벤치마크
8개 벤치마크 평균 64.7. 베이스라인인 Qwen3-VL-4B-Instruct(58.2)보다 높다. 특히 구현체 태스크에서 격차가 크다. Where2Place에서 +28.2, PhyX에서 +20.6. 통합 학습이 오히려 이해력도 끌어올렸다.
RoboTwin 행동 벤치마크
50개 태스크 평균 성공률 93.5%. 클린 조건 93.6%, 랜덤화 조건 93.3%로 조건 변화에 둔감하다. 50개 태스크 중 31개에서 95% 이상 성공률을 기록했다. 대부분의 전문 VLA 모델을 상회하는 수치다.
WorldArena 상상력 벤치마크
EWM 스코어 66.03으로 1위. 3D 정확도 98.13, 모션 품질 62.69 모두 1위. 인간 평가에서도 전체 평균 1.76으로 최고점. 제어 가능성은 만점인 2.00. 모델이 시각적으로 그럴듯한 영상이 아니라 태스크와 물리적으로 정합한 미래를 예측했다는 결과다.
실제 로봇 검증
훈련 중 RJ45 연결과 방수 처리를 각각 따로 배운 모델이, 두 동작을 조합한 미훈련 태스크를 완수했다. Tienkung 휴머노이드 플랫폼에 태스크당 50개 시퀀스만으로 제로샷 전이도 확인했다. 단일 체크포인트가 다른 로봇 바디에 적은 예시만으로도 적응한다는 점이 실용성 측면에서 핵심이다. 플랫폼마다 대규모 데이터를 새로 수집해야 하는 기존 방식과 비교하면 배포 비용 차이가 크다.
실무자가 볼 핵심 포인트
- 분리된 모듈 대신 공유 표현이 핵심 — 인식·추론·생성 경계를 없애면 각 능력이 서로를 강화한다. 모듈 경계에서 발생하는 정보 손실과 최적화 단절이 사라진다
- 상상이 행동을 제약한다 — UFG가 미래 영상과 행동을 동시에 생성하기 때문에 물리적으로 불가능한 행동이 필터링된다. 행동 예측과 세계 모델이 같은 과정에서 나온다
- 4B 파라미터로 충분하다 — Qwen3-VL 4B 백본이 베이스다. 전문 모델을 4개 조합하는 것보다 단일 4B 모델이 관리 비용은 낮고 성능은 동등하다
- 제로샷 조합이 가능해진다 — 원자 태스크를 충분히 학습하면 미훈련 조합에 일반화한다. 현장에서 예측하지 못한 태스크 시퀀스가 나와도 재훈련 없이 대응된다
- 로봇 플랫폼 독립성 — 50개 예시만으로 다른 로봇 바디에 전이된다. 플랫폼별 데이터 수집 비용이 대폭 낮아진다