개요
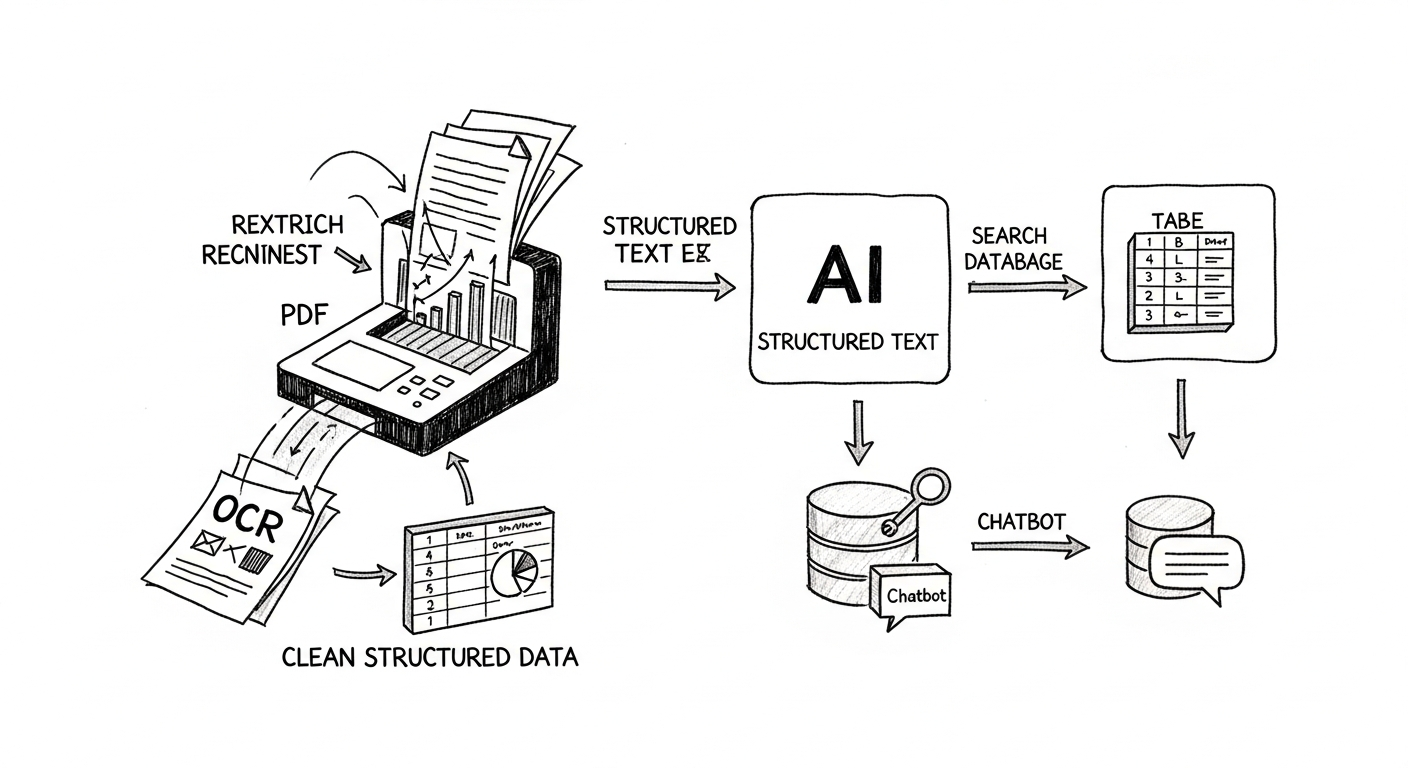
PaddleOCR 3.5가 Hugging Face Transformers를 추론 백엔드로 공식 지원한다. engine="transformers" 파라미터 하나로 기존 PyTorch/Transformers 스택에 OCR과 문서 파싱 기능을 통합할 수 있다. PDF, 스캔 문서, 테이블, 차트 등 복잡한 레이아웃도 처리 가능하다. RAG 파이프라인이나 Document AI 워크플로우에서 문서 수집 품질을 높이려는 팀에게 실용적인 업데이트다.
핵심 요약
- PaddleOCR 3.5: Transformers를 세 번째 추론 백엔드로 추가
- 단일 파라미터 전환:
engine="transformers"로 백엔드 변경 - 기존 모델 유지: PP-OCRv5, PaddleOCR-VL 1.5 계속 지원
- 통합 대상: RAG, Document AI, 검색, 분석 애플리케이션
- 성능 주의: 최대 처리량이 필요하면
paddle_static백엔드 권장 - 요구 버전:
transformers>=5.4.0
본문
세 개의 레이어로 구성된 구조
PaddleOCR 3.5의 아키텍처는 세 계층으로 나뉜다.
- 응용 계층: OCR 결과를 실제로 쓰는 곳. RAG, Document AI, 에이전트 등
- 모델 계층: OCR/문서 파싱 기능. PP-OCRv5, PaddleOCR-VL 1.5
- 추론 백엔드 계층: 실제 연산이 돌아가는 엔진. Paddle static, Paddle dynamic, 그리고 이번에 추가된 Transformers
기존에는 Paddle 계열 백엔드만 지원했다. 3.5부터 Transformers가 세 번째 옵션으로 들어왔다. 코드 변경 없이 engine 파라미터 하나로 전환할 수 있다.
왜 Transformers 백엔드인가
Transformers를 메인 스택으로 쓰는 팀은 지금까지 PaddleOCR를 도입하려면 두 가지 런타임을 관리해야 했다. Paddle 환경이 별도로 필요하기 때문이다. 이번 업데이트로 그 장벽이 낮아졌다.
공식 권장 사용 시나리오는 이렇다.
Transformers 백엔드가 맞는 경우:
- Transformers 기반 개발 스택
- RAG, Document AI, 검색, 분석 애플리케이션
- Hugging Face Hub 모델 관리 필요
- PyTorch 서비스와의 통합
paddle_static 백엔드가 맞는 경우:
- OCR/문서 파싱 처리량 최대화가 목표
추론 속도보다 생태계 통합이 우선인 팀에게 적합한 선택지다.
설치와 사용법
설치는 두 단계다.
# PyTorch + CUDA
python -m pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu126

# PaddleOCR + PaddleX + Transformers
python -m pip install "paddleocr==3.5.0" "paddlex==3.5.2" "transformers>=5.4.0"
커맨드라인에서 쓰는 방법:
paddleocr ocr \
  -i /path/to/document.png \
  --device gpu:0 \
  --engine transformers
Python API:
from paddleocr import PaddleOCR

pipeline = PaddleOCR(
    device="gpu:0",
    engine="transformers",
    engine_config={
        "dtype": "float32",
    },
)

results = pipeline.predict("document.png")
for result in results:
    print(result)
engine_config로 dtype, device_type, attn_implementation 등 백엔드 세부 옵션을 제어할 수 있다. bfloat16, SDPA 어텐션도 지원한다.
RAG 파이프라인에서의 활용
PaddleOCR 3.5 Transformers 백엔드가 실질적으로 빛나는 곳은 RAG 파이프라인이다. PDF나 스캔 문서를 LLM에 넣을 때 텍스트 추출 품질이 검색 정확도에 직결된다.
기존 방식은 단순 PDF 텍스트 추출이라 테이블, 차트, 복잡한 레이아웃에서 정보가 유실되는 경우가 많았다. PaddleOCR의 문서 파싱 기능은 레이아웃을 인식하고 구조화된 텍스트를 반환한다.
Transformers 백엔드 추가로 LangChain, LlamaIndex, Haystack 같은 Transformers 기반 RAG 프레임워크와의 연동이 한결 자연스러워졌다.
실무자가 볼 핵심 포인트
- RAG 문서 수집 품질 점검: 현재 PDF → 텍스트 추출 파이프라인이 테이블과 복잡한 레이아웃을 제대로 처리하는지 확인하라. 놓치는 정보가 검색 품질을 낮춘다.
- 백엔드 선택 기준 명확히: 처리량이 중요하면 paddle_static, 생태계 통합이 중요하면 transformers. 두 목표를 동시에 최적화하려고 하지 않아도 된다.
- transformers>=5.4.0 필수 확인: 기존 환경에 transformers가 낮은 버전으로 고정돼 있다면 업그레이드가 필요하다. 버전 충돌 여부를 미리 점검할 것.
- GPU 메모리 고려: bfloat16 또는 float16으로
dtype을 설정하면 메모리를 아낄 수 있다. 프로덕션 환경에서는 메모리 프로파일링 후 결정하는 것이 좋다. - HuggingFace Spaces 데모 활용: 도입 전 공식 데모(paddleocr-3.5-transformers-demo)에서 자신의 문서 유형을 먼저 테스트해볼 수 있다.