GPU 위에 LLM을 얹어 텍스트를 다루는 흐름이 일반화된 지금, 다음 자리는 영상입니다. CCTV·드론·산업 카메라·창고 자동화·로보틱스가 만들어내는 영상은 텍스트보다 자릿수 큰 데이터인데, 거기서 “지난 30분 동안 무슨 일이 있었지?”, “이 알람은 진짜인가?” 같은 자연어 질문에 답하는 시스템은 아직 표준이 없습니다. NVIDIA가 이 자리에 답하려고 내놓은 레퍼런스 아키텍처가 Video Search and Summarization (VSS) 블루프린트입니다.
핵심 요약
- VSS는 NVIDIA AI Blueprint 중 하나로, 자연어로 영상을 검색·요약·Q&A하는 비전 에이전트를 위한 레퍼런스 아키텍처입니다.
- 3개 처리 레이어: (1) 실시간 영상 인텔리전스 — feature·embedding 추출 후 메시지 브로커 게시 / (2) 다운스트림 분석 — 메타데이터를 trajectory·incident·검증 알람으로 가공 / (3) 에이전트·오프라인 처리 — 검색·Q&A·요약·클립 회수, 모두 MCP 도구로 노출.
- 5개 에이전트 워크플로 제공: Q&A + Report 생성, Alert Verification(VLM이 false positive 거르기), Real-Time Alerts, Video Search(alpha), Long Video Summarization.
- 핵심 NIM 모델: 비전 추론용 Cosmos-Reason2-8B, 텍스트 추론용 NVIDIA Nemotron-Nano-9B-v2.
- 배포는 두 갈래 — Brev launchable(2×RTX PRO 6000 SE AWS)과 자체 하드웨어 Docker Compose. DGX-SPARK, IGX/AGX-THOR, x86 Ubuntu 모두 지원.
VSS가 풀려는 문제 — 영상 데이터를 자연어로 다루기
VSS의 출발 문제 정의는 단순합니다. “대량의 저장 영상과 실시간 스트림을 자연어로 직접 다룰 수 있는 에이전트를 만들고 싶다.” 활용 예시는 익숙합니다.
- 스마트 공간 모니터링 — “지난 1시간 안에 출입한 사람 수와 비정상 패턴은?”
- 창고 자동화 — “지게차가 정해진 통로를 벗어난 구간을 모두 찾아줘”
- SOP 검증 — “작업자 A가 절차 3단계를 빠뜨린 클립만 골라서 묶어줘”
문제의 결은 같습니다 — 영상은 그대로는 시간 동기화된 픽셀 시퀀스일 뿐이고, 사람의 질문은 자연어이고 의도가 추상적입니다. 그 사이를 채울 표준화된 파이프라인이 산업 전반에 부족했고, VSS는 그 자리를 NIM 마이크로서비스 + VLM + LLM의 조합으로 메우려고 합니다.
3개 처리 레이어
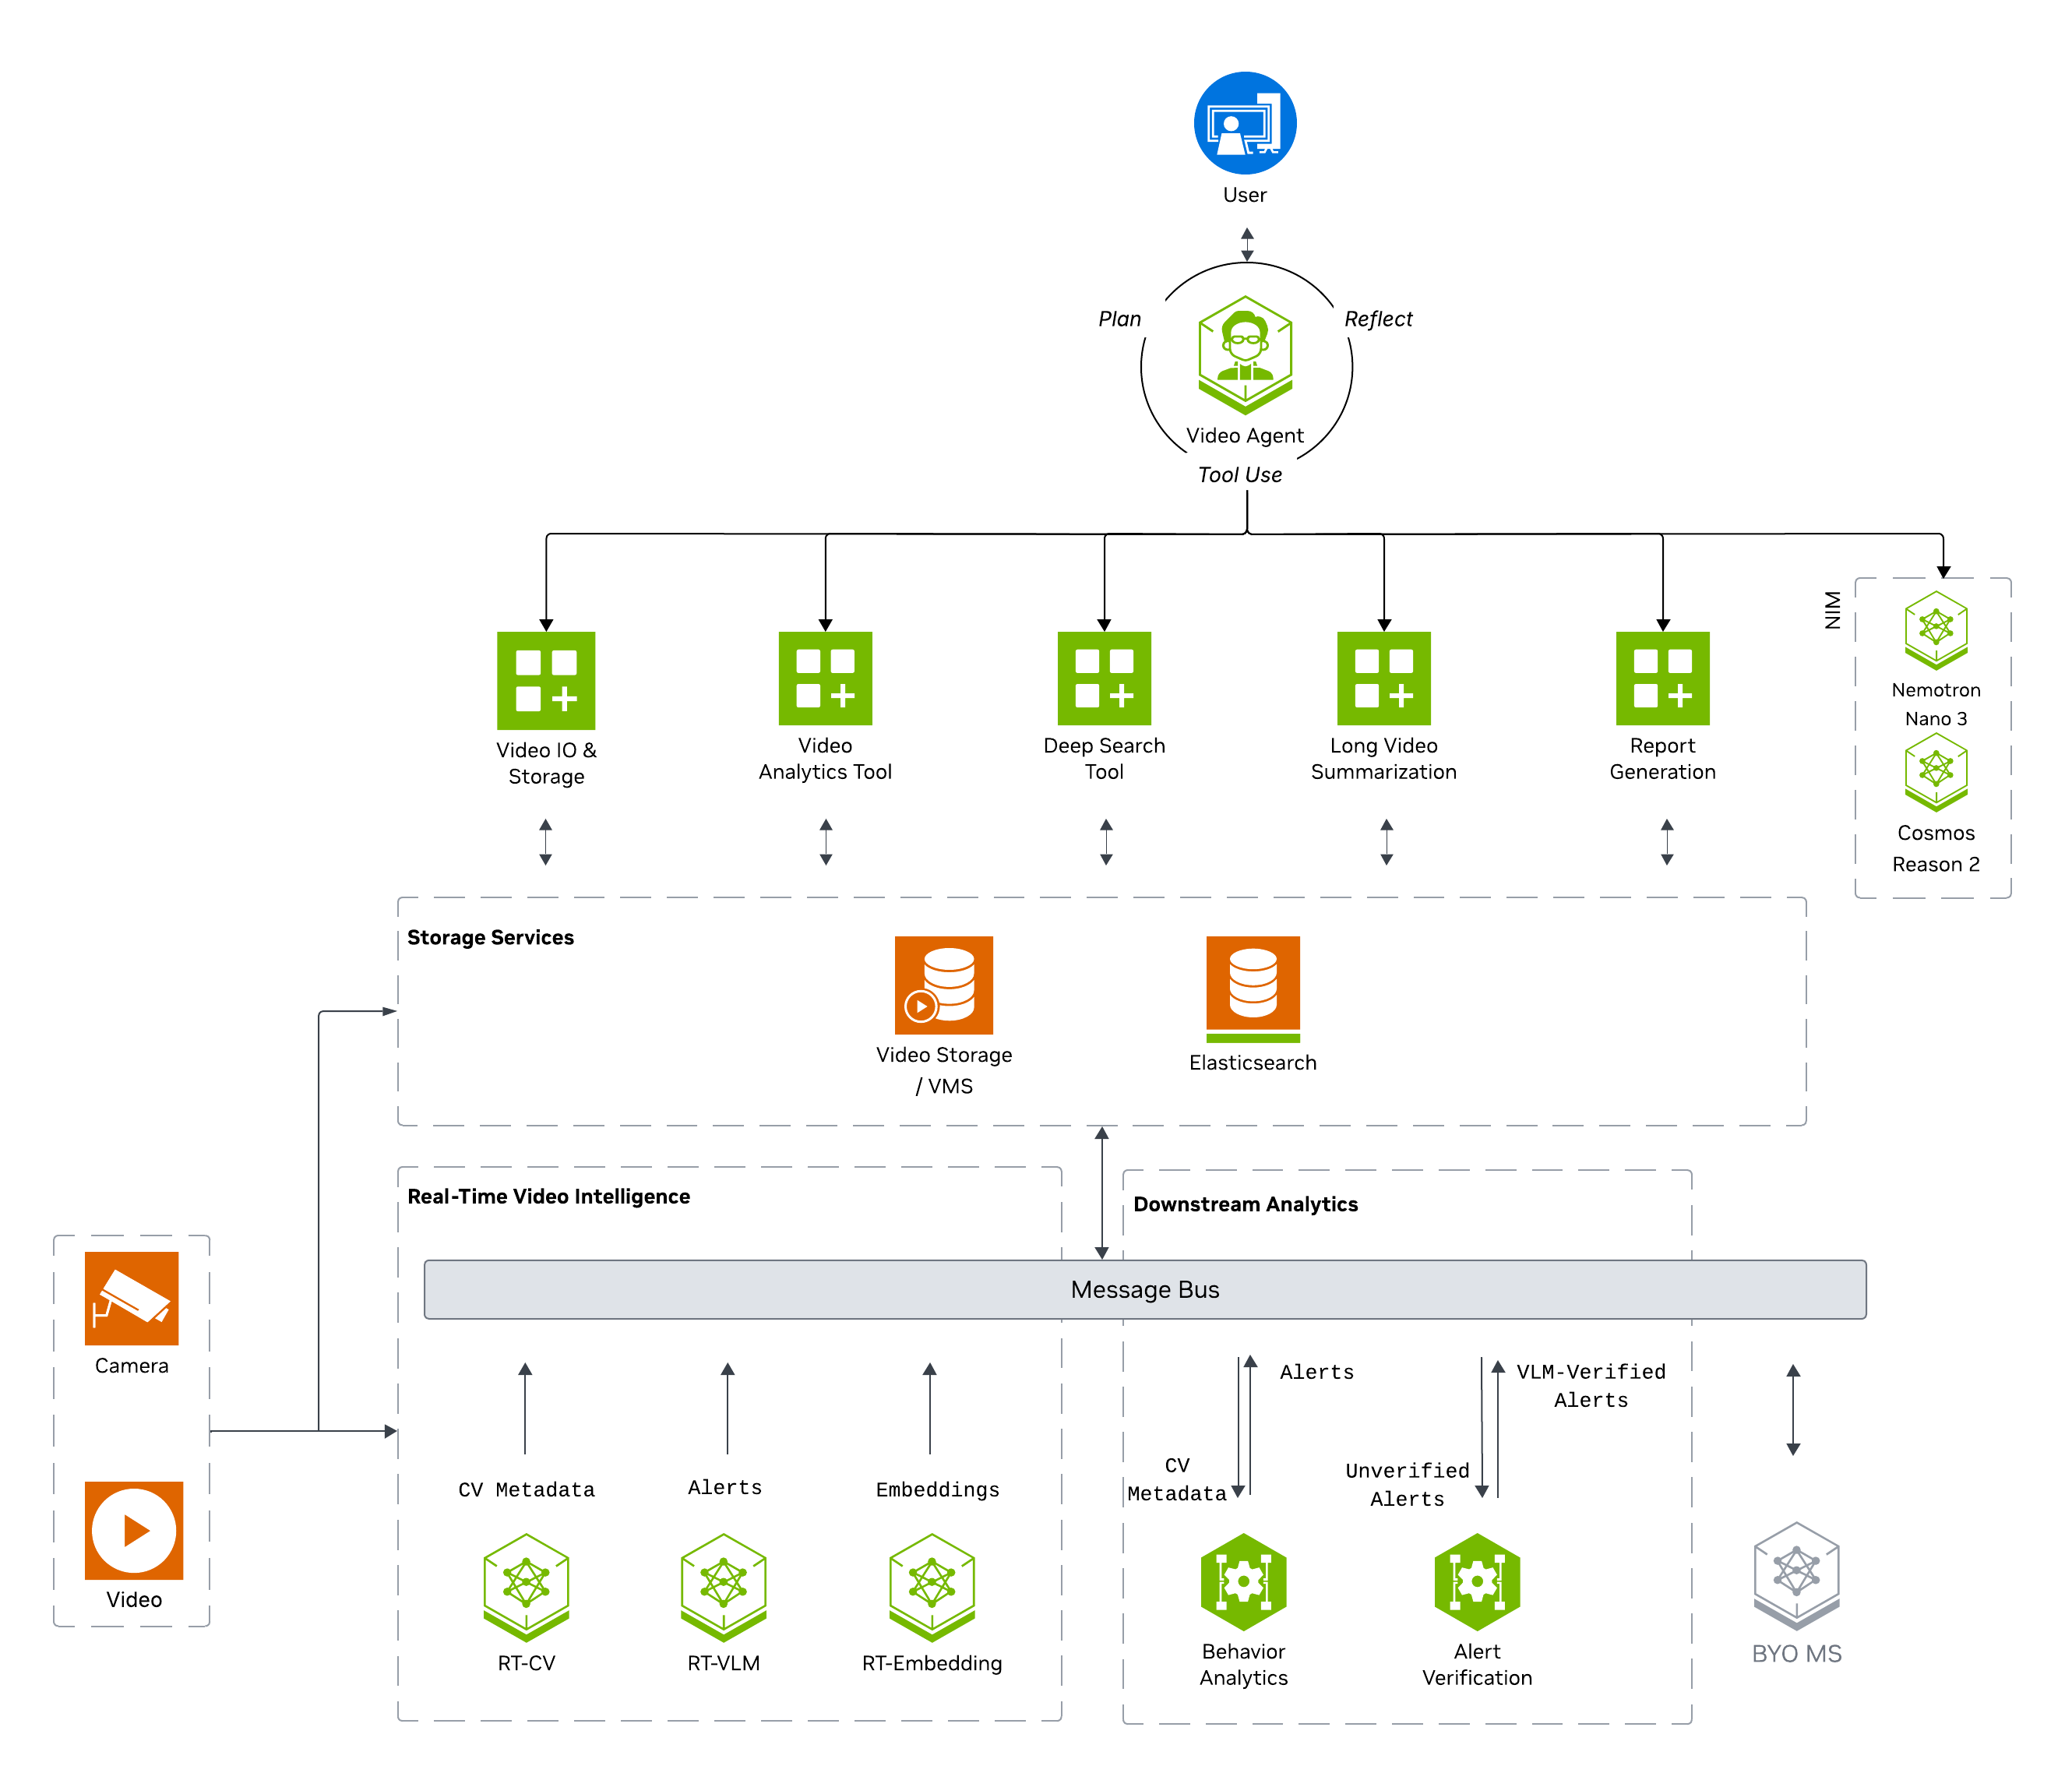
VSS는 영상 처리를 다음 3개 레이어로 나눕니다.
- 실시간 영상 인텔리전스(Real-Time Video Intelligence). 영상 스트림에서 feature, semantic embedding, contextual understanding을 실시간으로 추출하고 결과를 message broker에 게시합니다. 그 위에 다운스트림 분석이나 에이전트 워크플로가 구독해서 동작하는 구조입니다.
- 다운스트림 분석(Downstream Analytics). 실시간 인텔리전스가 만들어내는 raw detection·embedding을 trajectory(경로), incident(사건), verified alert(검증된 경보)로 가공합니다. 단순 객체 검출 결과를 사람이 의미 있는 신호로 정제하는 단계입니다.
- 에이전트·오프라인 처리(Agent + Offline Processing). 최상위 에이전트가 MCP(Model Context Protocol) 위에서 영상 분석 데이터·incident 기록·VLM 도구를 하나의 통일된 인터페이스로 호출합니다. 비디오 이해(VLM), 의미 기반 영상 검색(embedding), 긴 영상 요약, 클립 스냅샷 회수 같은 도구가 여기 묶입니다.
이 3-레이어가 핵심입니다. 같은 영상 데이터를 실시간(스트림 그대로 흐르면서 알람), 분석(메타데이터 정제), 에이전트(자연어 질문) 세 시점에서 동시에 다룰 수 있게 분리한 것이 VSS의 설계 핵심입니다.
5개 에이전트 워크플로
NVIDIA는 같은 컴포넌트 조합으로 다음 5개 워크플로를 reference로 제공합니다.
| 워크플로 | 요약 |
|---|---|
| Q&A + Report 생성 (Quickstart) | 짧은 영상 클립에서 retrieval + VLM 기반 Q&A + 리포트 생성 |
| Alert Verification | 객체 검출/추적·행동 분석으로 1차 알람을 생성한 뒤, VLM이 다시 검증해 false positive를 걸러냄 |
| Real-Time Alerts | VLM을 영상 스트림에 연속 적용해 이상 탐지 |
| Video Search (alpha) | 영상 embedding 위에서 자연어 검색 — “빨간 셔츠 입은 사람” 같은 쿼리로 비디오 아카이브 검색 |
| Long Video Summarization | 긴 영상을 청크로 자르고 dense caption을 집계해 압축 요약 |
워크플로 5개가 보여주는 핵심은 VLM 한 모델로 모든 시나리오를 묶지 않았다는 점입니다. 각 워크플로가 다른 부담을 가집니다 — Alert Verification은 정확도, Real-Time Alerts는 지연, Long Video Summarization은 토큰 효율. 그 부담에 맞춰 컴포넌트(검출기·VLM·LLM·embedder)를 다르게 조합할 수 있도록 reference만 제공하고 실제 조합은 사용자가 고르게 한 구조입니다.
사용된 NIM 모델 — Cosmos-Reason2-8B + Nemotron-Nano-9B-v2
VSS의 두 축 모델은 모두 NVIDIA 자체 모델입니다.
- Cosmos-Reason2-8B — 비전 추론 특화 VLM. 영상 프레임·클립을 보고 자연어로 추론·서술하는 역할.
- NVIDIA Nemotron-Nano-9B-v2 — 텍스트 LLM. VLM이 만든 캡션·메타데이터를 받아 사용자 질문에 답하고, 에이전트 도구 호출을 계획.
8B + 9B 조합이 의미하는 바가 있습니다. 거대 frontier 모델(72B·405B)이 아니라 edge·on-prem 배포가 가능한 중급 크기에서 작동하는 reference라는 점입니다. NIM 마이크로서비스라는 형태도 같은 흐름 — 모델을 라이브러리가 아니라 컨테이너 단위로 띄워서 운영 인프라 위에 얹는 패턴.
배포 옵션과 하드웨어 요구사항
배포는 두 가지 길이 있습니다.
- Brev Launchable — AWS의 2×RTX PRO 6000 SE 인스턴스에 한 번에 띄우는 노트북 기반 deployment. “내 영상으로 빨리 돌려보고 싶다"에 적합.
- 자체 Docker Compose — x86 Ubuntu(22.04/24.04), DGX-SPARK(DGX OS 7.4), IGX-THOR/AGX-THOR(Jetson Linux BSP) 위에 직접 배포. NVIDIA Driver 580.x, Container Toolkit 1.17.8+, Docker 27.2+, NGC CLI 4.10+ 등 사양 명시.
이 두 옵션이 VSS를 흥미롭게 만듭니다. 클라우드 SaaS가 아니라 NIM 컨테이너 + Docker Compose 조합이라 자체 인프라(특히 DGX-SPARK, IGX/AGX-THOR 같은 NVIDIA의 엣지·산업용 보드)에 그대로 얹을 수 있습니다. 영상 데이터가 곧 보안·프라이버시 자산인 산업·물류·공공 시나리오에서 이 분기점이 결정적입니다.
또 한 가지 — Repository 안에 skills/ 디렉토리가 agentskills.io 표준을 따르는 SKILL.md 묶음으로 구성되어 있습니다. 검색·요약·알람·VIOS·RT-VLM·LVS 등을 각자 self-contained skill로 만들어 둔 것입니다. agent 생태계가 표준 skill 인터페이스를 모으는 흐름과 정확히 정렬됩니다.
실무자가 볼 핵심 포인트
- 영상 LLM 인프라의 reference 표준이 잡혔다. 그동안 영상 검색·요약 시스템은 각 회사가 자체 조합으로 짜왔습니다. VSS가 NIM 마이크로서비스 + VLM/LLM + MCP 도구 인터페이스라는 reference를 제시한 만큼, 자체 영상 에이전트를 만들 때 이 3-레이어 분리를 그대로 빌릴 가치가 있습니다.
- MCP가 영상 분석에도 들어왔다. Cursor·Claude Code 같은 코드 에이전트에서 시작된 MCP가 영상 분야의 도구 인터페이스로도 등장했습니다. “에이전트 ↔ 영상 도구"가 표준 프로토콜로 묶이는 신호. 자체 영상 도구를 만든다면 MCP 서버 인터페이스 노출을 우선 고려해야 합니다.
- 모델 크기는 8B/9B가 reference 기준점. 거대 모델을 가정한 reference가 아니라 8B VLM + 9B LLM이라는 실제 edge·on-prem에서 돌릴 수 있는 크기. 자체 운영 비용 모델을 짤 때 같은 크기대로 시작해도 충분하다는 신호.
- Alert Verification 패턴이 가장 즉시 가져갈 만하다. 1차 객체 검출이 false positive 많은 산업에서 “VLM이 다시 보고 검증"하는 2단 구조는 그대로 가져가 적용 가능. 자체 모니터링 시스템에 같은 단계만 얹어도 알람 노이즈를 큰 폭으로 줄일 수 있습니다.
- 자체 인프라에 영상 LLM 운영이 가능해진다. Brev launchable + Docker Compose 두 옵션 + DGX-SPARK·IGX/AGX-THOR 지원이라 클라우드에 영상을 못 올리는 산업·공공 분야에서 본격 채택 가능 시점이 다가왔습니다. 보안·프라이버시·인터넷 단절 환경에서도 영상 에이전트가 돌아간다는 의미.
- agentskills.io 표준 채택도 신호. NVIDIA 자체 reference repository가 agentskills 형식을 따르는 것은 그 표준이 산업 채택 단계로 들어왔다는 것. 자체 도구를 만들 때 SKILL.md 명세를 따르면 같은 에이전트 생태계와 호환됩니다.
원문: NVIDIA AI Blueprint — Video Search and Summarization (VSS), GitHub · 공식 문서