개요
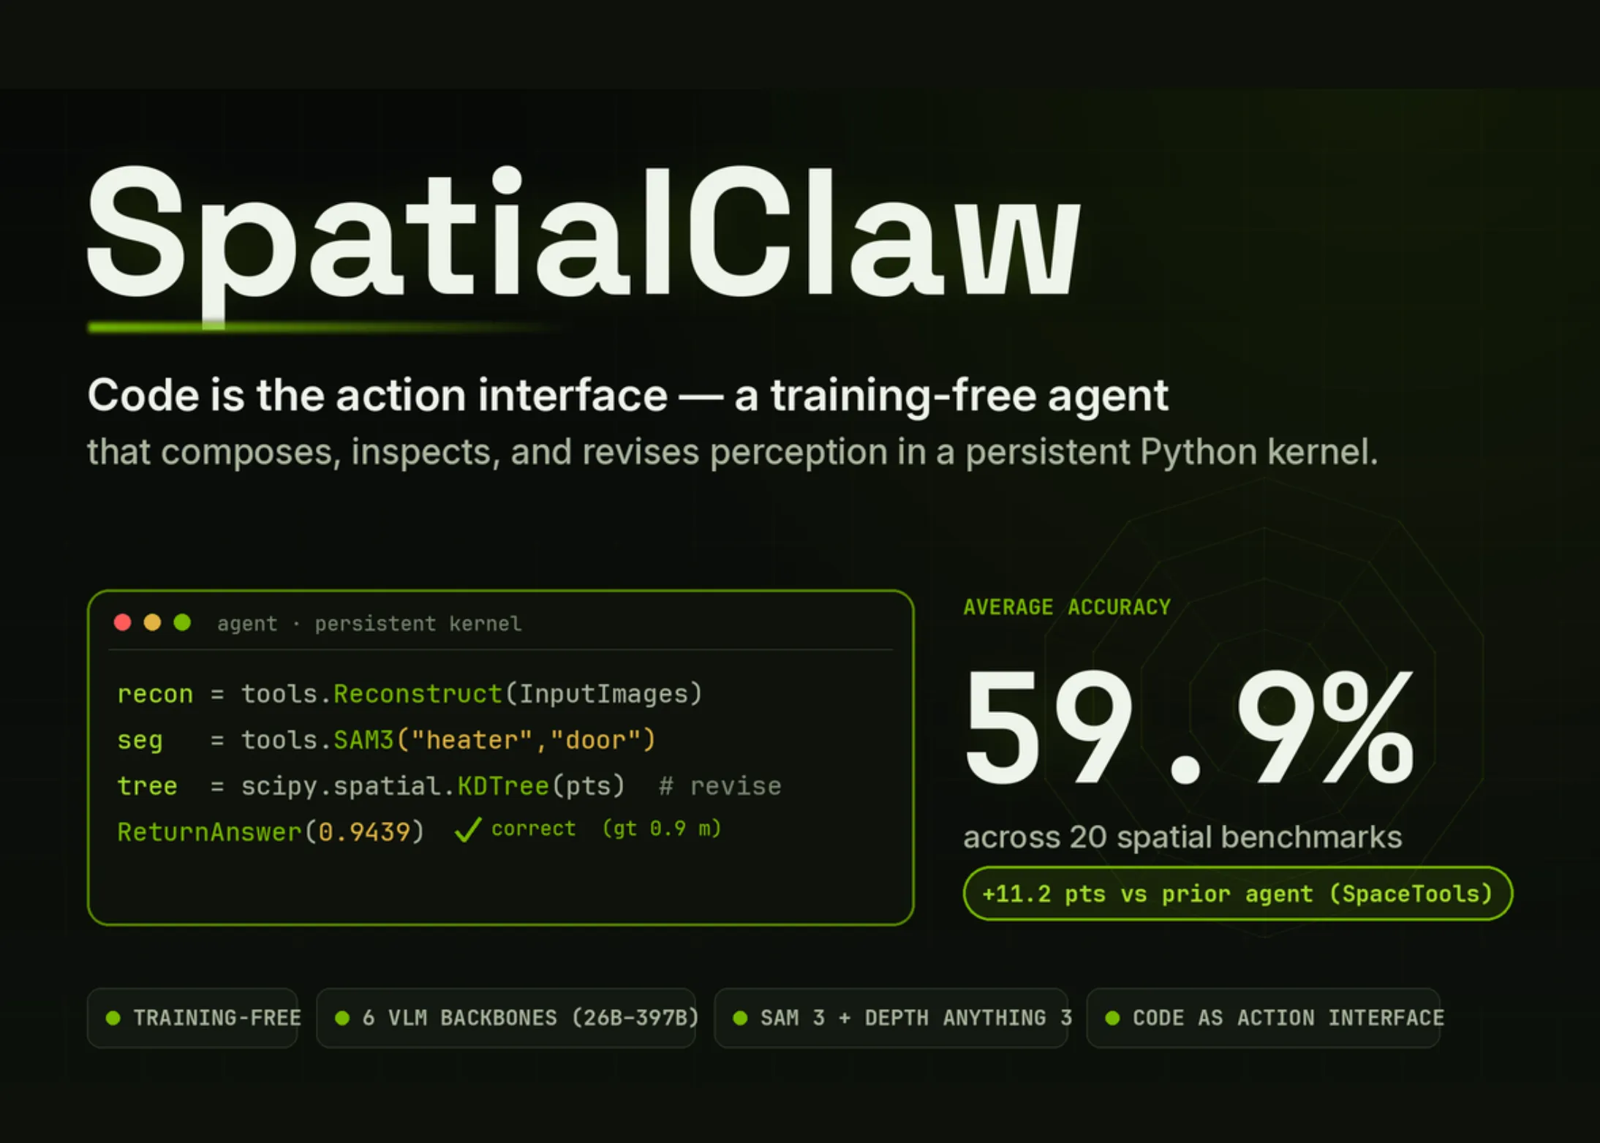
엔비디아 리서치가 SpatialClaw를 공개했습니다. 비전·언어 모델이 약한 공간 문제를 풀기 위해 모델을 다시 학습시키는 대신, 모델이 도구를 호출하는 방식을 통째로 바꾼 에이전트입니다. JSON 스키마로 짜인 툴콜 대신 파이썬 코드를 액션으로 쓰게 했더니, 같은 백본으로도 평균 정확도가 눈에 띄게 올라갔습니다.
핵심 요약
- SpatialClaw는 추가 학습 없이 동작하는 공간 추론 에이전트입니다. 백본을 바꿔도 같은 프롬프트·도구·하이퍼파라미터가 그대로 쓰입니다.
- 액션 인터페이스는 파이썬 코드입니다. 모델이 셀을 한 번에 한 칸씩 실행하고, 결과를 들여다본 뒤 다음 코드를 다시 씁니다.
- 인지 도구로는 Depth Anything 3 기반
Reconstruct와 SAM 3 기반SAM3가 들어가 있고, NumPy·SciPy를 그대로 끼워 쓸 수 있습니다. - Gemma4-31B로 측정한 20개 벤치마크 평균 정확도는 59.9%로, 같은 백본의 JSON 툴콜 방식보다 3.2%포인트 높습니다.
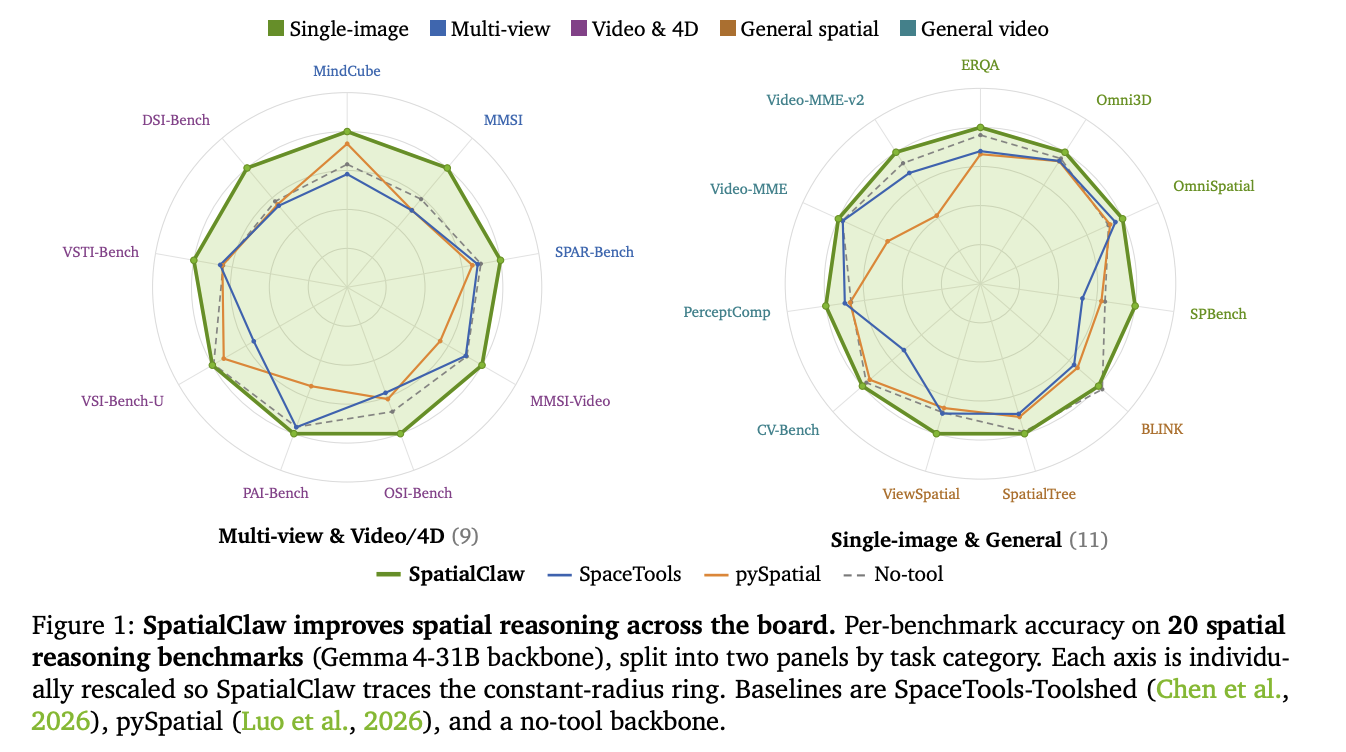
- 4D·다중 시점 과제에서 효과가 가장 큽니다. DSI-Bench는 +17.6점, MindCube는 +15.3점이 올랐습니다.
왜 코드를 행동으로 쓰는가
기존 에이전트의 행동 인터페이스는 보통 두 갈래였습니다. 하나는 처음 한 번에 긴 프로그램을 통째로 써 내려가는 단일 패스 방식이고, 다른 하나는 미리 등록된 JSON 스키마로 도구만 호출하는 방식입니다. 둘 다 한계가 분명합니다. 단일 패스는 중간 결과를 확인할 기회가 없어 잘못된 가정을 끝까지 끌고 갑니다. JSON 툴콜은 출력 형식이 고정되어 있어 NumPy나 SciPy 같은 일반 파이썬 도구와 자유롭게 섞기 어렵습니다.
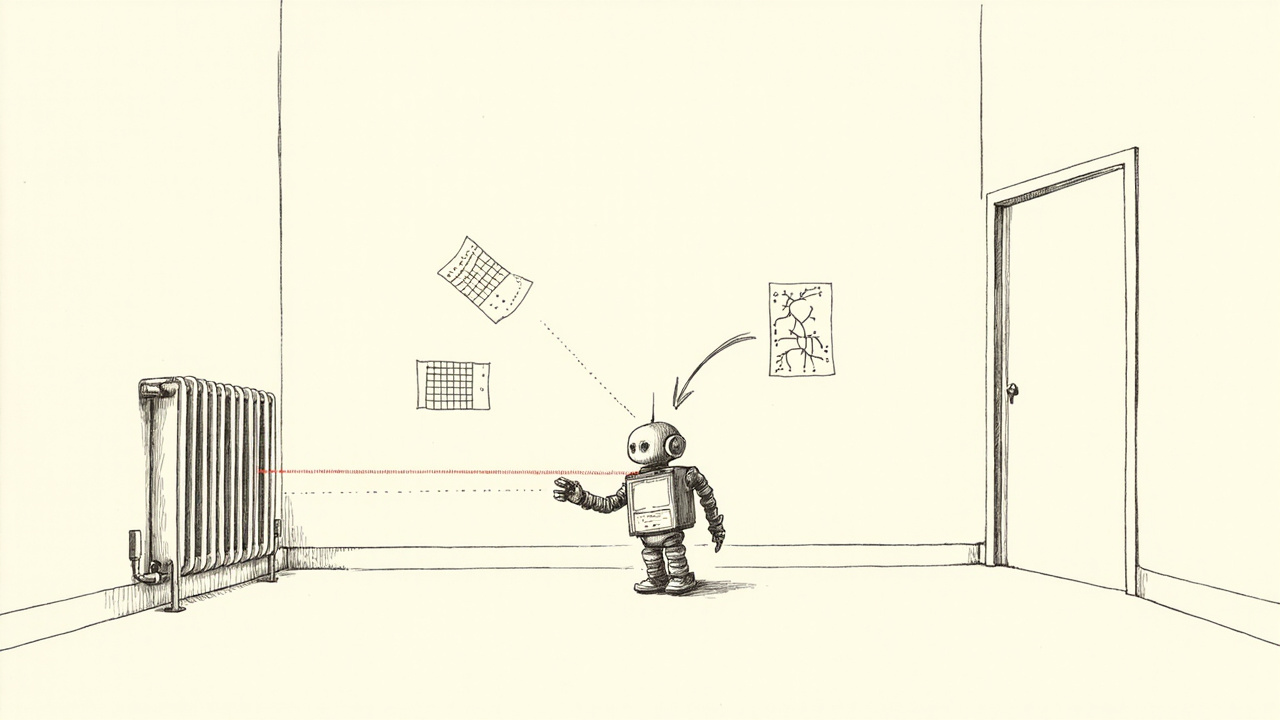
SpatialClaw는 같은 문제를 코드 셀로 풉니다. 거리 측정 과제를 예로 들어 보겠습니다. 처음에는 두 물체의 중심점 사이 거리를 계산하던 에이전트가, 결과를 확인한 뒤 KD-트리로 전략을 바꿔 가장 가까운 점 사이의 실제 거리를 다시 잽니다. 정답이 0.9m일 때 0.9439m가 나옵니다. 한 번의 호출에서 끝낼 수 없는 문제를, 코드와 실행 결과를 번갈아 보며 다듬는 것입니다.
아키텍처 — 다섯 단계 루프
내부 구조는 깔끔합니다. 상태를 유지하는 파이썬 커널 안에 입력 프레임과 인지 기본기들이 미리 로드됩니다. 진입점은 여섯 개입니다. InputImages로 프레임을 잡고, Metadata로 프레임율과 인덱스를 다루고, tools 네임스페이스로 인지·기하 도구를 호출합니다. 결과는 show()로 에이전트 컨텍스트에 다시 끼워 넣고, 별도 VLM 세션은 vlm으로 보냅니다. 최종 답은 ReturnAnswer()로 제출합니다.
도구 본진은 두 개입니다. tools.Reconstruct는 Depth Anything 3를 감싸 프레임별 깊이와 카메라 내·외부 파라미터, 조밀한 포인트맵까지 돌려줍니다. tools.SAM3는 SAM 3을 감싸 텍스트·점·박스 프롬프트만으로 이미지와 비디오 마스크를 만듭니다. 그 위에 Geometry, Mask, Time, Graph, Draw 같은 유틸리티가 얹혀 있습니다.
샘플 하나가 도는 흐름도 다섯 단계로 정해져 있습니다. 이미지 없이 전략을 세우는 계획 단계, 단계마다 한 셀씩 코드를 짜는 생성 단계, 정적 AST 검사로 위험한 코드를 미리 걸러내는 실행 단계, 결과와 오류를 다시 모으는 피드백 단계, 그리고 답을 제출하거나 30스텝에서 타임아웃하는 종료 단계로 끝납니다.
벤치마크가 말하는 것
같은 Gemma4-31B 백본에서 인터페이스만 바꿔 20개 벤치마크를 돌렸을 때, 평균 정확도는 도구 없음 53.4%, 단일 패스 코드 55.2%, JSON 툴콜 56.7%, SpatialClaw 59.9%로 정리됐습니다. 기존 공간 에이전트와 비교하면 격차는 더 큽니다. VADAR 40.5%, pySpatial 47.8%, SpaceTools-Toolshed 48.7%로, SpatialClaw 대비 두 자릿수 포인트가 벌어집니다.
성능이 어디서 오는지도 뜯어봤습니다. JSON 툴콜 대비 개선분의 절반 이상인 52.2%가 코드 컴포지션에서, 19.5%가 제어 흐름에서, 나머지 28.3%가 인터페이스와 무관한 일반 향상에서 나왔습니다. 정적인 단일 이미지 질문보다 여러 프레임과 시점을 이어 붙여야 하는 4D 과제에서 효과가 두드러집니다. DSI-Bench가 17.6점, MindCube가 15.3점 오른 것도 같은 이유입니다.
코드는 이렇게 보입니다
논문에 실린 대표 예시는 한 화면 안에 들어옵니다.
recon = tools.Reconstruct.Reconstruct(InputImages)
seg = tools.SAM3.segment_video_by_text(["radiator heater", "door"])
show(seg.visualize(1))

pts_h = seg.get_masked_points(recon, frame=1, object=0)
pts_d = seg.get_masked_points(recon, frame=2, object=1)
dists, _ = scipy.spatial.KDTree(pts_d).query(pts_h, k=1)
ReturnAnswer(float(dists.min()))
장면을 재구성한 뒤 두 물체를 분할하고, 마스크를 한 번 눈으로 확인한 다음, 중심점 거리가 아닌 KD-트리 기반 최단점 거리로 답을 내는 흐름입니다. 같은 결과를 JSON 툴 스키마로 짜려면 별도 후처리가 필요한데, 여기서는 그 단계가 그냥 사라집니다.
실무자가 볼 핵심 포인트
- 모델을 다시 학습시키지 않고도 공간 추론 정확도를 끌어올릴 수 있다는 점을 정량적으로 보였습니다. 인터페이스 설계가 모델 재학습 못지않게 중요할 수 있다는 신호입니다.
- 같은 프롬프트와 하이퍼파라미터로 Qwen3.5/3.6, Gemma4 계열 26B에서 397B까지 그대로 돌아갑니다. 백본 교체에 대한 회귀 테스트 비용이 사실상 사라집니다.
- 로봇·임바디드 에이전트, 다중 시점 검사, 4D 영상 해석, 실내 장면 QA 등 실측 거리·방향·관계가 필요한 작업에 바로 붙여 볼 가치가 있습니다.
- 다만 도구 라이선스는 비상업 제한이 걸려 있고, 인지 품질 자체가 여전히 병목입니다. 상용 도입 전에는 라이선스와 추론 비용을 함께 따져야 합니다.
- 코드: https://github.com/NVlabs/SpatialClaw, 프로젝트 페이지: https://spatialclaw.github.io/.