문서를 읽고, 목소리를 듣고, 영상을 보고, 화면을 조작한다 — 이 모든 걸 단일 모델 하나로. NVIDIA가 공개한 Nemotron 3 Nano Omni 30B-A3B는 기존 비전-언어 모델의 경계를 텍스트·이미지·비디오·오디오 전체로 확장한 옴니모달 모델이다.
핵심 요약
- 옴니모달 통합: 문서·이미지·비디오·오디오·텍스트를 단일 아키텍처에서 공동 처리
- 문서 이해 1위: MMlongbench-Doc 57.5점, OCRBenchV2 65.8점으로 동급 최고
- 처리 효율: 멀티문서 7.4배, 비디오 9.2배 시스템 처리량 (경쟁 오픈 옴니 모델 대비)
- 아키텍처: Mamba-Transformer-MoE 백본 + C-RADIOv4-H 비전 인코더 + Parakeet 오디오 인코더
- 오픈웨이트: BF16·FP8·NVFP4 체크포인트 HuggingFace 공개
무엇을 위해 만들었나
Nemotron 3 Nano Omni가 겨냥하는 5가지 워크로드:
1. 실세계 문서 분석
단순 OCR을 넘어선다. 레이아웃·표·수식·섹션 구조·페이지 간 참조가 복잡하게 얽힌 100페이지 이상의 계약서, 기술 논문, 컴플라이언스 문서를 처리한다.
2. 자동 음성 인식(ASR)
Parakeet-TDT-0.6B-v2 인코더를 통해 다양한 화자·억양·배경 소음이 섞인 장시간 오디오를 고품질로 전사한다. HF Open ASR 리더보드에서 WER 5.95%로 Qwen3-Omni(6.55%)를 앞선다.
3. 장시간 오디오-비디오 이해
화면 녹화, 회의록, 교육 영상처럼 음성과 시각 정보가 동시에 흐르는 콘텐츠를 시간축 위에서 함께 추론한다. WorldSense 55.4점, DailyOmni 74.1점으로 모두 1위.
4. 에이전틱 컴퓨터 사용
GUI 환경에서 화면을 해석하고, UI 상태를 파악하고, 행동을 선택한다. OSWorld 47.4점(Qwen3-Omni 29.0점 대비 큰 격차)으로 에이전트 작업 능력을 입증했다.
5. 범용 멀티모달 추론
텍스트·이미지·표·오디오 신호를 긴 컨텍스트 창에서 종합해 다단계 추론, 계산, 구조적 추론을 수행한다.
벤치마크 성능
| 태스크 | 벤치마크 | Nemotron 3 Nano Omni | Nemotron Nano V2 VL | Qwen3-Omni 30B |
|---|---|---|---|---|
| 문서 이해 | OCRBenchV2-En | 65.8 | 61.2 | — |
| 문서 이해 | MMLongBench-Doc | 57.5 | 38.0 | 49.5 |
| 문서 이해 | CharXiv Reasoning | 63.6 | 41.3 | 61.1 |
| GUI | ScreenSpot-Pro | 57.8 | 5.5 | 59.7 |
| GUI | OSWorld | 47.4 | 11.0 | 29.0 |
| 비디오 | Video-MME | 72.2 | 63.0 | 70.5 |
| 비디오+오디오 | WorldSense | 55.4 | — | 54.0 |
| 비디오+오디오 | DailyOmni | 74.1 | — | 73.6 |
| 음성 | VoiceBench | 89.4 | — | 88.8 |
| ASR | HF Open ASR ↓ | 5.95 | — | 6.55 |
처리 효율 비교
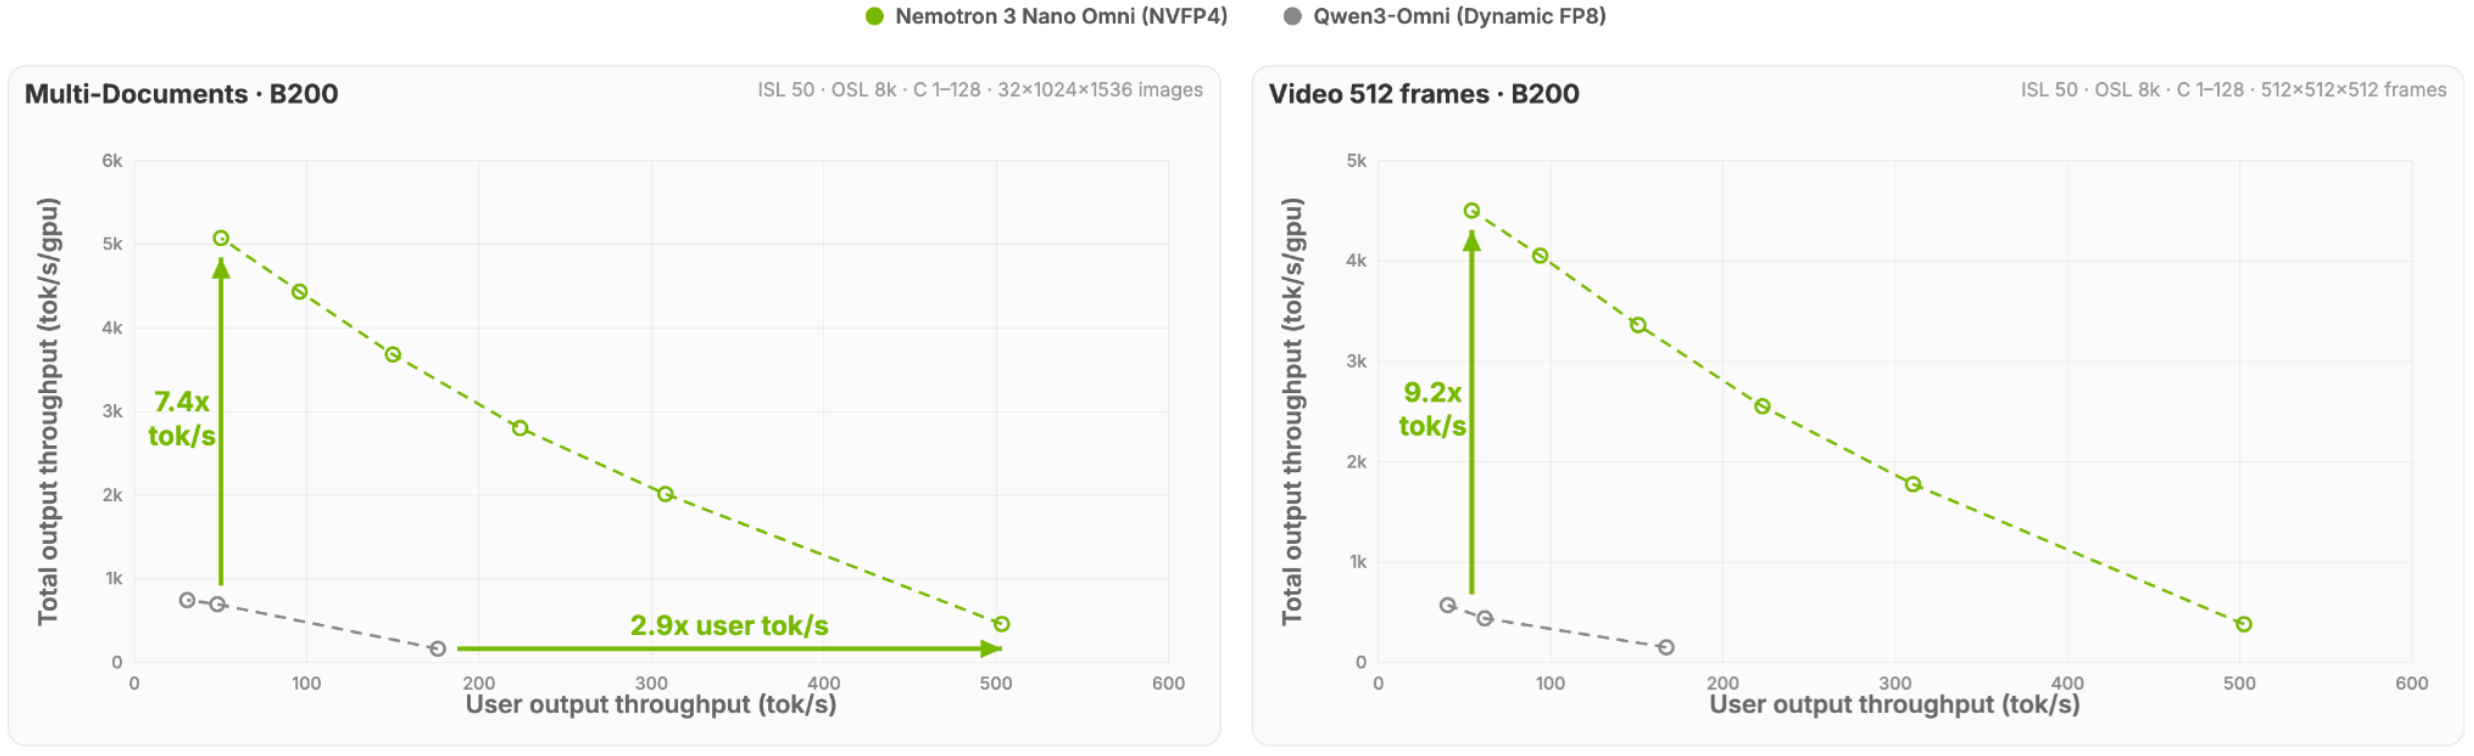 Figure 1: 고정된 사용자당 상호작용 임계값에서 멀티문서·비디오 사용 사례별 총 시스템 처리량. Nemotron 3 Nano Omni가 멀티문서 7.4배, 비디오 9.2배 우위를 보인다. (출처: NVIDIA)
아키텍처 핵심 혁신
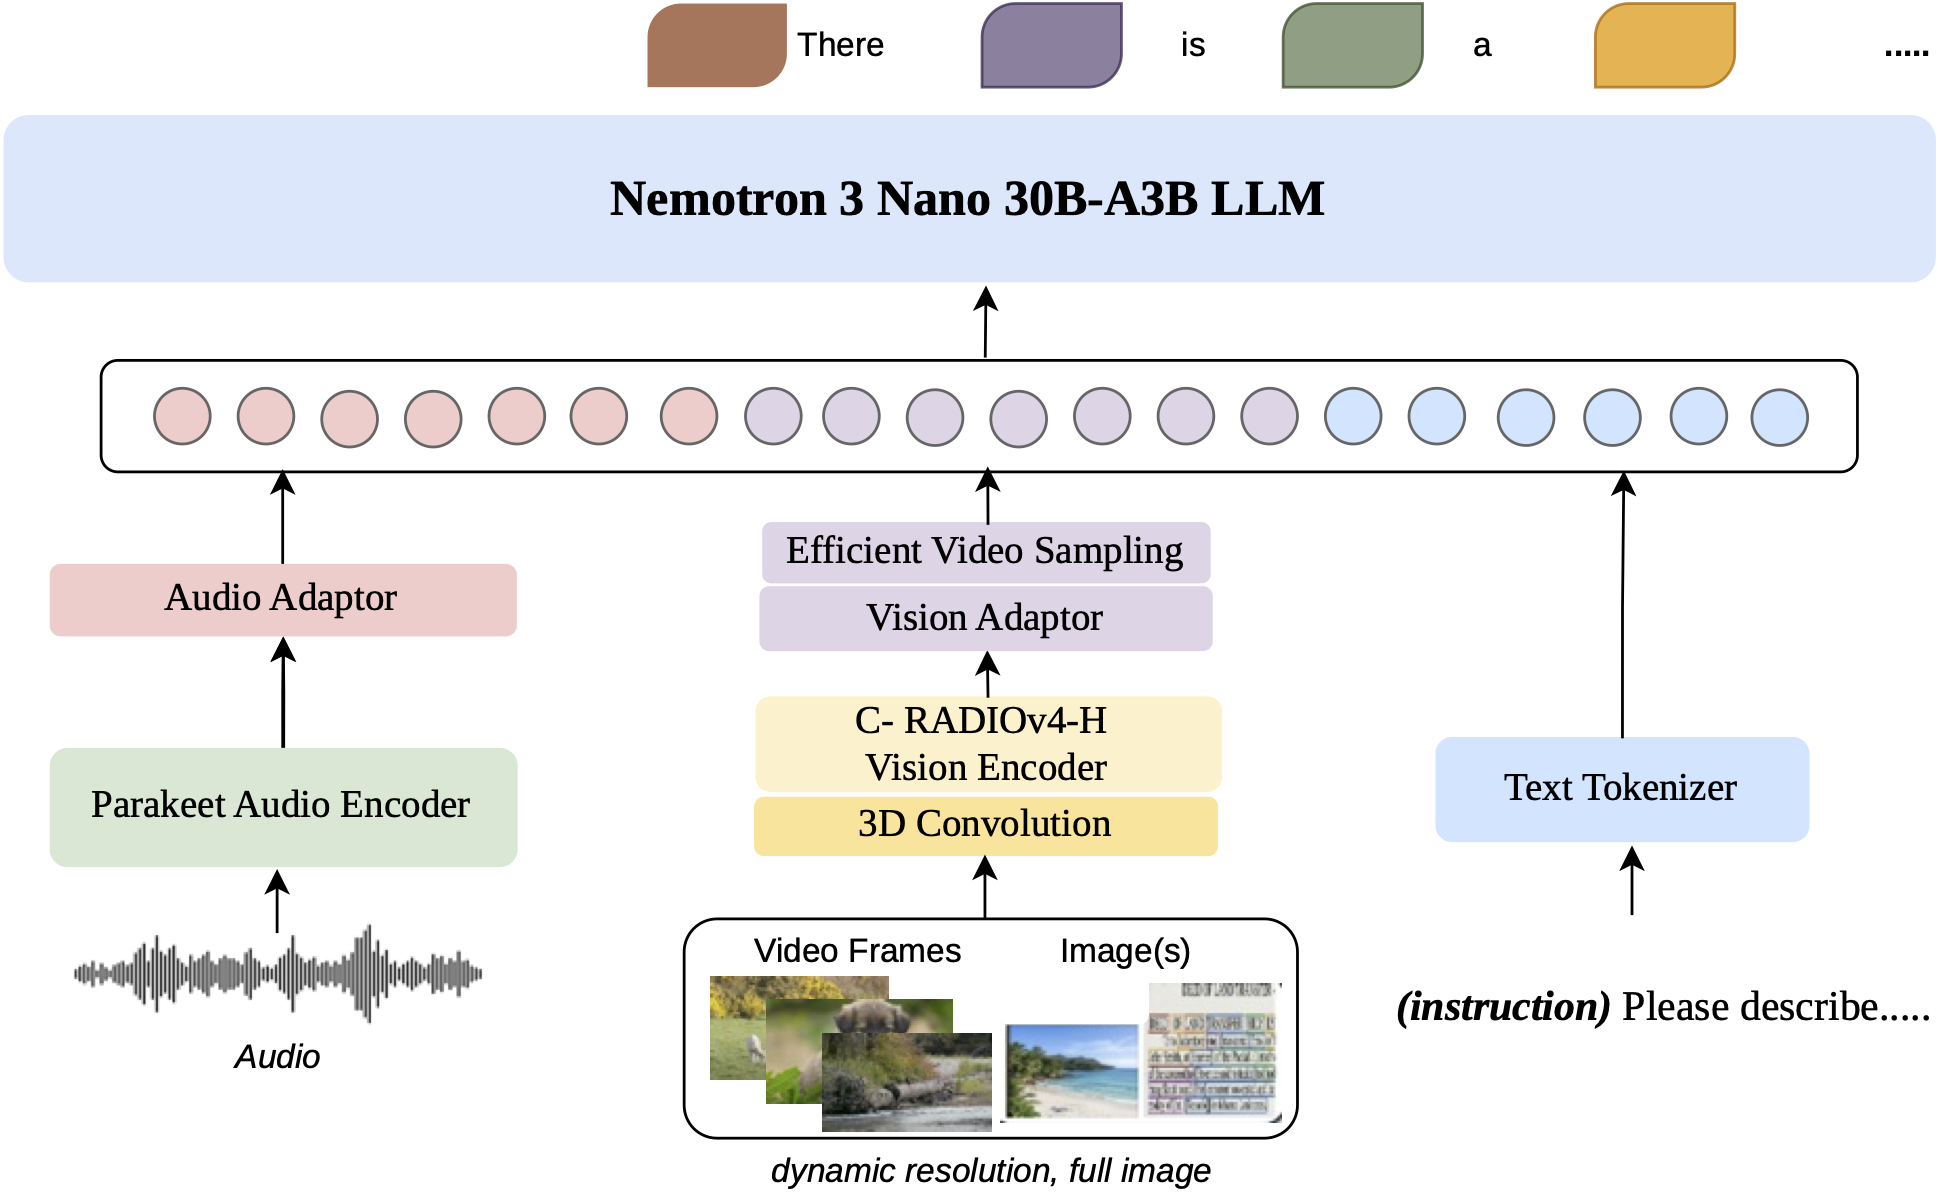 Figure 2: 통합 인코더-프로젝터-디코더 설계. 언어 백본, 비전 인코더, 오디오 인코더가 경량 프로젝터로 연결된다. (출처: NVIDIA)
하이브리드 Mamba-Transformer-MoE 백본
세 요소를 인터리빙한 백본이 장시간 멀티모달 컨텍스트를 처리한다:
- Mamba SSM 레이어 23개: 긴 시퀀스를 효율적으로 처리
- MoE 레이어 23개: 전문가 128개, top-6 라우팅, 공유 전문가
- GQA 레이어 6개: 글로벌 상호작용과 표현력 보존
동적 해상도 비전 처리
기존 v2 모델의 타일링 방식을 네이티브 종횡비 동적 해상도로 교체했다. 이미지당 16×16 패치를 최소 1,024개(512×512 등가)에서 최대 13,312개(1840×1840 등가)까지 가변 할당해 OCR 문서, 금융 표, 연구 그래프, GUI 레이아웃의 세밀한 디테일을 포착한다.
Conv3D 시간적 압축
비디오 처리에 전용 Conv3D 튜블릿 임베딩을 도입했다. 인접한 두 프레임을 ViT 이전에 하나의 “튜블릿"으로 융합해 언어 모델이 처리할 비전 토큰을 절반으로 줄인다. 동일 토큰 예산으로 프레임을 2배 처리하거나, 동일 프레임 수로 토큰을 절반 사용할 수 있다.
EVS — 효율적 비디오 샘플링
추론 시 활성화하는 EVS는 비전 인코더 이후 중복 비디오 토큰을 제거한다. 첫 프레임을 완전히 유지하고, 이후 프레임에서 변화가 있는 “동적” 토큰만 보존해 정적 토큰을 삭제한다. Conv3D와 결합하면 압축 효율이 배가된다.
네이티브 오디오 입력
Parakeet-TDT-0.6B-v2를 독립 오디오 인코더로 연결했다. 16kHz 샘플링, 최대 1,200초(20분) 훈련, LLM 최대 컨텍스트는 5시간 이상을 지원한다. 전통적인 VLM처럼 텍스트 전사본을 거치지 않고 오디오 토큰을 비전·텍스트 토큰과 함께 직접 처리한다.
실제 활용 예시
예시 1: 100페이지 문서 분석
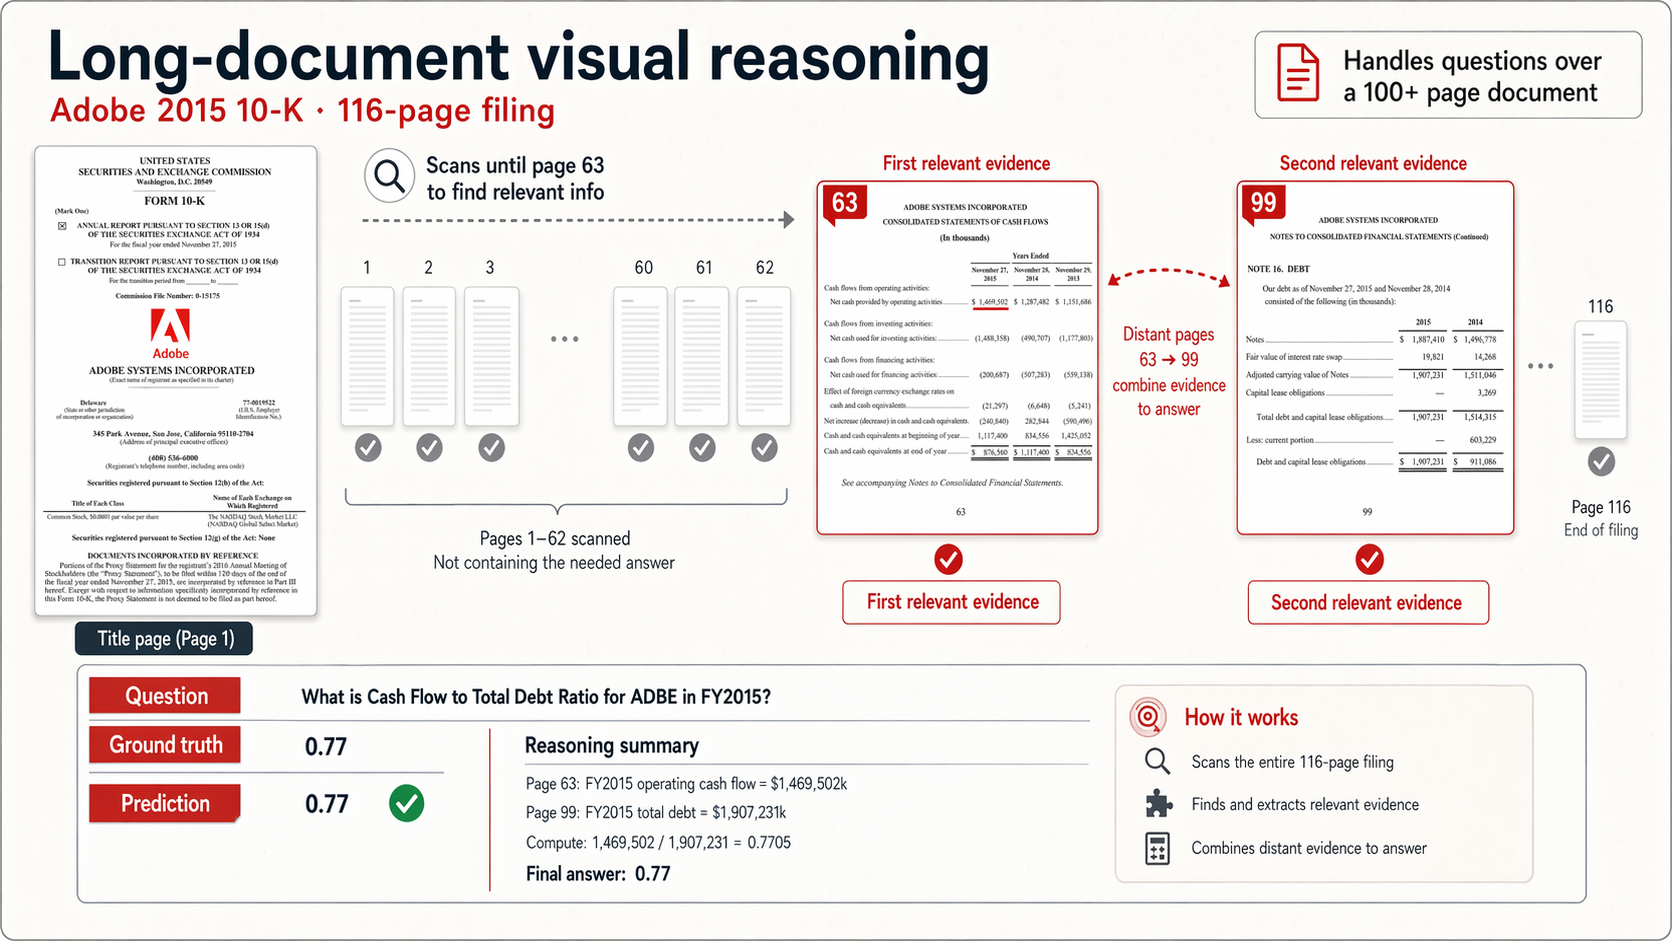 Figure 3: 100페이지 이상 재무 보고서에서 여러 수치를 추출해 계산하는 예시. 레이아웃 이해, 표/차트 읽기, 페이지 간 참조를 한 번에 처리한다. (출처: NVIDIA)
예시 2: 비디오+오디오 복합 추론
노트르담 대성당 화재 영상에서 “(1) 화재 중인 구조물과 보수 예산은? (2) 목격자 증언 시점의 화면은?“을 동시에 질의하면, 시각과 음성을 교차해 정확한 답변을 생성한다.
예시 3: 에이전틱 컴퓨터 사용
GUI 에이전트로 동작해 스크린샷을 해석하고, 링크·탭·메뉴를 클릭하며 운전면허 자격요건 페이지를 탐색하는 전체 과정을 자율 수행한다.
학습 인프라
- SFT: NVIDIA H100, 32~128노드, Megatron-LM + Transformer Engine
- RL: NeMo-RL + NeMo Gym, Ray 기반 B200·H100 클러스터
- 합성 데이터: 실세계 PDF에서 약 1,140만 개 QA 쌍(~45B 토큰) 생성 → MMLongBench-Doc 2.19배 향상
실무자가 볼 핵심 포인트
문서 파이프라인 대체 검토 — MMLongBench-Doc 57.5점은 동급 최상위. 100페이지 이상 계약서·보고서 자동 분석에 실질적 대안이다.
오디오-비디오 파이프라인 통합 — 전사 API + VLM을 별도로 연결하던 구조를 단일 모델로 대체 가능. 회의록, 강의 영상, 고객 지원 녹화 분석에서 유리하다.
처리량이 핵심 — 정확도가 비슷해도 멀티문서 7.4배, 비디오 9.2배 처리량은 프로덕션 배포 비용을 직접 낮춘다.
에이전트 GUI 작업 — OSWorld 47.4점 vs Qwen3-Omni 29.0점. 브라우저 자동화, RPA 대체 시나리오에서 가장 강력한 오픈웨이트 옵션 중 하나다.
세 가지 정밀도 옵션 — BF16·FP8·NVFP4 체크포인트를 제공해 인프라 환경에 맞게 선택할 수 있다.
원문 출처: Introducing NVIDIA Nemotron 3 Nano Omni — NVIDIA, HuggingFace Blog (2026. 4. 28)