로봇 학습 현장은 의외로 사람 손이 많이 갑니다. 보상 함수를 짜고, 실패하면 워크스페이스를 다시 정리하고, 영상 찍어서 라벨링하고, 안 되면 또 코드를 고칩니다. 하루에 시도 한두 번이 한계인 작업도 흔합니다.
엔비디아가 카네기멜런대(CMU), UC버클리와 함께 6월 17일(현지시간) 공개한 ENPIRE는 이 반복 사이클을 통째로 코딩 에이전트에게 맡깁니다. 사람은 처음 한 번만 환경을 설명해 주고, 그다음부터는 GPT-5.5 같은 코딩 에이전트가 보상 함수를 직접 짜고, 학습 코드를 고치고, 결과를 보고 다음 가설을 세웁니다. 그리고 그 결과가 핀 삽입 100%, 푸시-T 최대 99% 같은 숫자로 나옵니다.
개요
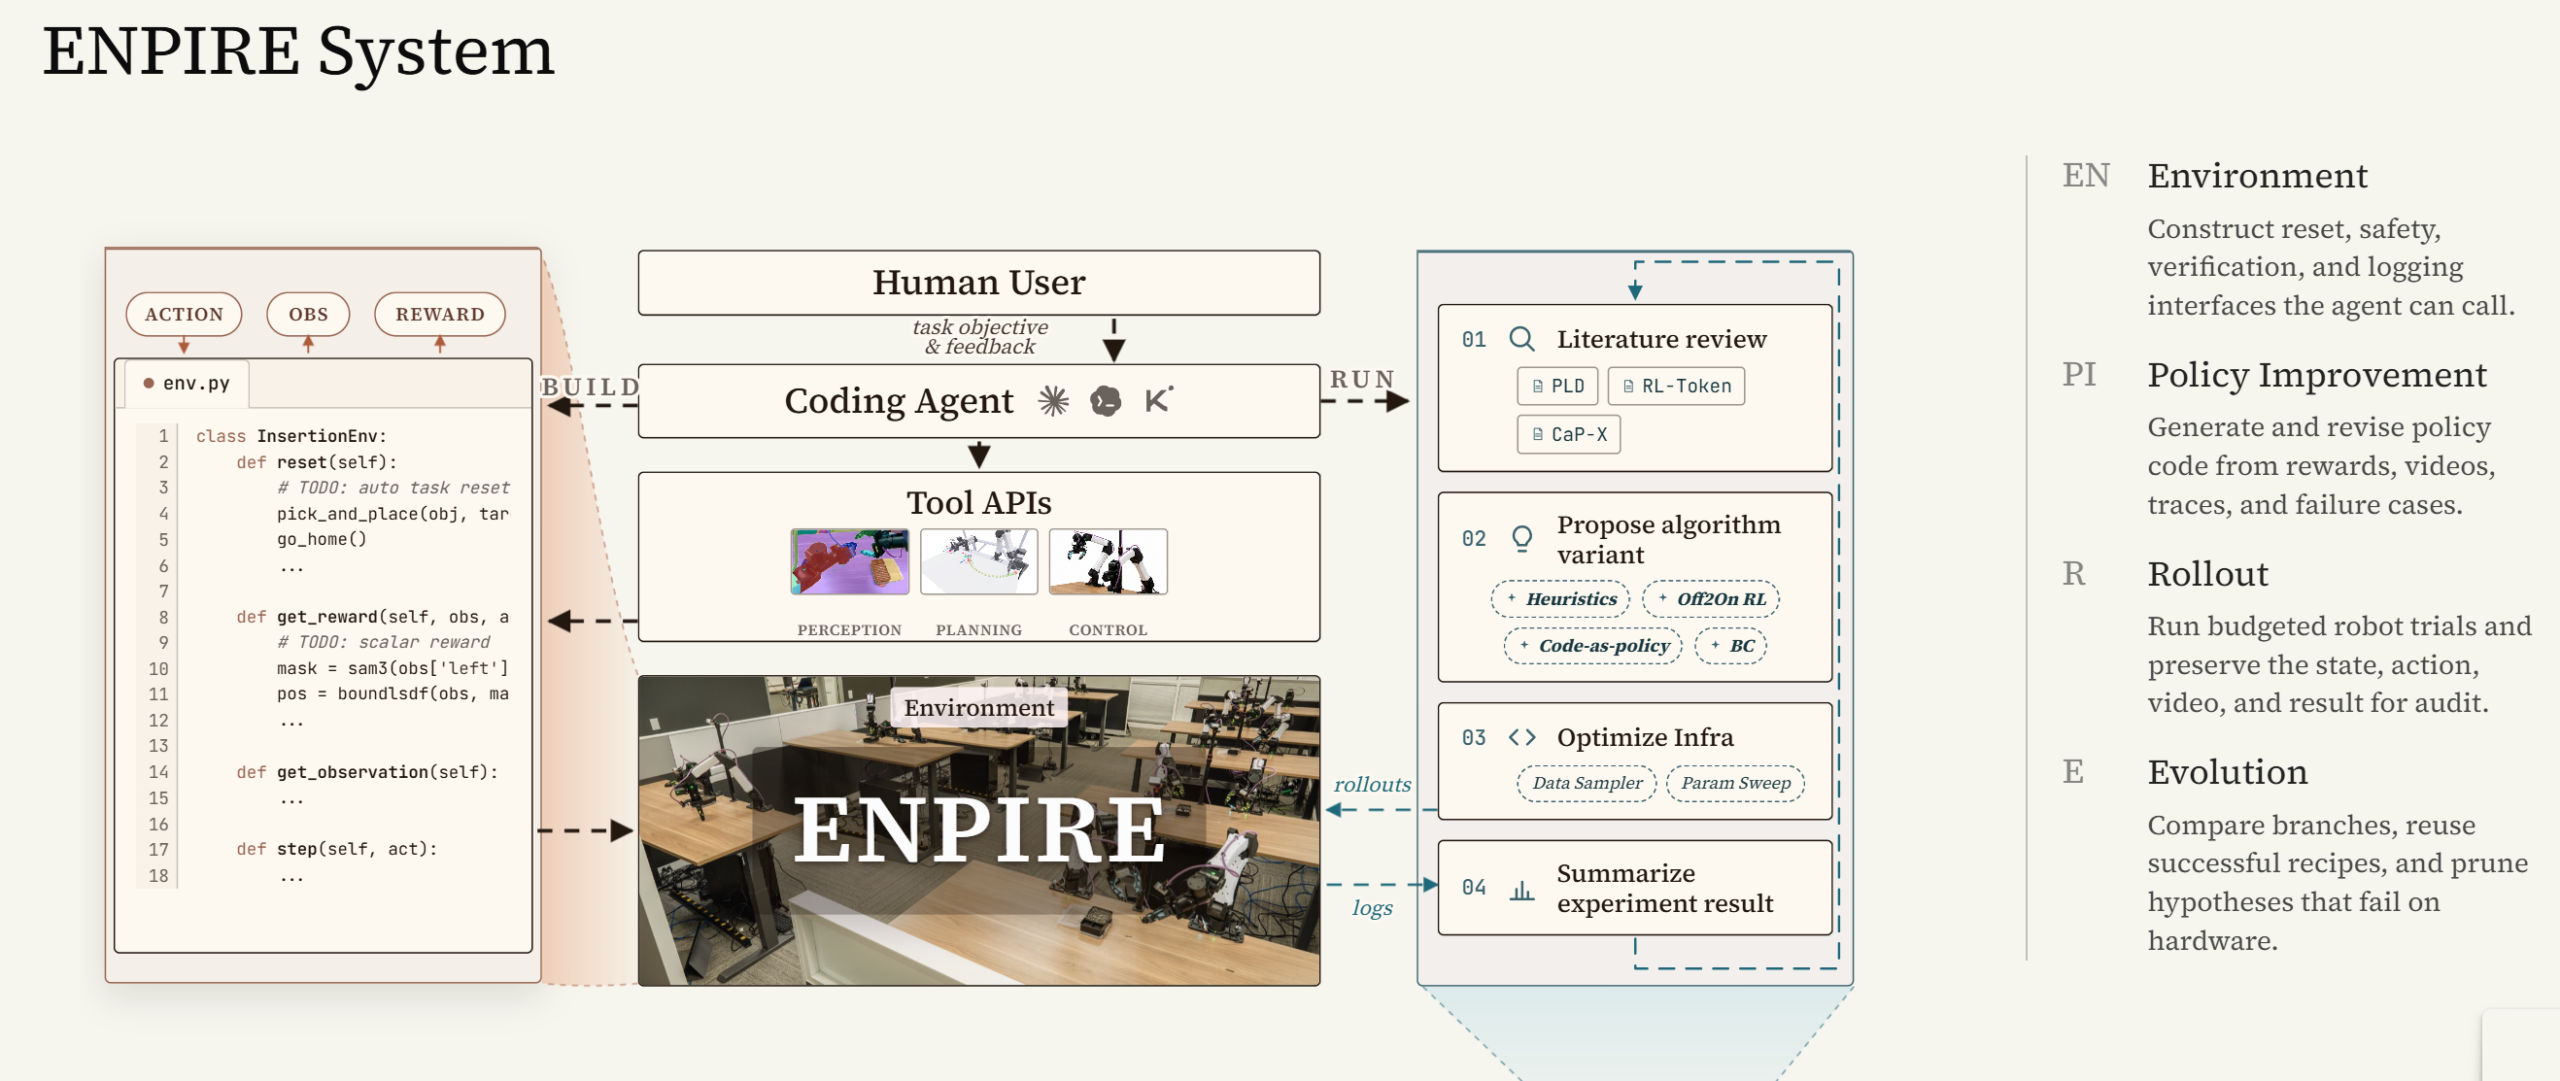
ENPIRE는 두 단계로 나뉩니다. 1단계는 사람이 환경을 짚어주는 짧은 셋업. 2단계는 코딩 에이전트가 혼자 굴러가는 무인 개선 루프입니다. 핵심은 양팔 YAM 로봇 8대를 동시에 돌린다는 점, 그리고 각 로봇이 깃(Git)으로 발견을 공유한다는 점입니다. 한 대가 찾은 좋은 보상 함수가 곧장 다른 7대에 퍼집니다.
테스트는 핀 삽입, 핀 분류, 케이블 타이 절단, 푸시-T, 그리고 마지막에 GPU를 메인보드에 꽂는 일까지 다섯 가지. 코딩 에이전트 자리에는 Codex(GPT-5.5), Claude Code(Opus 4.7), Kimi Code(Kimi K2.6)를 번갈아 끼워봤고, 대부분의 작업에서 GPT-5.5가 가장 좋았다고 합니다.
핵심 요약
- 8대 병렬 + Git 공유: 푸시-T 학습 시간이 1대 5시간 → 8대 2시간으로 단축. 핀 삽입은 1대 90분대 → 8대 약 40분.
- 사람 개입 최소화: 사람이 라벨링하지 않습니다. 성공/실패 영상 몇 분만 보여주면 에이전트가 보상 함수를 직접 코드로 작성.
- 150ms 미만 판정: 케이블 타이 절단 같은 작업에서는 카메라 두 대를 묶어 false-positive를 막으면서 응답 시간을 150ms 아래로 유지.
- 알고리즘 선택도 자율: 모방 학습(behavior cloning)과 강화학습 중 무엇을 쓸지도 실세계 신호를 보고 에이전트가 결정.
- 전이 학습: 핀 삽입에서 얻은 정책이 GPU 장착에 그대로 옮겨붙으며 성공으로 이어짐.
- 시뮬레이션의 한계: 푸시-T 세 에이전트 중 두 대는 시뮬레이션에서 성공해도 실세계에서 무너짐. 마찰·동역학 변동이 원인.
본문
1단계 — 사람이 한 번만 환경을 설명한다
기존 방식에서 가장 귀찮은 게 보상 함수입니다. “이번엔 핀이 똑바로 들어갔는가?“를 코드로 판정해야 하는데, 작업마다 새로 짜야 하고 빈틈도 많습니다. ENPIRE는 이걸 사람이 짜지 않습니다.
대신 사람이 해 주는 건 안전 경계, 자동 워크스페이스 리셋, 그리고 성공·실패 사례 영상 몇 분 정도입니다. 그 영상을 본 에이전트가 직접 판정 코드를 씁니다. 핀 삽입에서는 시각적 정렬, 그리퍼 높이, 추정 힘 값을 묶어서 판정기를 만들었고, 케이블 타이 절단에서는 카메라 두 대의 시점을 결합해 false-positive를 줄이면서 150ms 안에 결과를 내놓도록 짰습니다. 사람이 직접 짠 코드와 큰 차이가 없는 수준이라고 합니다.
2단계 — 코딩 에이전트의 무인 개선 루프
여기서부터가 ENPIRE의 진짜 그림입니다. 에이전트는 사람 없이 다음 루프를 반복합니다.
- 학습 코드를 돌려서 정책을 학습.
- 로봇으로 실제 시도. 워크스페이스는 자동 리셋.
- 보상 함수가 성공/실패를 판정.
- 결과 로그를 읽고, 관련 논문을 참고하고, 가설을 세움.
- 코드(하이퍼파라미터, 알고리즘 선택, 보상 형태)를 직접 수정.
핵심 결정 중 하나는 모방 학습이냐 강화학습이냐입니다. 사람 시범이 충분한 작업은 behavior cloning이 빠르고, 시범으로 한계가 명확한 작업은 강화학습이 필요합니다. ENPIRE는 이 선택도 에이전트에게 맡깁니다. 실세계 성공률 곡선을 보고 알아서 갈아탑니다.
8대를 굴리면 무엇이 바뀌나
이 시스템의 두 번째 핵심은 양팔 YAM 로봇을 8대 동시에 돌리는 fleet 구조입니다. 각 로봇은 자기 하드웨어와 컴퓨팅을 가진 독립 셋업이고, 발견한 결과는 깃 저장소를 통해서만 공유합니다. 한 대가 더 나은 보상 함수를 찾아 커밋하면 다음 사이클에서 다른 로봇들이 그걸 그대로 받아 갑니다.
결과는 명확합니다. 푸시-T는 1대로 약 5시간 걸리던 학습이 8대에서 2시간으로 줄었고, 핀 삽입은 사람 개입 방식 대비 수렴 시간이 절반 이하로 떨어졌습니다(90분대 → 약 40분). 단순 병렬화가 아니라, 서로 다른 가설을 동시에 시험하면서 좋은 것만 골라 합치기 때문에 가능한 차이입니다.
아래 영상은 8대 fleet가 푸시-T 작업을 동시에 학습하는 장면입니다.
어떤 작업까지 풀렸나
테스트 작업은 다섯 가지입니다.
- 핀 삽입: 8대 학습 후 100% 수렴.
- 핀 분류: 작은 부품을 통에 분류해 넣기. 최대 99%.
- 케이블 타이 절단: 정밀 커터로 자르기. 최대 99%.
- 푸시-T: T자 블록을 정해진 위치·각도로 미는 고전 벤치마크. 최대 99%.
- GPU 장착: 그래픽카드를 메인보드 슬롯에 꽂기. 핀 삽입에서 얻은 정책이 그대로 전이되어 성공.
GPU 장착 사례가 흥미롭습니다. 같은 정책이라도 부품과 자세가 다른데, ENPIRE는 핀 삽입에서 학습한 정렬·끼움 동작을 GPU에 옮겨붙여 성공시킵니다. 아래는 GPU 작업 후 자동으로 워크스페이스를 리셋하는 장면입니다.
코딩 에이전트 비교 — 누가 더 잘했나
ENPIRE는 코딩 에이전트 자리에 세 모델을 갈아 끼우며 같은 실험을 돌렸습니다.
- Codex (GPT-5.5) — 대부분의 작업에서 가장 좋은 결과.
- Claude Code (Opus 4.7)
- Kimi Code (Kimi K2.6)
세부 수치는 공개되지 않았지만, “Codex가 대체로 가장 잘했다"는 결론입니다. 보상 함수처럼 도메인 지식이 필요한 코드 작성, 그리고 실패 로그를 읽고 다음 가설을 세우는 추론에서 차이가 벌어졌다는 뉘앙스로 읽힙니다.
시뮬레이션은 여전히 거짓말을 한다
가장 솔직하게 짚고 가야 할 부분입니다. 푸시-T 실험에서 세 에이전트는 시뮬레이션 안에서는 전부 푸시-T를 풀었습니다. 그런데 실세계에서는 두 대가 무너졌습니다. 원인은 마찰 차이, 로봇 동역학의 미세한 변동, 그리고 물체가 예상과 다르게 미끄러지는 현상이었습니다.
ENPIRE처럼 코딩 에이전트가 자율적으로 학습을 굴리는 시스템도 결국 실세계 데이터를 봐야 한다는 뜻입니다. “시뮬레이션에서 풀었다"가 “현장에서 된다"의 보증이 아닙니다.
실무자가 볼 핵심 포인트
- 사람 라벨링이 사라지는 지점이 보입니다. 보상 함수까지 코딩 에이전트가 짜고, 성공·실패 영상 몇 분이 라벨 데이터의 대체재가 됩니다. 라벨링 비용 구조가 크게 흔들립니다.
- fleet 학습의 가성비가 강력합니다. 8대 병렬 + Git 공유로 학습 시간이 1/2~1/3로 줄어듭니다. 로봇 한 대당 하루 시도 횟수에 묶여 있던 산업 현장 학습이 다르게 풀립니다.
- 코딩 에이전트의 추론 품질이 학습 품질을 정합니다. GPT-5.5가 우세했다는 결과는, 결국 로봇 학습 인프라에 어떤 모델을 꽂느냐가 최종 성공률을 좌우한다는 뜻입니다.
- 시뮬→실세계 갭은 그대로입니다. 시뮬레이션 성공률을 그대로 KPI로 잡으면 안 됩니다. 실세계 평가가 별도로 필요합니다.
- 자동 워크스페이스 리셋이 핵심 인프라입니다. 사람이 없이 24시간 굴리려면 실패 후 원상복구가 자동이어야 합니다. ENPIRE의 가장 과소평가된 부분일 수 있습니다.