개요
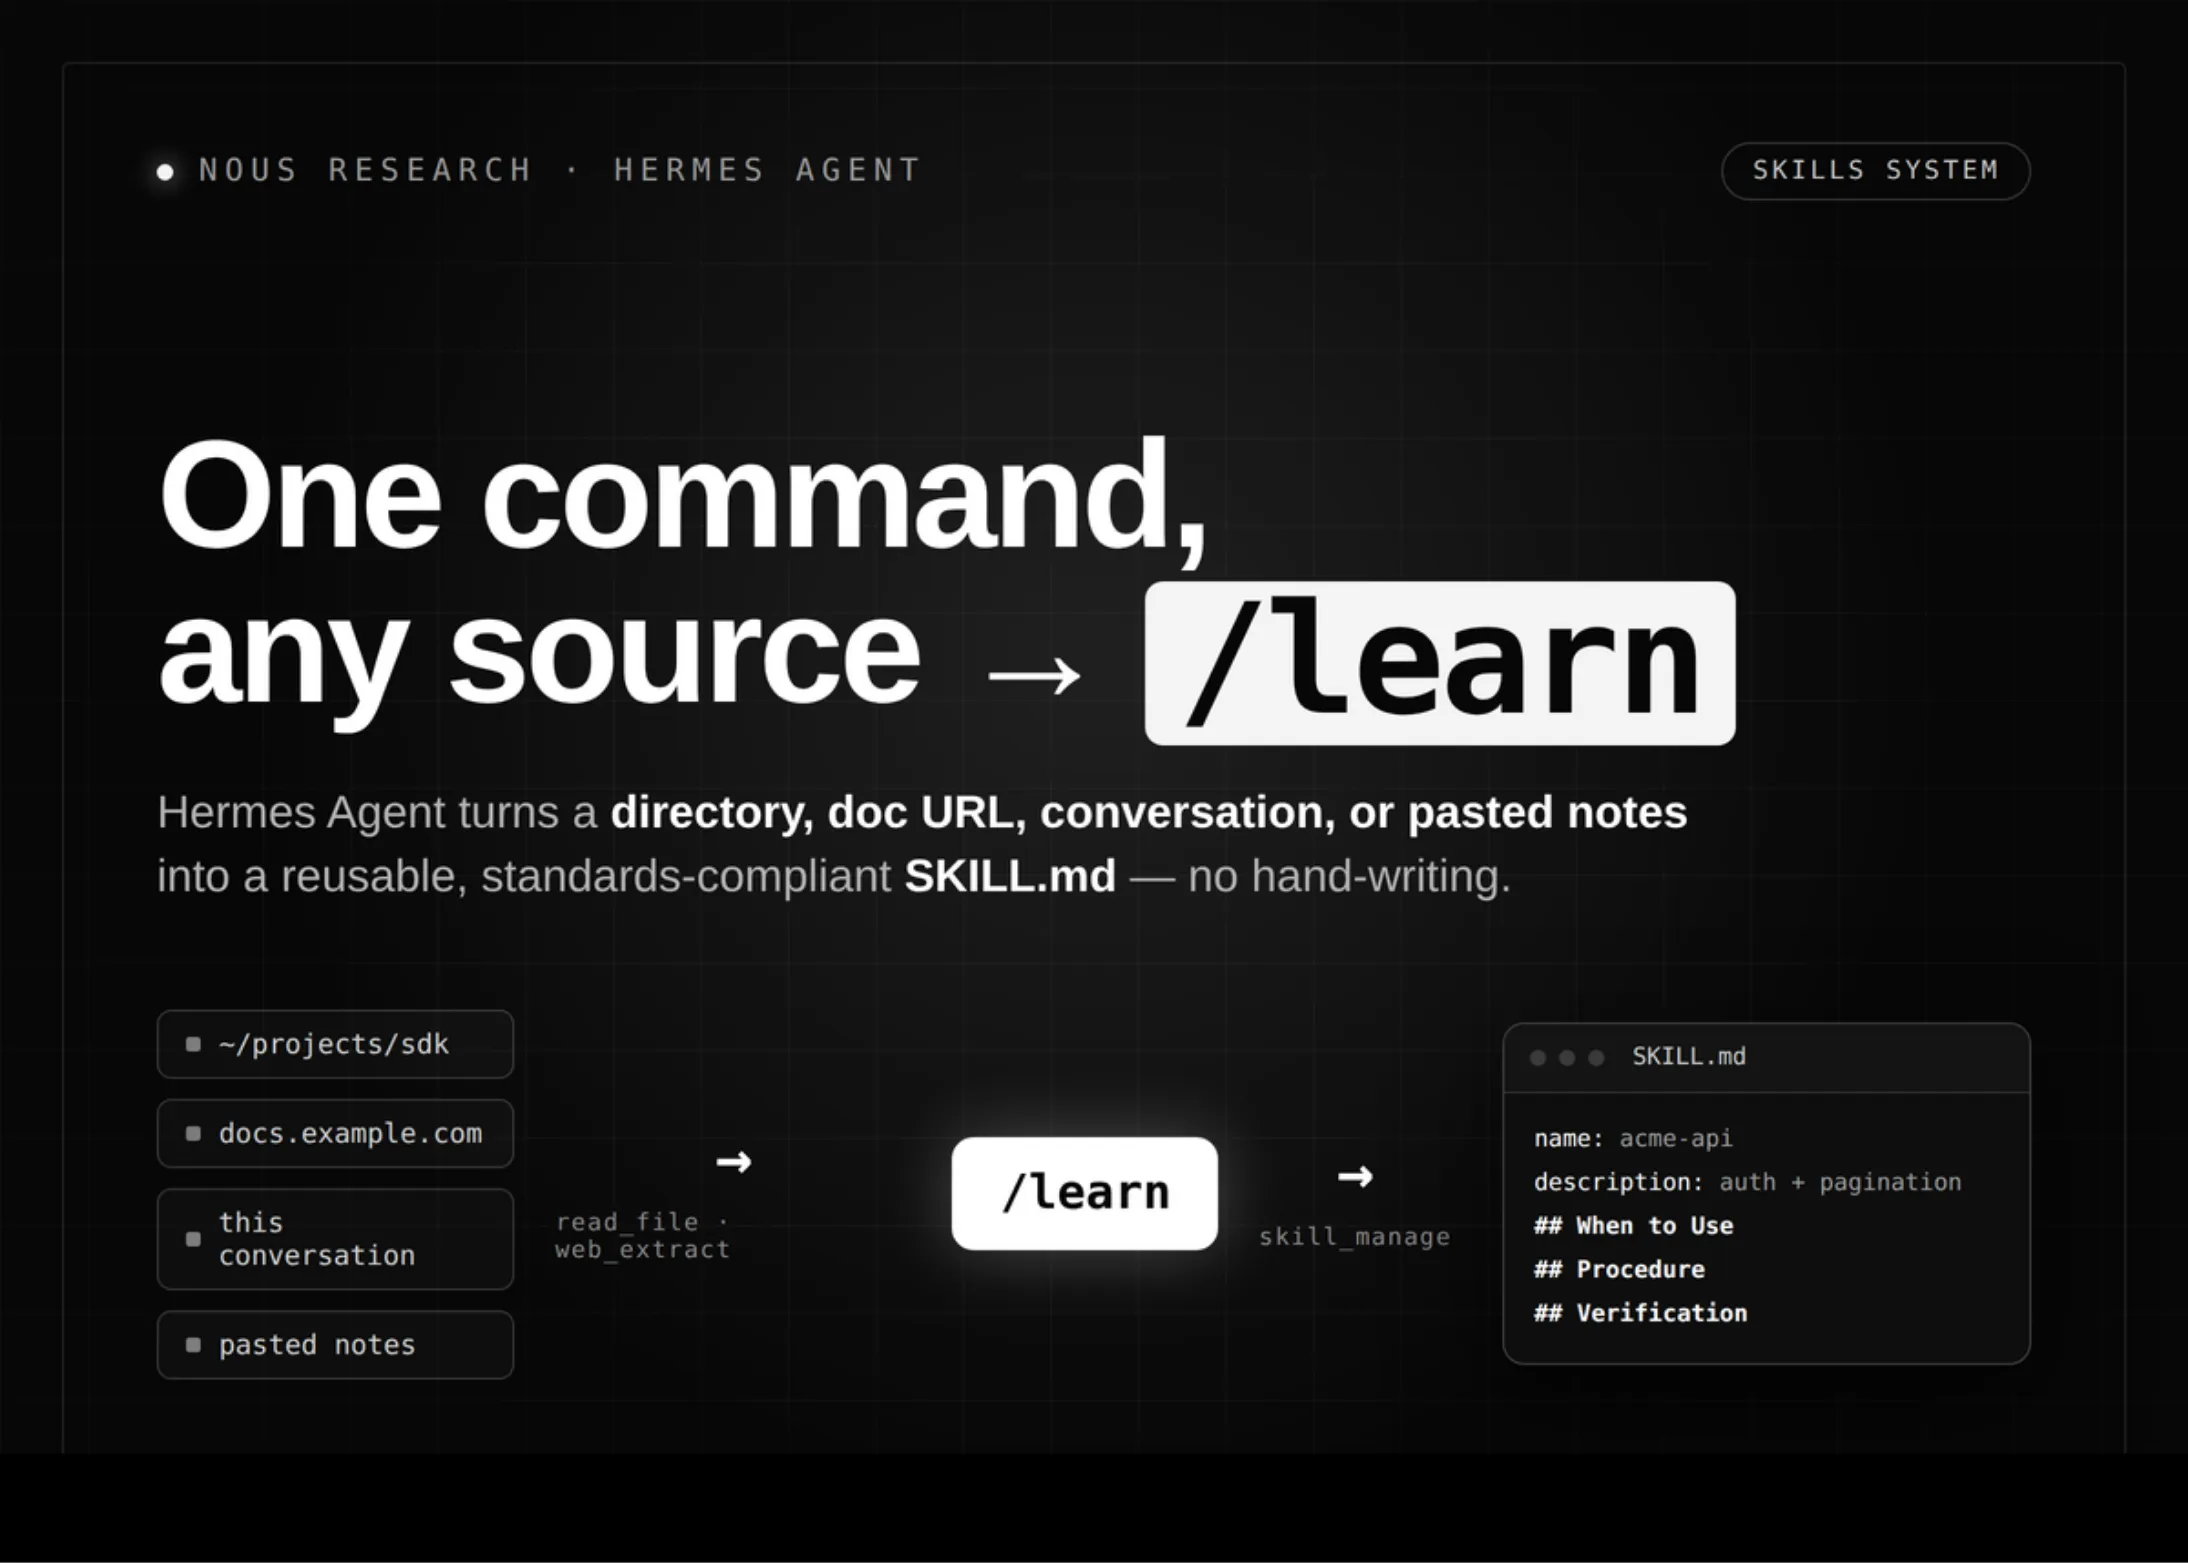
오픈소스 진영에서 자기개선 에이전트를 끌고 가던 누스 리서치(Nous Research)가 자사 Hermes Agent에 흥미로운 기능을 하나 더 얹었습니다. /learn이라는 슬래시 명령입니다. 그동안 에이전트에게 새 능력을 가르치려면 사람이 직접 SKILL.md 파일을 손으로 써야 했습니다. 폴더 만들고, 헤더 맞추고, 절차를 단계별로 정리하고. 이게 귀찮아서 만들다 만 스킬 디렉터리가 누구한테나 한두 개씩은 있을 겁니다. /learn은 그 작업 자체를 에이전트에게 떠넘기는 명령입니다. 원본 자료만 가리키면, 표준에 맞는 스킬 파일을 알아서 써 줍니다.

핵심 요약
- 누스 리서치가 Hermes Agent에 슬래시 명령
/learn을 추가했습니다. 에이전트가 직접 표준 형식의SKILL.md를 작성합니다. - 입력 형태가 자유롭습니다. 로컬 디렉터리(SDK·문서), 온라인 문서 URL, 대화 기록, 그냥 붙여넣은 메모까지 모두 받습니다.
- 별도 인제스션 엔진을 만들지 않았다는 점이 핵심입니다.
/learn은 평범한 에이전트 턴 위에 표준 가이드만 얹은 구조라서, CLI·TUI·메신저·대시보드 어디서든 동일하게 작동합니다. - 스킬은
~/.hermes/skills/에 저장되고, 3단계 점진적 공개(progressive disclosure) 방식으로 불러옵니다. 큰 스킬 라이브러리도 컨텍스트를 통째로 잡아먹지 않습니다. - 결과물은
skill_manage도구를 통해 저장되며, 승인 게이트가 걸려 있으면 사람이 검토한 다음에야 디스크에 떨어집니다.
무엇을 받고, 어떻게 만드는가
/learn이 받는 입력은 네 종류입니다.
- 로컬 디렉터리: SDK 소스, 사내 매뉴얼 폴더, 설정 파일 모음
- 온라인 문서 URL: 외부 API 문서, 공식 가이드
- 대화형 워크플로: 방금 끝낸 배포·디버깅 대화 기록
- 붙여넣은 절차·메모: 노션에서 긁어 온 짧은 글
에이전트는 별도의 새 도구를 쓰지 않습니다. 이미 갖고 있던 read_file, search_files, web_extract로 원본을 읽고, 그 위에 표준 가이드 프롬프트를 얹어 SKILL.md를 씁니다. 누스 리서치는 발표에서 이렇게 설명했습니다. “Hermes Agent는 이제 무엇에서든 /learn할 수 있습니다. 어떤 종류의 원본이든 — 코드, API 문서, 매뉴얼, PDF, 설정 파일을 폴더째 던져도 검증 가능한 재사용 스킬로 정리해 냅니다.”
별도 파서나 임베딩 파이프라인을 안 만든 게 인상적입니다. 그 덕에 CLI에서 쓰던 명령이 메신저 게이트웨이나 웹 대시보드에서도 동일하게 작동합니다. 어디서 호출하든 같은 에이전트 턴이고, 같은 표준이 적용됩니다.
SKILL.md 형식과 3단 로딩
스킬 파일은 YAML 프런트매터를 얹은 마크다운입니다. 이름·설명·버전·플랫폼·태그를 메타로 두고, 본문에는 “언제 쓰는가 / 절차 / 함정 / 검증” 네 섹션을 권장합니다.
---
name: my-skill
description: 이 스킬이 무엇을 하는지 한 줄
version: 1.0.0
platforms: [macos, linux]
metadata:
  hermes:
    tags: [python, automation]
    category: devops
---

# 스킬 제목

## 언제 쓰는가
어떤 조건일 때 이 스킬을 부른다.

## 절차
1. 첫 단계
2. 다음 단계

## 함정
- 자주 깨지는 부분과 우회법

## 검증
잘 됐는지 어떻게 확인하는가.
로딩은 3단계로 나뉩니다.
| 레벨 | 동작 | 비용 |
|---|---|---|
| 0 | skills_list()로 이름·설명만 가져오기 | 약 3k 토큰 |
| 1 | skill_view(name)으로 본문 전체 읽기 | 가변 |
| 2 | skill_view(name, path)로 특정 파일만 읽기 | 가변 |
처음에는 메타데이터만 훑어보고, 정말 필요할 때만 본문을, 그것도 필요한 파일만 가져갑니다. 스킬이 수십 개·수백 개로 늘어나도 컨텍스트가 통째로 차지 않는 구조입니다.
스킬을 만드는 네 가지 길
/learn 추가로 스킬을 만드는 방법은 네 가지가 됐습니다.
- 직접 작성 —
SKILL.md를 손으로 씁니다. 가장 세밀하게 제어할 수 있습니다. - /learn — 기존 자료를 던지고 에이전트가 쓰게 합니다.
- skill_manage 자동 캡처 — 복잡한 작업을 마친 뒤 절차적 기억으로 저장합니다.
- Skills Hub 설치 — 커뮤니티·벤더가 만든 스킬을 받아 씁니다.
대시보드에는 ‘Learn a skill’ 버튼이 생겼습니다. 디렉터리 경로·URL·자유 텍스트를 입력하는 칸이 같이 붙어 있고, 결과는 skill_manage를 통해 저장됩니다. 쓰기 승인 게이트를 켜 두면, 생성된 스킬을 사람이 한 번 본 다음 통과시킬 수 있습니다.
실제로 어디에 쓰는가
발표에서 든 예시가 직관적입니다.
- 사내 API 온보딩: 비공개 문서 폴더에
/learn을 돌려 두면, 새로 합류한 팀원이 슬래시 명령으로 곧장 호출합니다. 매번 가이드 링크를 찾아 보내는 일이 사라집니다. - 배포 런북: 스테이징 배포를 한 번 에이전트와 같이 진행한 뒤
/learn how I just deployed the staging server라고 말하면, 같은 흐름을 반복 가능한 스킬로 박아 둡니다. - 스킬 번들: 관련된 스킬을 YAML 설정으로 묶어 한 단위로 배포합니다. 팀 단위 표준을 만들기 쉽습니다.
실무자가 볼 핵심 포인트
- 스킬 시스템을 쓰는 팀에 가장 큰 변화는 “사람이 SKILL.md를 안 짜도 된다"는 사실 그 자체입니다. 가장 큰 도입 장벽 하나가 빠진 셈입니다.
- 별도 인제스션 엔진이 없다는 점은 운영 입장에서 좋은 신호입니다. 새 서비스·새 큐·새 의존성이 안 늘어납니다. 기존 에이전트 턴 한 번이면 끝납니다.
- 3단 로딩 모델은 회사 자체 에이전트에도 그대로 가져갈 만합니다. 스킬·문서·예제를 통째로 컨텍스트에 밀어 넣는 대신, “이름 → 본문 → 파일” 순으로 게으르게 로딩하는 패턴은 토큰 비용을 빠르게 줄여 줍니다.
- 승인 게이트는 잊지 말고 켜 두는 게 안전합니다. 외부 URL이나 떠도는 문서를 자동으로 흡수해 스킬로 박는 구조에는 늘 오염 위험이 따라옵니다. 사람이 한 번 보는 단계가 들어가는 게 좋습니다.
- 점진적 공개 자체는 누스 리서치 고유 아이디어는 아닙니다. 하지만 자기개선 에이전트가 자기 스킬을 직접 추가하는 흐름을 표준 명령 한 줄로 만든 점이 새롭습니다. 이게 굳어지면, 팀마다 따로 짜던 “AI 사용 가이드 문서"가 차차 실행 가능한 스킬 파일로 갈아 끼워질 가능성이 높습니다.