NVIDIA가 Hugging Face를 통해 공개한 Nemotron-Labs Diffusion은 “LLM은 꼭 한 토큰씩 생성해야 하는가?”라는 질문에서 출발한다. 핵심은 기존 자동회귀 방식의 안정성은 유지하면서도, 디퓨전 방식의 병렬 생성과 반복 정제를 실무 추론에 가져오는 것이다.
목차
핵심 요약
- 기존 자동회귀 LLM은 토큰을 왼쪽에서 오른쪽으로 하나씩 생성하기 때문에 GPU 메모리 대역폭 병목에 걸리기 쉽다.
- Nemotron-Labs Diffusion은 여러 토큰을 블록 단위로 만들고, 여러 단계에 걸쳐 정제하는 Diffusion Language Model 접근을 제시한다.
- 한 모델에서 자동회귀, 디퓨전, self-speculation 세 가지 생성 모드를 지원한다.
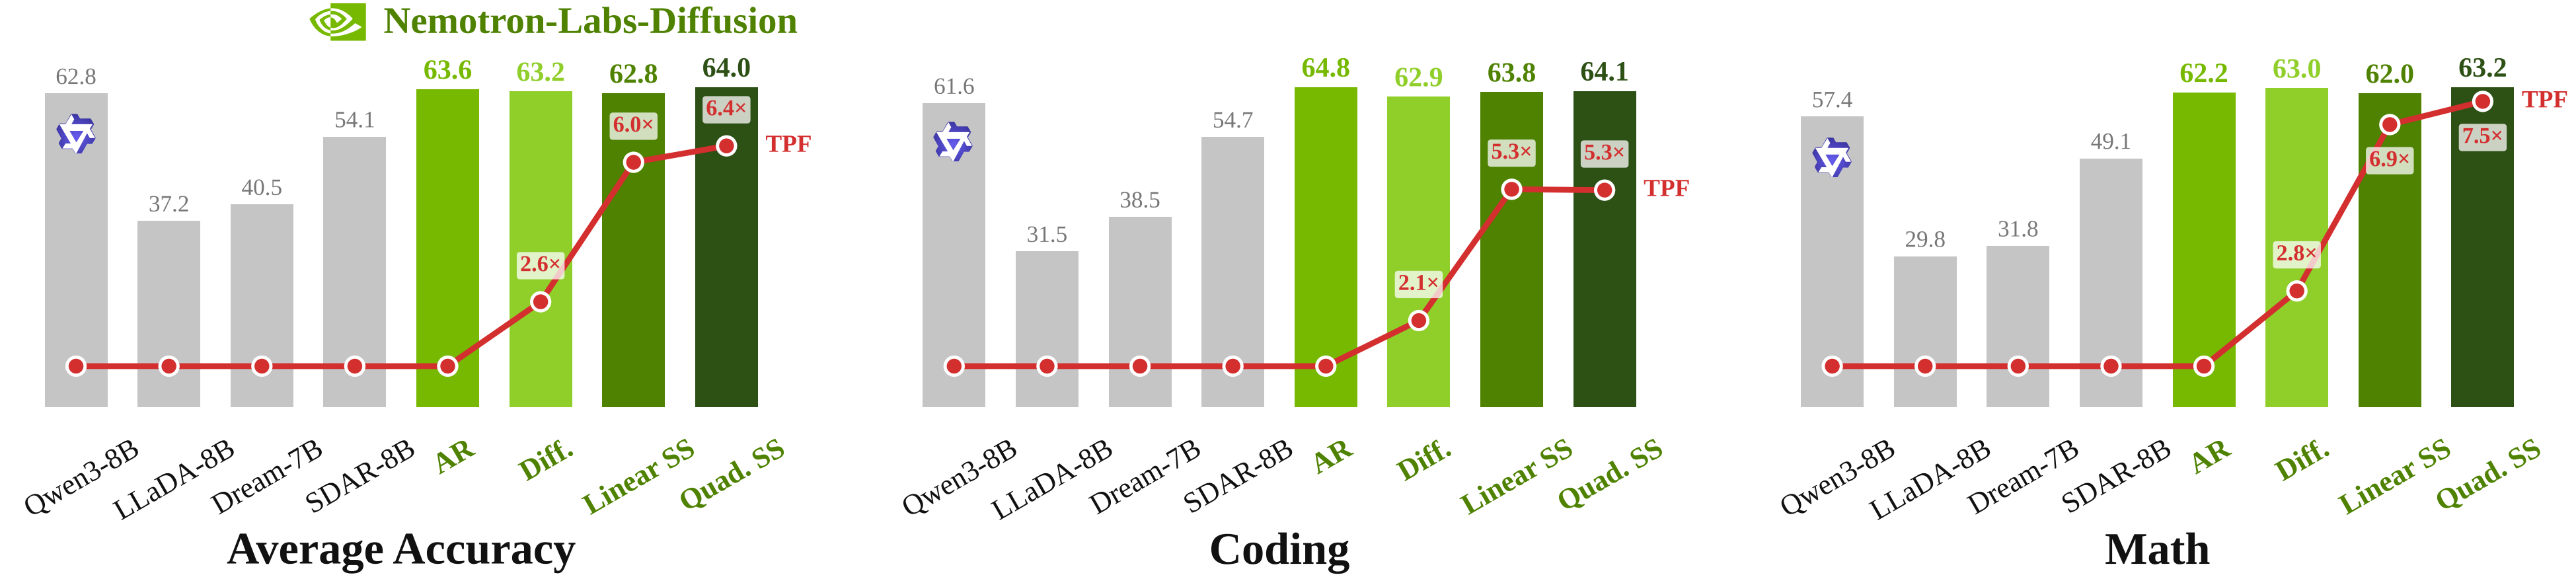
- 원문 기준 8B 모델은 Qwen3 8B 대비 평균 정확도 1.2% 개선, TPF 기준 디퓨전 2.6배, self-speculation 6~6.4배 효율을 보였다.
왜 자동회귀 방식이 병목이 되는가
현재 대부분의 LLM, 즉 LLMs는 자동회귀(Autoregressive, AR) 방식으로 동작한다. 앞에서 생성한 토큰을 다시 입력으로 삼고, 다음 토큰을 하나씩 예측한다. 이 구조는 학습과 서빙이 단순하고 안정적이라는 장점이 있다. 그래서 지금의 코드 생성, 요약, 문서 이해, 수학 풀이 모델 대부분이 이 방식 위에서 성장했다.
문제는 속도다. 토큰 하나를 만들 때마다 모델을 한 번 통과해야 하고, 계산이 시작되기 전 가중치와 KV 캐시를 메모리에서 계속 불러와야 한다. 작은 배치나 실시간 응답처럼 지연 시간이 중요한 환경에서는 GPU, 더 정확히는 여러 GPUs가 계산보다 메모리 이동에 더 많은 시간을 쓰는 상황이 생긴다. 또 한 번 생성된 토큰은 기본적으로 되돌려 고치기 어렵기 때문에, 앞부분의 실수가 뒤 문장까지 이어질 수 있다.
Nemotron-Labs Diffusion이 다른 점
Nemotron-Labs Diffusion은 이 한계를 줄이기 위해 디퓨전 언어 모델(Diffusion Language Model, DLM)을 도입한다. 이미지 디퓨전처럼 완성 결과를 한 번에 내놓는다는 뜻은 아니다. 텍스트 영역에서는 여러 토큰 위치를 병렬로 예측하고, 그 결과를 여러 단계에 걸쳐 점진적으로 정제하는 방식에 가깝다.
흥미로운 점은 NVIDIA가 자동회귀와 디퓨전을 완전히 다른 모델군으로 나누지 않았다는 것이다. 같은 체크포인트에서 세 가지 모드를 선택할 수 있다. 첫째, 일반 LLM처럼 왼쪽에서 오른쪽으로 생성하는 자동회귀 모드. 둘째, 블록 단위로 토큰을 만들고 정제하는 디퓨전 모드. 셋째, 디퓨전이 후보 토큰을 먼저 초안으로 만들고 자동회귀 디코딩이 이를 검증하는 self-speculation 모드다.
이 구조는 개발자 입장에서 의미가 크다. 애플리케이션 코드를 크게 바꾸지 않고도 배포 설정에서 생성 방식을 선택할 수 있기 때문이다. 속도가 중요한 요청에는 디퓨전 계열 모드를, 정확도 기준점이 필요한 상황에는 자동회귀 모드를 두는 식의 운영이 가능해진다.
성능 수치는 어떻게 봐야 하나
원문에서 강조한 지표는 tokens per forward pass, 즉 TPF다. 실제 서비스에서 보는 초당 토큰 수와 완전히 같은 지표는 아니지만, 모델이 한 번의 forward pass에서 얼마나 효율적으로 토큰을 처리하는지 보여준다. NVIDIA에 따르면 Nemotron-Labs Diffusion 8B는 Qwen3 8B 대비 평균 정확도가 1.2% 높았고, 디퓨전 모드에서는 AR 모델보다 2.6배 높은 TPF를 기록했다. self-speculation에서는 선형 방식 6배, quadratic 방식 6.4배까지 올라갔다.
SGLang 배포도 준비 중이다. FastDiffuser는 32토큰 블록을 채우며 신뢰도 기준에 따라 충분히 좋은 토큰을 확정하고, LinearSpec은 디퓨전으로 양방향 초안을 만든 뒤 인과적 검증을 거친다. 원문은 B200 기준 speedbench 데이터셋에서 약 865 tok/s, 자동회귀 대비 약 4배 수치를 제시했다. 다만 이는 특정 하드웨어와 벤치마크 조건의 결과이므로 “항상 6배 빠르다”처럼 읽으면 안 된다.
모델과 학습 방식
모델 라인업은 3B, 8B, 14B 텍스트 모델과 8B 비전-언어 모델로 구성된다. 텍스트 모델은 NVIDIA Nemotron Open Model License, 8B VLM은 NVIDIA Source Code License로 공개되어 라이선스 조건이 서로 다르다. base 모델과 instruction-tuned chat 변형도 함께 제공된다.
학습 방식은 Efficient-DLM 흐름을 따른다. 기존 자동회귀 모델의 능력을 버리지 않고, block-wise attention과 joint AR + diffusion objective를 통해 디퓨전 생성 능력을 추가한다. 원문 기준 사전학습에는 NVIDIA Nemotron Pretraining datasets의 1.3T 토큰, 추가 SFT에는 Nemotron Post-training datasets의 45B 토큰이 사용됐다.
실무자가 볼 핵심 포인트
실무 관점에서 Nemotron-Labs Diffusion은 “자동회귀를 대체할 모델”이라기보다 “생성 모드를 선택할 수 있는 모델”에 가깝다. 특히 배치 크기가 작거나 1인 요청이 많은 서비스, 코드 생성처럼 응답 지연이 체감되는 워크플로우, GPU 메모리 병목이 큰 환경에서 검토할 만하다.
또 하나의 장점은 추론 예산을 조절하기 쉽다는 점이다. 디퓨전은 정제 단계를 줄이면 계산량을 낮출 수 있고, 더 많은 단계를 쓰면 품질 쪽으로 기울일 수 있다. 문장 일부를 고치거나 중간을 채우는 fill-in-the-middle 작업에서도 “생성 후 수정”이 가능한 구조가 자연스럽다.
물론 아직은 SGLang 지원 상태, 실제 서비스 지연 시간, 비용 대비 효과를 직접 확인해야 한다. SGLang 통합도 원문 기준으로는 메인 브랜치 지원 예정과 PR 기반 지원에 가깝다. 따라서 바로 운영 환경에 넣기보다는, 동일 프롬프트와 동일 하드웨어에서 AR 모드와 diffusion 모드, self-speculation 모드를 나란히 비교하는 검증이 먼저다. 특히 TPF가 높다고 해서 모든 서비스의 체감 지연 시간이 같은 비율로 줄어드는 것은 아니므로, 프리필 시간, 디코딩 시간, 동시 요청 수, 출력 길이를 함께 봐야 한다.
그럼에도 Nemotron-Labs Diffusion은 LLM 추론 속도를 올리는 방법이 단순히 더 작은 모델이나 더 강한 GPU만은 아니라는 점을 잘 보여준다. 모델이 토큰을 생성하는 방식 자체를 바꾸면, 같은 규모의 모델에서도 다른 성능 곡선을 만들 수 있다. 앞으로 LLM 서빙 최적화는 모델 크기, 양자화, 캐싱뿐 아니라 “어떤 생성 모드를 선택할 것인가”까지 포함하는 방향으로 넓어질 가능성이 크다.
원문: Towards Speed-of-Light Text Generation with Nemotron-Labs Diffusion Language Models