출처: Hugging Face YouTube
문서유형: 영상 해설
#AutoResearch #MultiAgent #OpenSourceModels #OpenCode
핵심 요약
Hugging Face의 영상 **“Multi-Agent AutoResearch with Open Source Models”**는 Andrej Karpathy의 AutoResearch 아이디어를 오픈소스 모델과 오픈소스 코드 하네스인 OpenCode로 재구성한 실험을 보여줍니다.
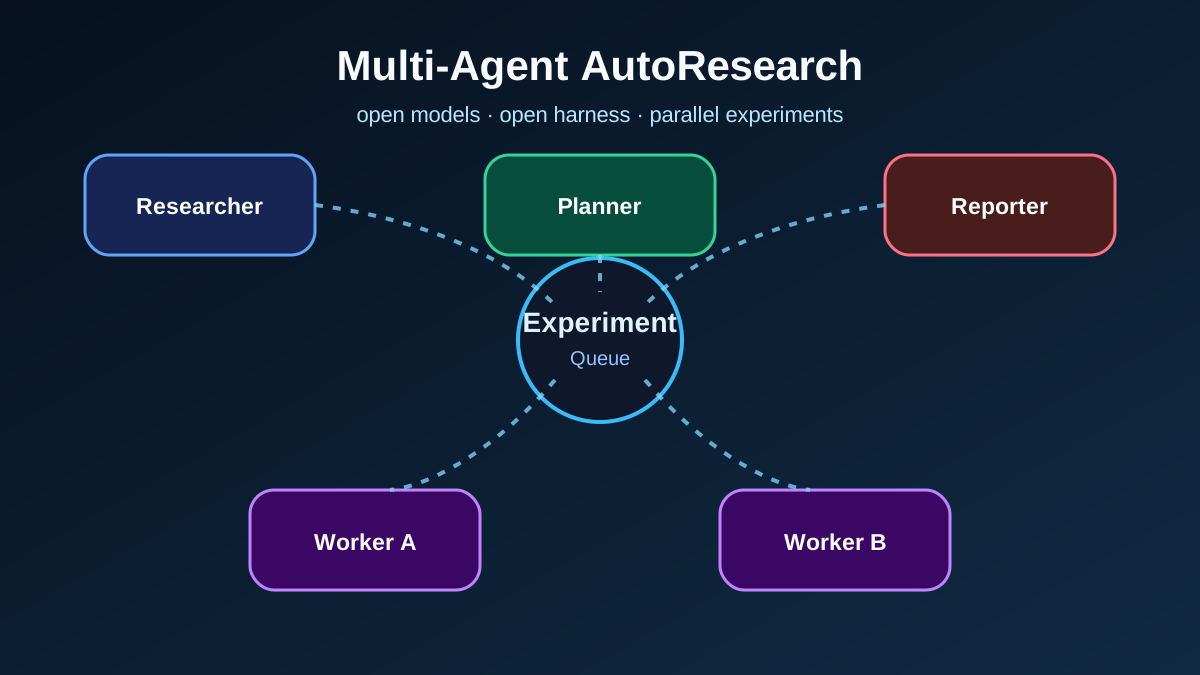
핵심은 단일 에이전트에게 모든 일을 맡기지 않는 것입니다. 논문을 찾는 에이전트, 실험 계획을 관리하는 에이전트, 훈련 스크립트를 수정하고 실행하는 워커 에이전트, 결과를 모아 보고하는 리포터 에이전트를 나눕니다. 이렇게 역할을 쪼개면 더 작은 모델도 장기 실험을 수행할 가능성이 커집니다.

기: Karpathy의 AutoResearch가 던진 질문
AutoResearch는 LLM 훈련 코드를 AI 에이전트가 조금씩 수정하며 성능을 개선하는 실험입니다. Karpathy의 원래 실험에서는 코드 에이전트가 nanoGPT류 훈련 스크립트를 수정하고, 수백 번의 실험을 반복하면서 bits per byte 같은 지표를 낮추는 방향으로 개선을 시도합니다.
흥미로운 점은 에이전트가 실제로 훈련 효율을 개선했다는 것입니다. 하지만 영상의 발표자는 한 가지 문제를 봅니다. 원래 구조에서는 같은 에이전트가 논문 탐색, 가설 수립, 코드 수정, 실험 실행, 결과 해석까지 모두 담당합니다.
사람 연구팀이라면 이렇게 하지 않습니다. 연구자, 실험 설계자, 엔지니어, 리포터의 역할이 나뉩니다. 그렇다면 AI 에이전트도 역할을 나누면 더 안정적이지 않을까요?
승: 역할을 나누면 오픈소스 모델도 가능성이 생긴다
영상의 실험은 이 질문에서 출발합니다. 발표자는 OpenCode 하네스 안에서 AutoResearch를 멀티 에이전트 구조로 구현합니다.
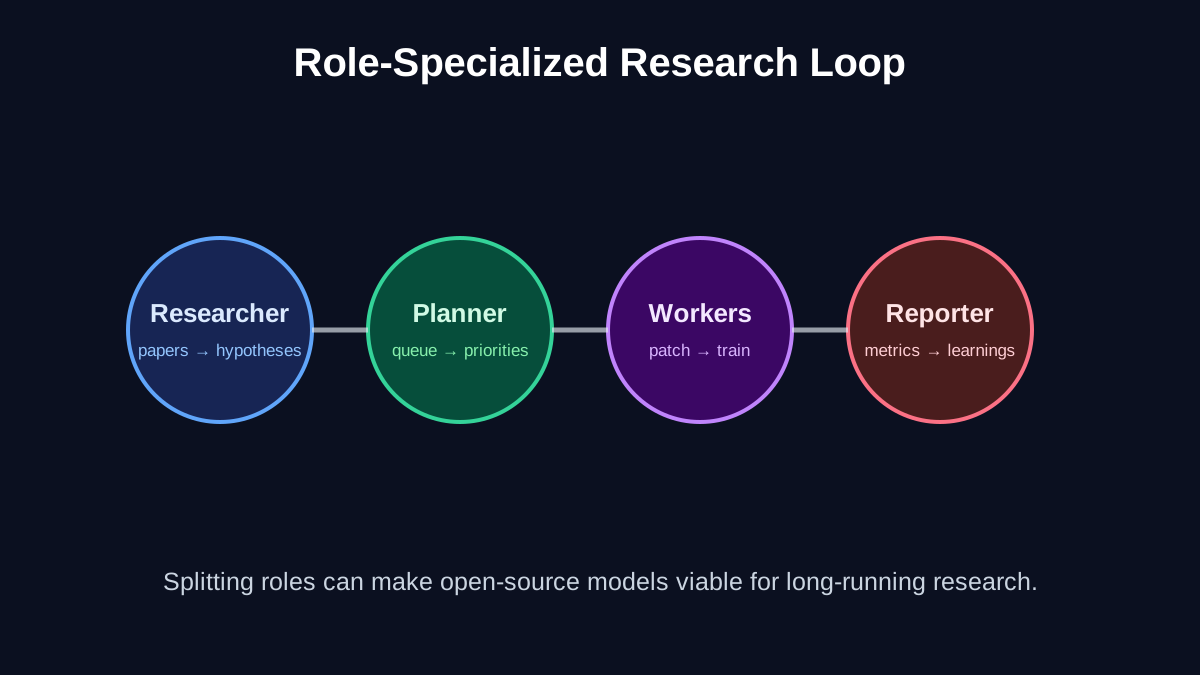
구성은 다음과 같습니다.
- Researcher: Hugging Face Papers를 찾아보고, 논문에서 실험 아이디어와 개선 가설을 뽑습니다.
- Planner: 실험 큐를 관리합니다. 학습률 변경, 옵티마이저 변경, 스케줄러 수정 같은 후보를 정리합니다.
- Workers: 큐에서 가설을 가져와 훈련 스크립트를 패치하고 실행합니다.
- Reporter: 각 실험 결과를 수집하고, 성공·실패·다음 우선순위를 보고합니다.
이 구조의 장점은 명확합니다. 에이전트 하나가 모든 맥락을 다 들고 있을 필요가 없습니다. 각 에이전트가 자기 역할에 맞는 작은 지시와 산출물 포맷을 따릅니다. 긴 작업을 작은 루프 여러 개로 쪼개는 셈입니다.
전: 장기 실행에는 하네스와 관측 가능성이 필요하다
오픈소스 모델을 쓸 때 특히 문제가 되는 부분은 장기 실행 능력입니다. 발표자는 많은 오픈소스 모델이 중간에 멈추려는 경향이 있어, “성공적인 전체 패스가 끝날 때까지 멈추지 말라”는 식의 더 강한 지시가 필요했다고 설명합니다.
여기서 중요한 것은 모델 자체보다 하네스입니다. OpenCode는 에이전트 전환, 역할별 프롬프트, 작업 추적을 제공하고, Hugging Face Hub의 shared cache는 여러 실험이 자산을 반복 업로드·다운로드하지 않도록 도와줍니다.
또 하나 중요한 도구가 Tracelo입니다. 여러 에이전트가 동시에 실험을 돌리면 터미널 로그만으로는 전체 상황을 보기 어렵습니다. 그래서 active jobs, anomaly counts, best delta versus master 같은 지표를 대시보드로 봅니다.
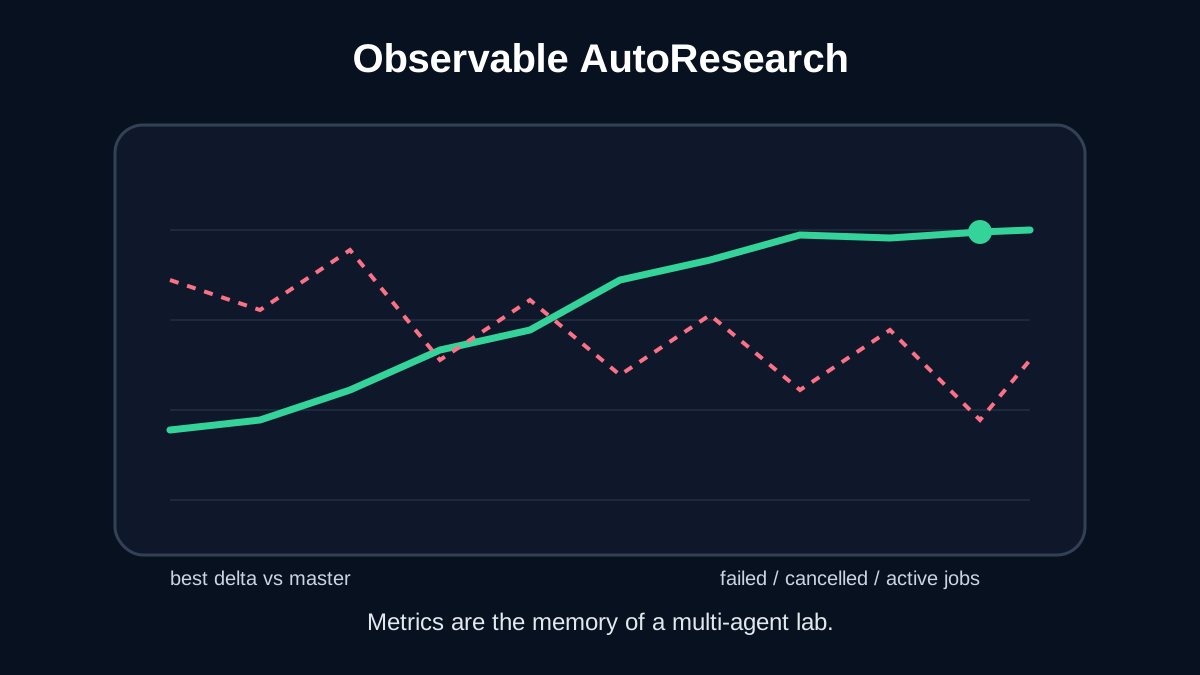
멀티 에이전트 실험실에서는 관측 가능성이 곧 기억입니다. 어떤 실험이 실패했고, 어떤 가설이 개선을 만들었으며, 언제 성능이 더 이상 좋아지지 않았는지를 시스템이 기억해야 다음 루프가 의미를 갖습니다.
결: 오픈소스 에이전트 연구의 핵심은 “작게 나누고, 측정하고, 계속 돌리는 것”
이 영상의 메시지는 단순히 “오픈소스 모델로도 된다”가 아닙니다. 더 정확히는, 오픈소스 모델이 강한 단일 에이전트처럼 행동하지 못하더라도 역할 분리, 명시적 큐, 공유 캐시, 지표 추적을 붙이면 긴 연구 루프에 참여할 수 있다는 것입니다.
즉 에이전트 성능은 모델 하나의 지능만으로 결정되지 않습니다. 어떤 하네스 안에서, 어떤 역할을 맡고, 어떤 결과 형식으로 일하며, 어떤 지표로 피드백을 받는지가 중요합니다.
핵심 인사이트
1. 단일 만능 에이전트보다 역할 분리가 강하다
Researcher, Planner, Worker, Reporter를 나누면 각 에이전트의 부담이 줄어듭니다. 특히 오픈소스 모델처럼 장기 맥락 유지가 약한 모델에는 역할 분리가 더 중요합니다.
2. 실험 큐는 멀티 에이전트 연구의 중심이다
가설을 큐로 관리하면 에이전트가 즉흥적으로 움직이지 않습니다. 어떤 실험을 시도했고, 무엇이 실패했으며, 다음에 무엇을 해야 하는지 추적할 수 있습니다.
3. 오픈소스 모델은 더 많은 하네스가 필요하다
강한 폐쇄형 모델은 모호한 지시도 어느 정도 버티지만, 오픈소스 모델은 멈추지 말라는 지시, 산출물 포맷, 실패 처리, 검토 루프를 더 명확히 줘야 합니다.
4. 관측 가능성 없이는 멀티 에이전트가 금방 혼란스러워진다
여러 워커가 동시에 실험하면 로그는 빠르게 복잡해집니다. Tracelo 같은 지표 대시보드가 있어야 실험이 실제로 개선되고 있는지 알 수 있습니다.
5. AutoResearch는 연구 자동화보다 연구 운영체제에 가깝다
중요한 것은 AI가 논문을 읽고 코드를 고치는 장면만이 아닙니다. 연구 아이디어, 실행, 실패, 지표, 보고가 하나의 루프로 연결되는 구조가 핵심입니다.
실무적으로 볼 포인트
이 구조는 LLM 연구에만 적용되는 것이 아닙니다. 블로그 제작, 코드 리팩토링, 리서치 자동화, 데이터 분석에도 같은 패턴을 쓸 수 있습니다.
- Researcher: 자료 수집과 가설 제안
- Planner: 작업 큐와 우선순위 관리
- Worker: 실행과 산출물 생성
- Reviewer/Reporter: 검증과 보고
결국 좋은 에이전트 시스템은 “똑똑한 모델 하나”가 아니라, 각 역할이 잘 연결된 작은 조직에 가깝습니다.
마무리
Karpathy의 AutoResearch가 “에이전트가 연구를 반복하며 개선할 수 있다”는 가능성을 보여줬다면, Hugging Face의 이 실험은 그 가능성을 오픈소스 모델과 멀티 에이전트 하네스로 확장합니다.
앞으로의 질문은 단순합니다.
“가장 강한 모델 하나를 쓸 것인가, 아니면 충분히 좋은 모델들을 역할별로 나눠 연구 조직처럼 운영할 것인가?”
오픈소스 모델이 더 좋아질수록 후자의 가능성은 더 커질 것입니다. 그리고 그때 중요한 경쟁력은 모델 선택보다 하네스 설계와 실험 운영 능력이 될 가능성이 높습니다.